
Ngữ cảnh tốt: nền tảng cho AI rẻ hơn và thông minh hơn
Tối ưu hóa ngữ cảnh AI là việc thiết kế, tổ chức và kiểm soát thông tin mà mô hình được phép đọc để trả lời, nhằm đạt hiệu suất AI cao hơn, giảm chi phí inference và vẫn giữ hoặc nâng chất lượng output trong các quy trình làm việc thực tế của đội ngũ.
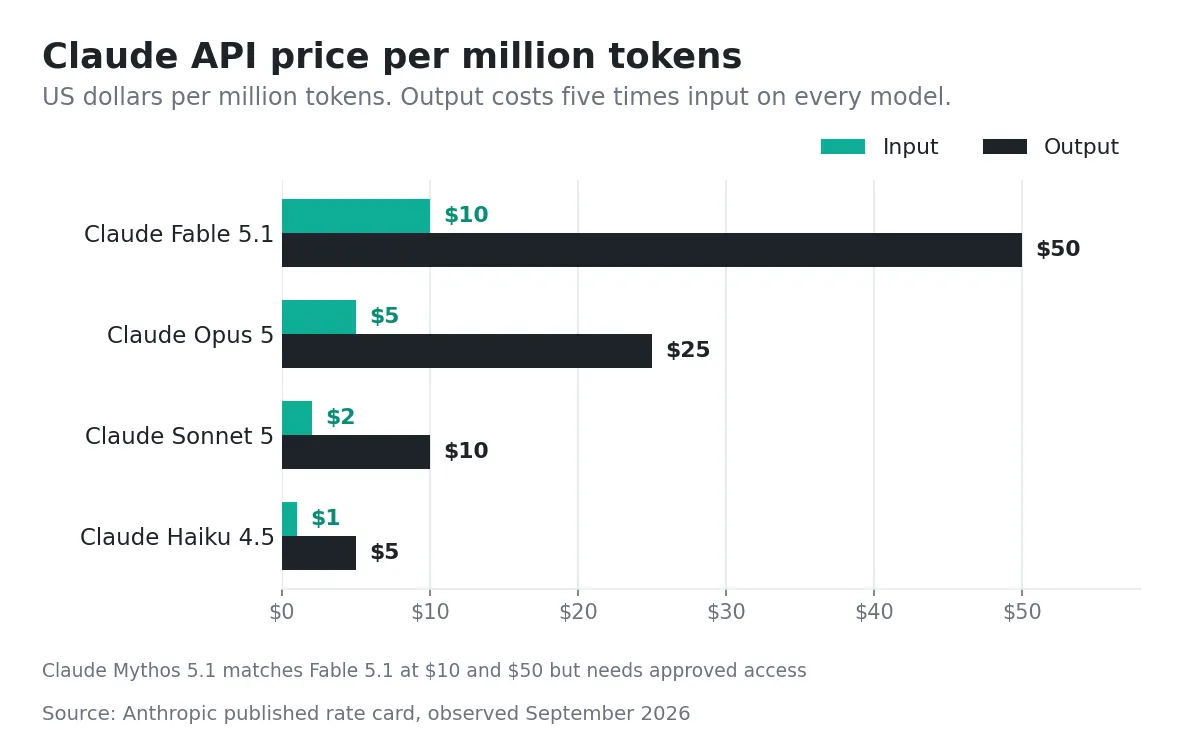
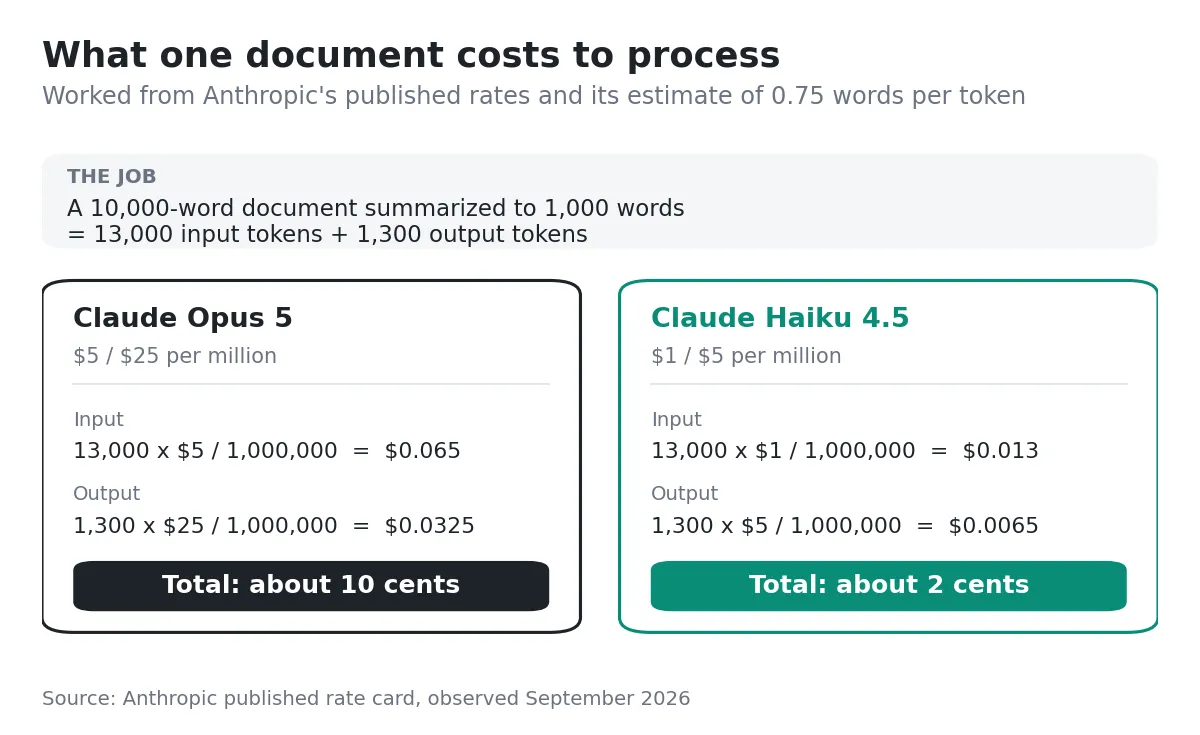
Nếu bạn đang than phiền hóa đơn AI tăng mà chất lượng câu trả lời không khá hơn, nhiều khả năng vấn đề nằm ở ngữ cảnh, không phải mô hình. Mỗi câu trả lời đều dựa trên một “gói ngữ cảnh”; gói này càng đúng và gọn thì mô hình càng dùng ít token, trả lời nhanh và chính xác hơn. Ngược lại, nhồi thật nhiều dữ liệu vào context window không đồng nghĩa với kiến trúc tốt: mô hình phải đọc quá nhiều, chi phí inference tăng nhanh hơn tốc độ giảm giá token. Bài này dành cho những đội đã có AI assistant, RAG hay agent nội bộ, muốn bớt “đốt tiền” mà vẫn cải thiện chất lượng.
Ba yếu tố cốt lõi của context engineering: đầy đủ, kết nối, liên quan
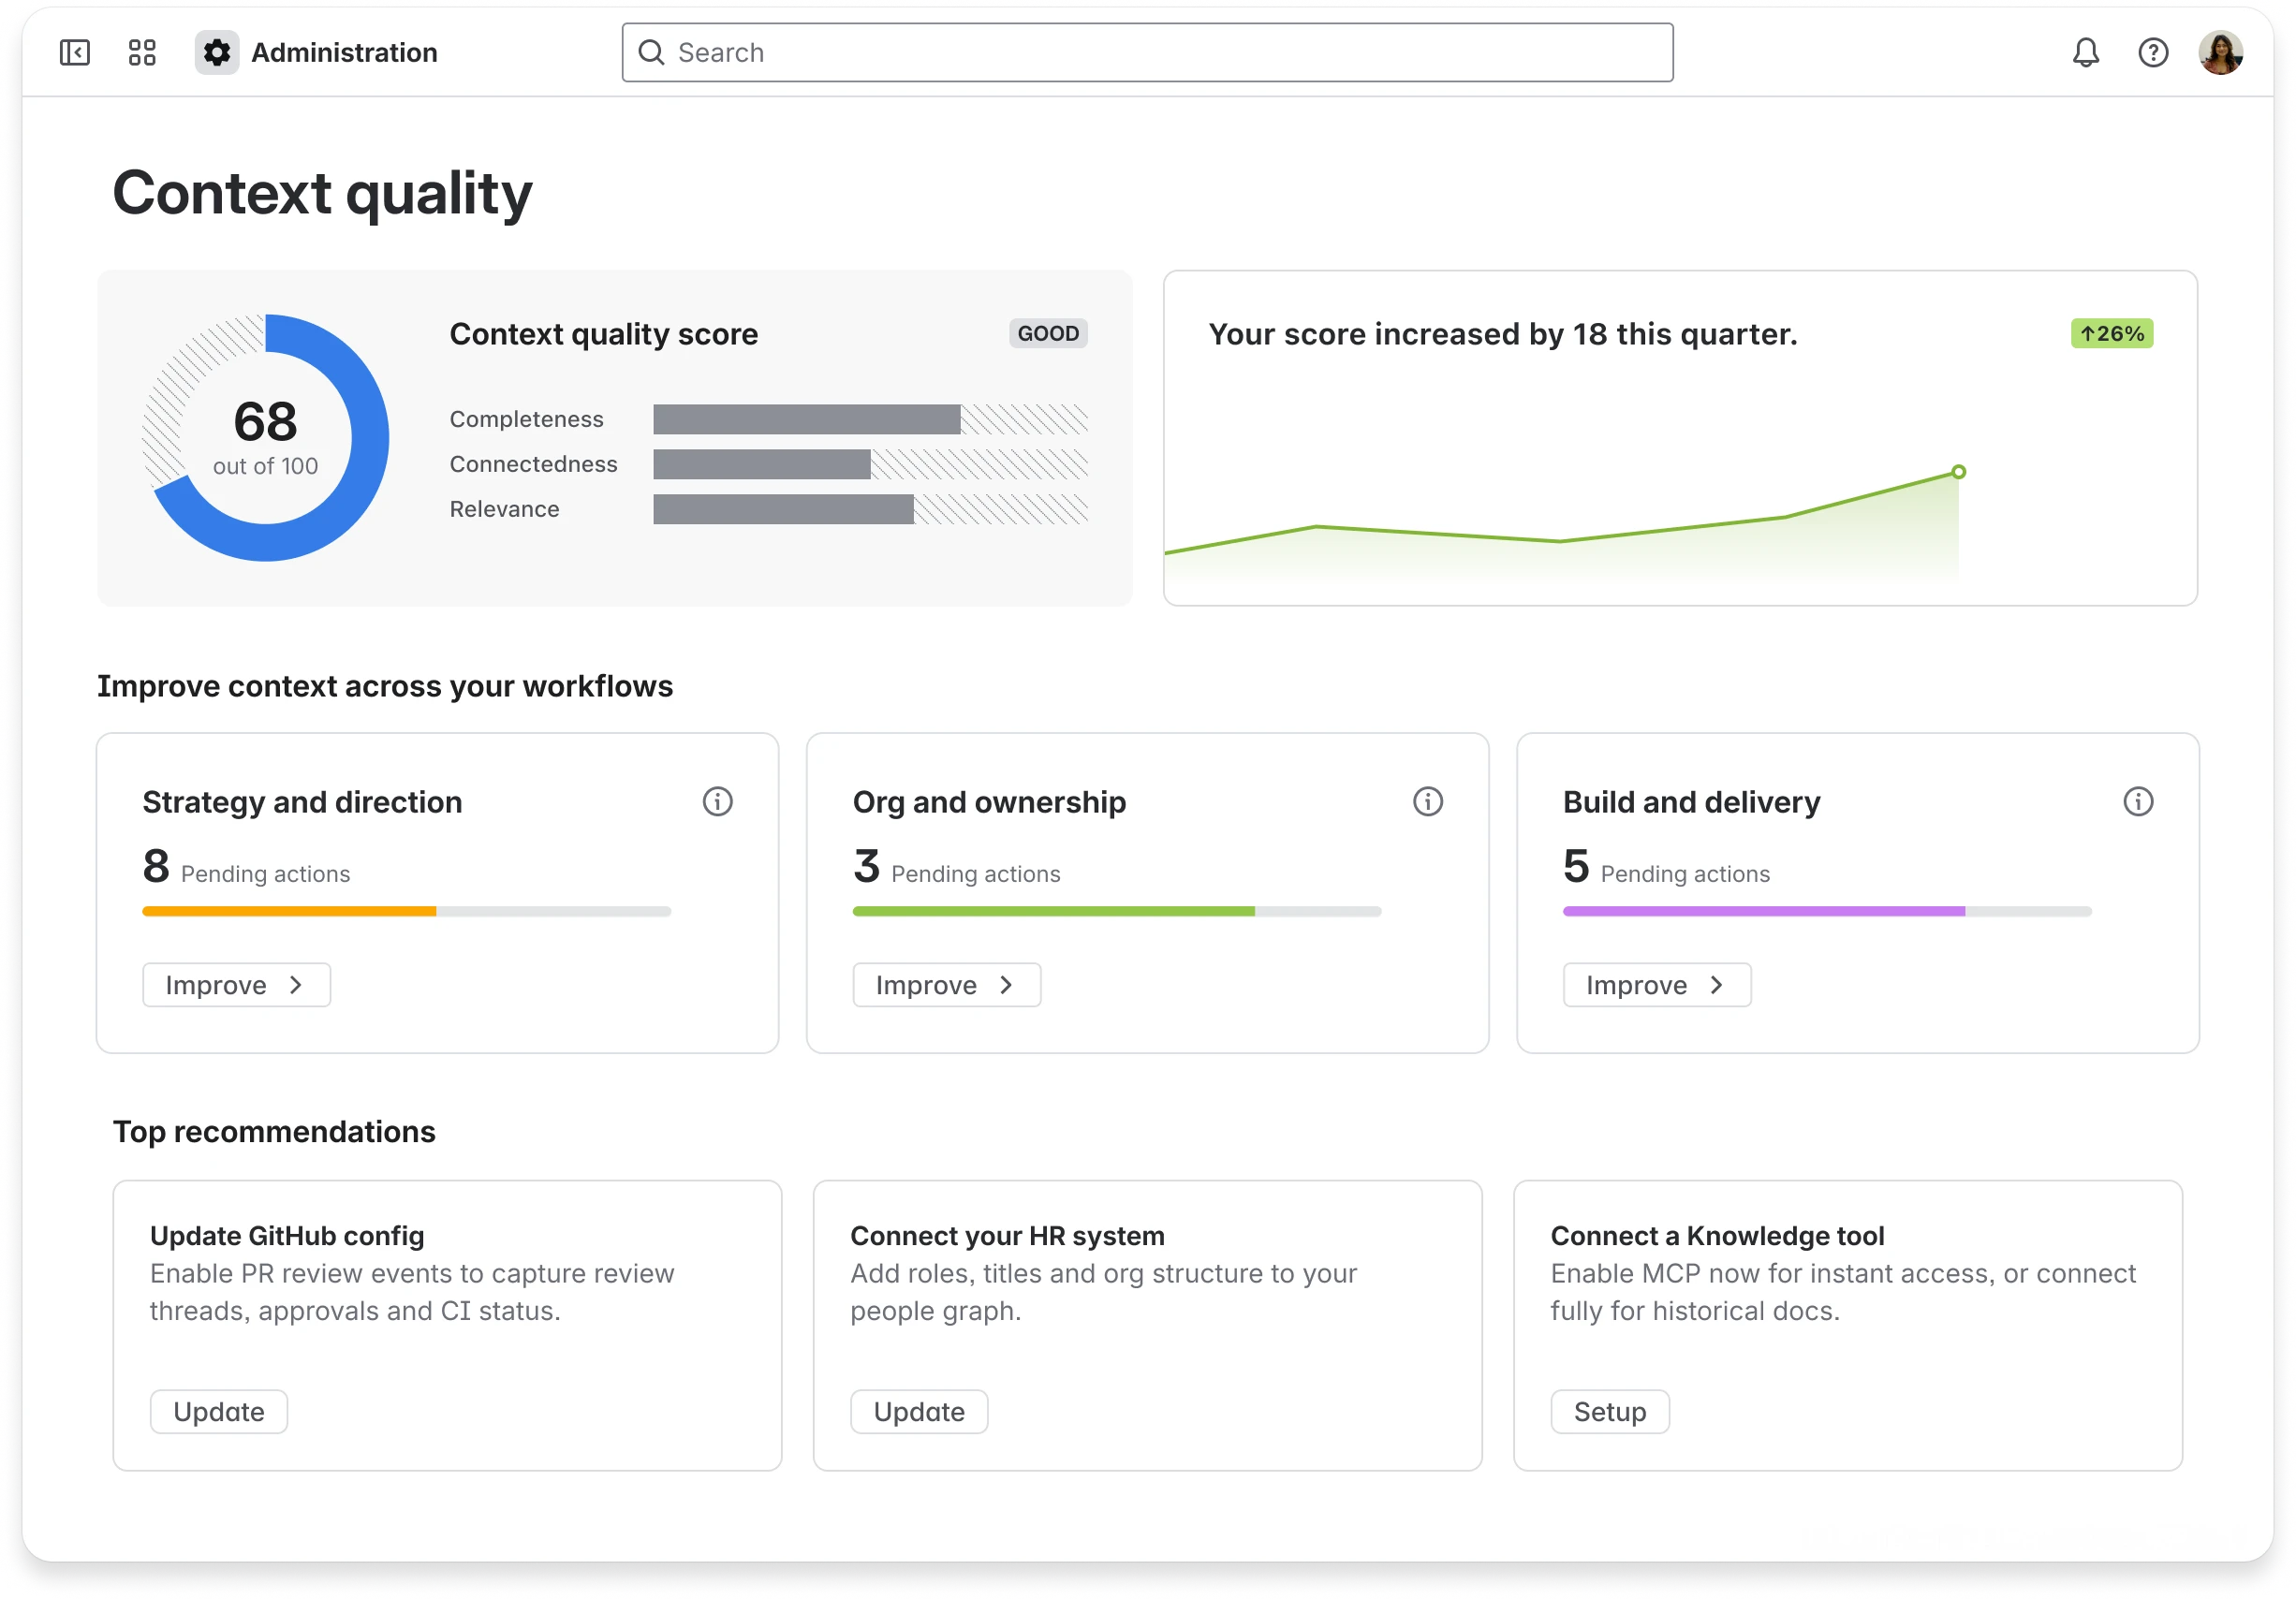
Context engineering là cách bạn chủ động thiết kế ngữ cảnh để AI suy luận hiệu quả hơn, thay vì để mô hình tự bơi trong biển dữ liệu. Từ nghiên cứu nội bộ, người ta đã chưng cất thành ba yếu tố đo lường được của chất lượng ngữ cảnh: độ đầy đủ (completeness), độ kết nối (connectedness) và mức độ liên quan (relevance). Đây chính là “prerequisite” nếu bạn muốn tối ưu hóa ngữ cảnh AI một cách bài bản.
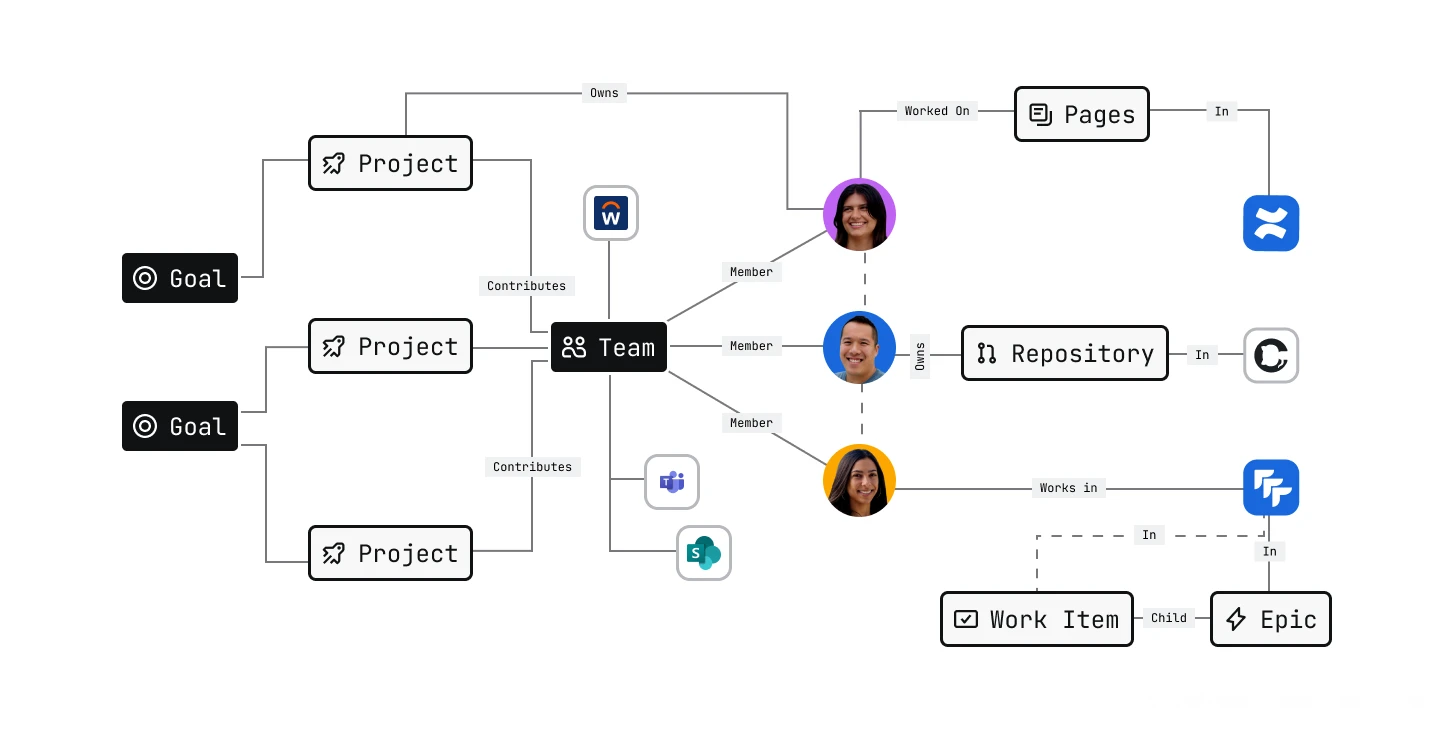
Độ đầy đủ là có đủ nguồn và đủ chiều sâu: không chỉ tiêu đề tài liệu mà cả nội dung, comment, lịch sử chỉnh sửa đều được lập chỉ mục. Độ kết nối là khả năng AI nhìn thấy các mối liên hệ mà đội đã tạo ra: link Figma trong ticket, PR gắn với Slack thread, doc gắn với epic… để ghép thành một gói ngữ cảnh thống nhất. Mức độ liên quan là việc đảm bảo dữ liệu mới, đúng, không nhạy cảm được ưu tiên, còn nội dung cũ, lỗi thời được hạ trọng số hoặc lưu trữ. Ba yếu tố này là khung xương cho mọi quyết định context engineering.
Quy trình 4 bước: tối ưu hóa ngữ cảnh AI trong đội của bạn
Đây là phần “how-to” thực tế: làm sao để biến lý thuyết context engineering thành thói quen hàng ngày. Hãy coi ngữ cảnh như một sản phẩm nội bộ: bạn cải tiến dần, đo lường, rồi lại cải tiến. Một lưu ý quan trọng: mô hình suy luận không cần đọc mọi điểm dữ liệu để trả lời câu hỏi; nó cần một gói ngữ cảnh được chọn lọc tốt. Vì vậy, mục tiêu của bạn là giúp AI đọc ít hơn nhưng hiểu đúng hơn.
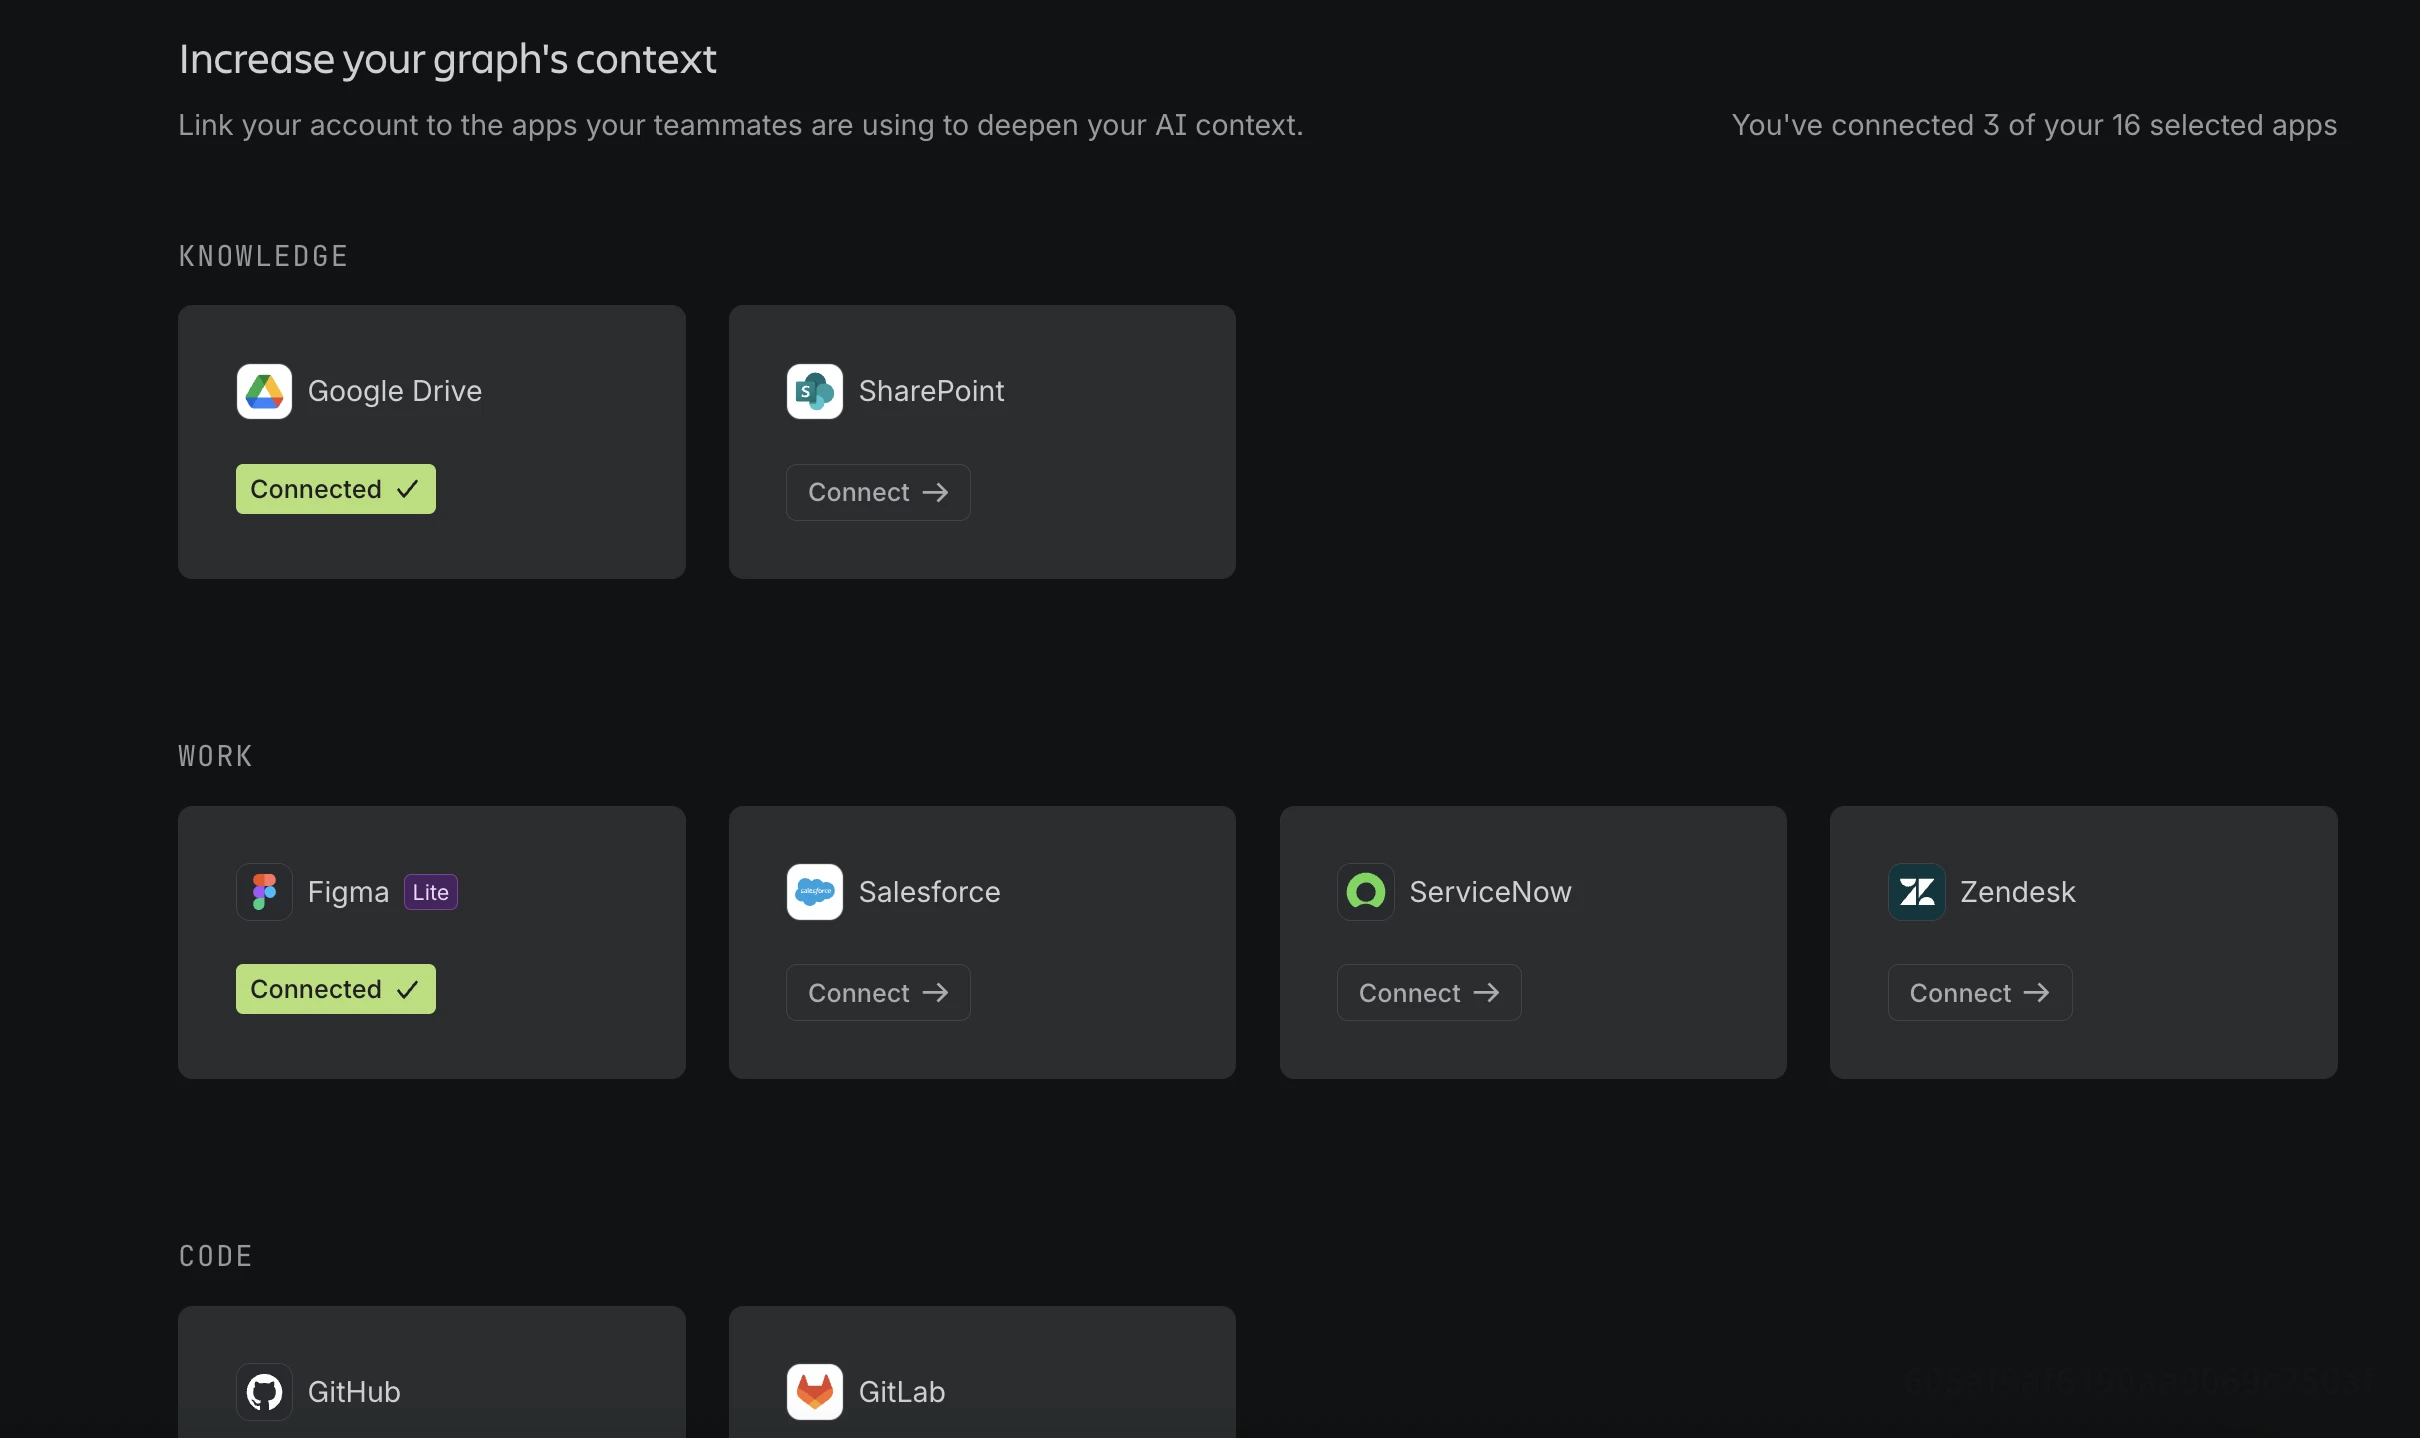
- Chẩn đoán điểm yếu ngữ cảnh: rà soát từng loại dữ liệu (code, tài liệu, ticket, chat) xem thiếu ở đâu: có thể code rất chi tiết nhưng ít liên kết, hoặc trao đổi Slack phong phú nhưng tách rời công việc chính.
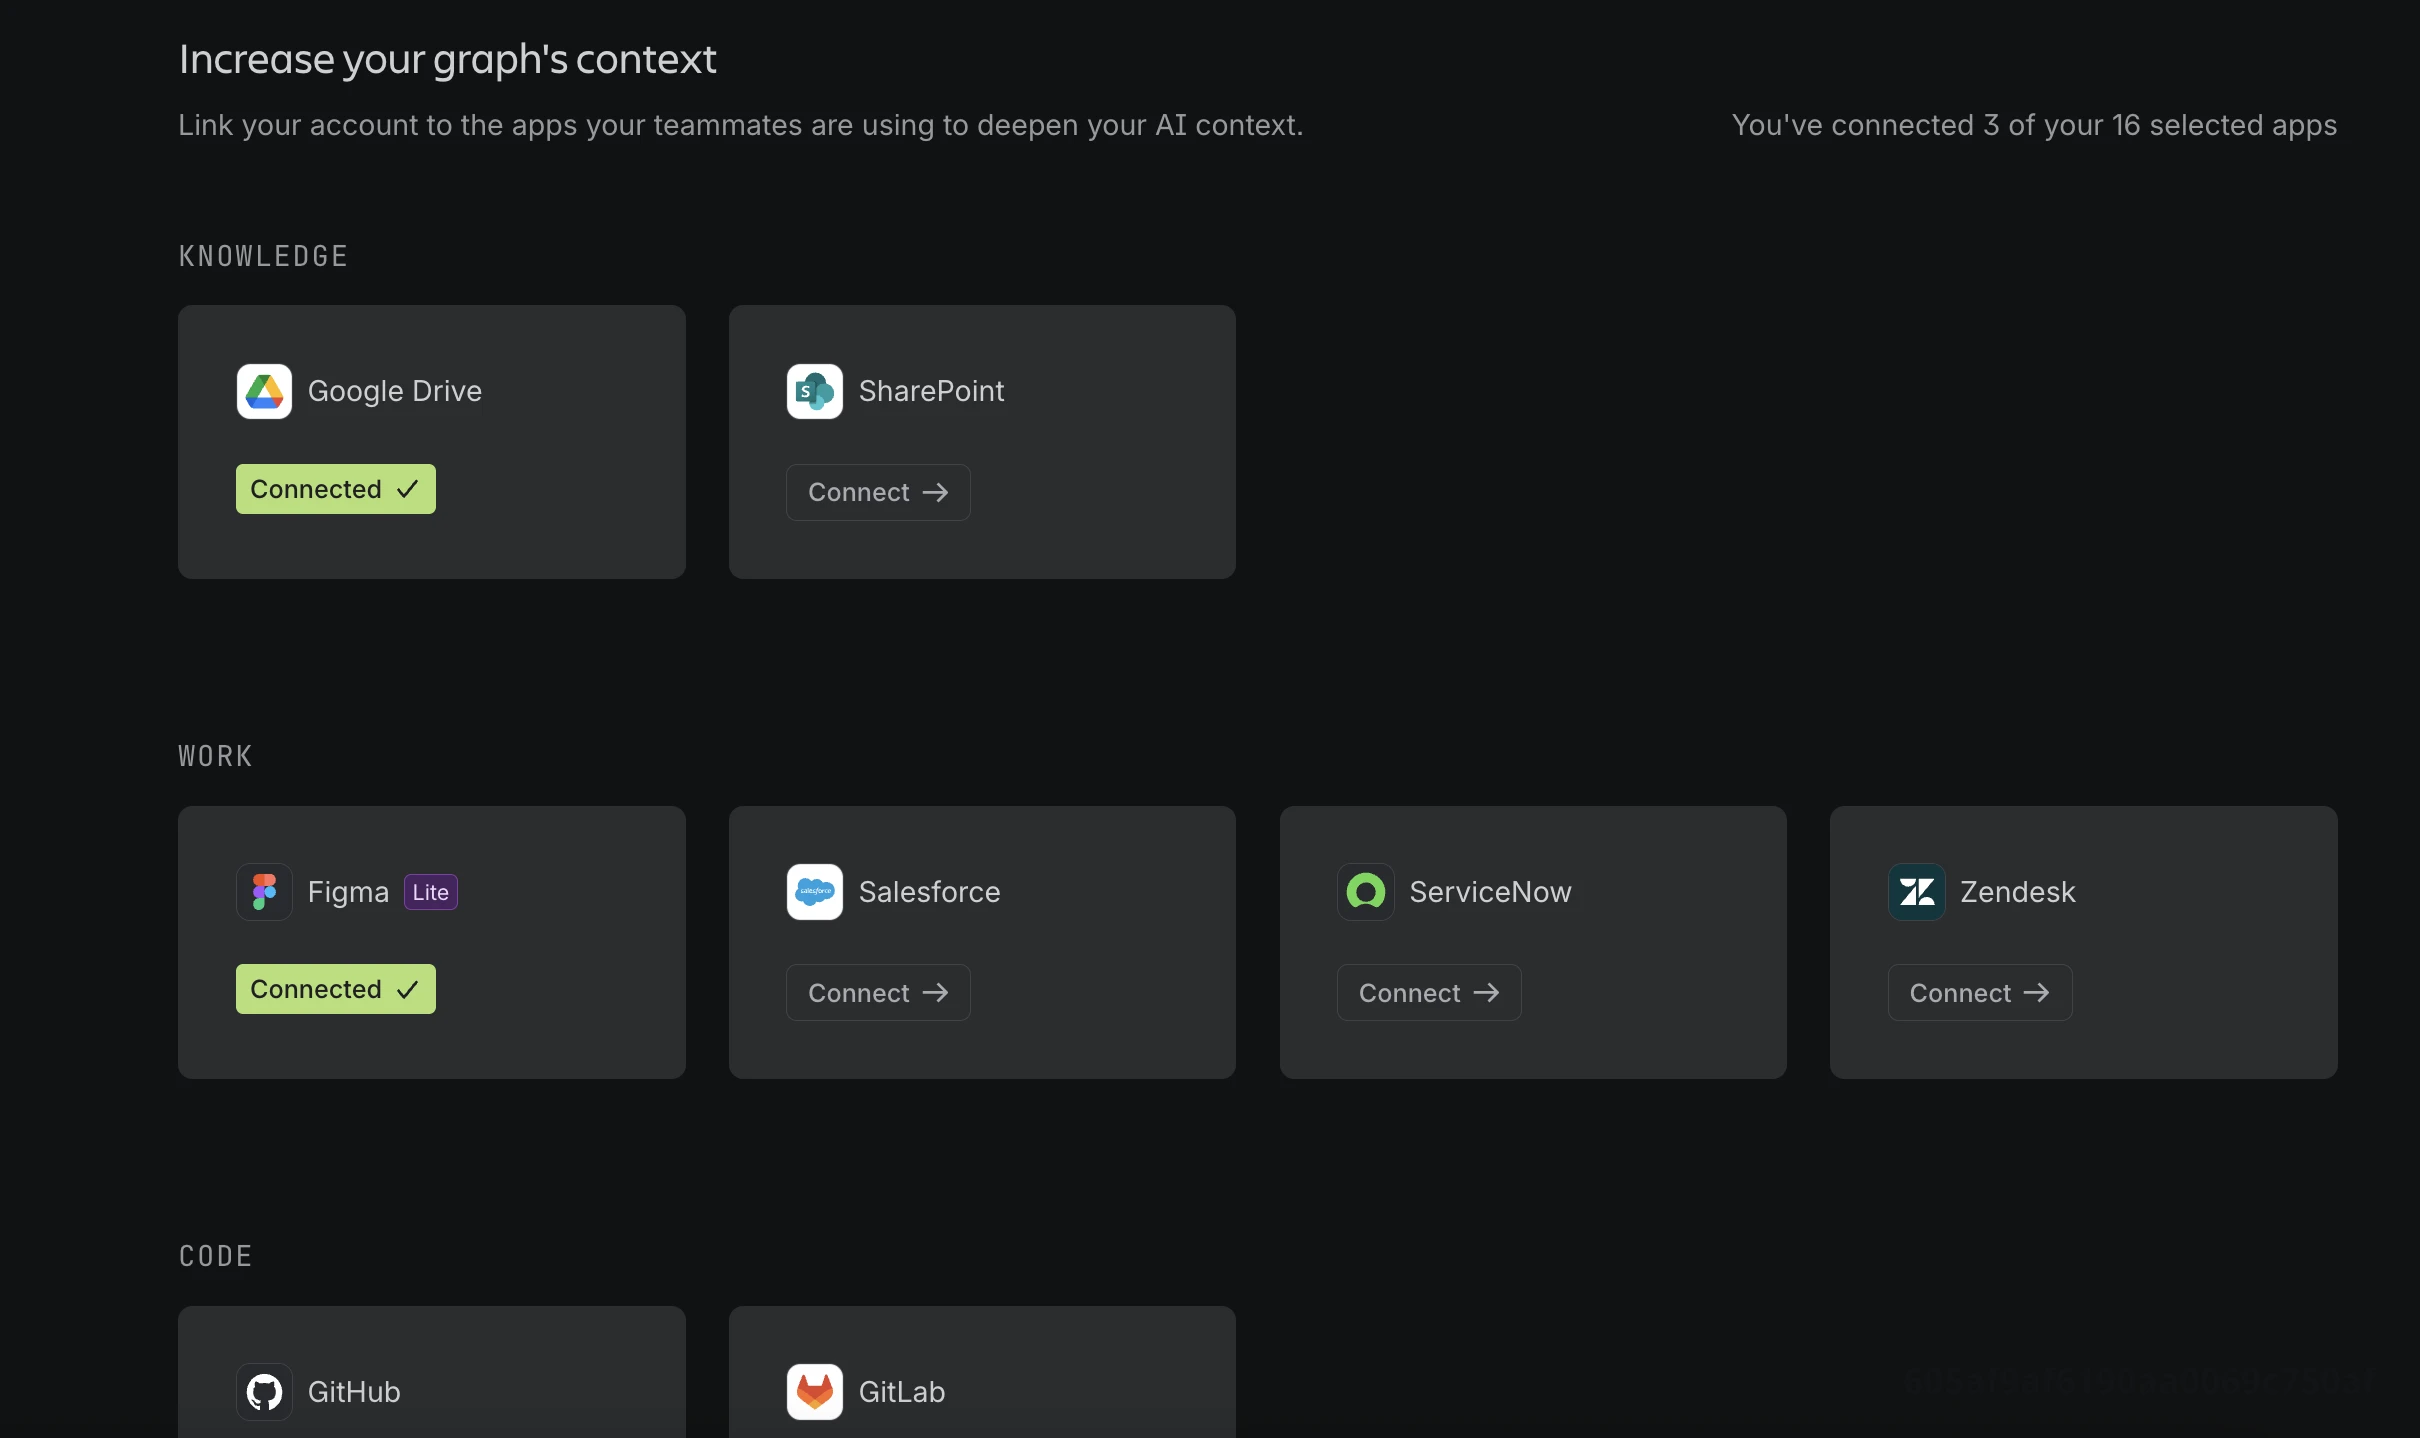
- Hành động nhỏ, tác động rõ: chọn một việc cụ thể như kết nối thêm một công cụ, cập nhật chính sách bảo mật dữ liệu, hay link OKR với các project đang chạy để tăng độ đầy đủ và kết nối.
- Nâng chất “artifact” hàng ngày: yêu cầu mô tả PR rõ ràng, acceptance criteria cụ thể, runbook được điền đủ thông tin để có thứ đáng để AI lập chỉ mục.
- Quan sát kết quả AI: so sánh số token, số lần phải hỏi lại, thời gian xử lý trước và sau khi thay đổi; theo dõi lâu dài để thấy xu hướng giảm lãng phí và tăng chất lượng.
Điểm dễ mắc là cố làm “big bang” cho toàn bộ tổ chức. Thay vào đó, hãy áp dụng quy trình trên cho một luồng công việc hẹp (ví dụ: xử lý sự cố) rồi nhân rộng khi đã thấy hiệu quả.
Sai lầm phổ biến khiến chi phí inference đội lên
Khi nói đến giảm chi phí inference, nhiều đội nghĩ ngay đến việc chọn mô hình rẻ hơn, mà quên rằng ngữ cảnh kém chất lượng mới là nguồn lãng phí lớn. Sai lầm đầu tiên là để kho tri thức đầy những trang hai năm tuổi không ai đụng tới; chúng tạo nhiễu thay vì tạo tín hiệu, khiến AI phải đọc nhiều hơn mà chưa chắc đúng hơn. Một incident tuần trước nên được ưu tiên hơn sự cố ba năm trước, trừ khi có chính sách chính thức cũ vẫn còn hiệu lực.
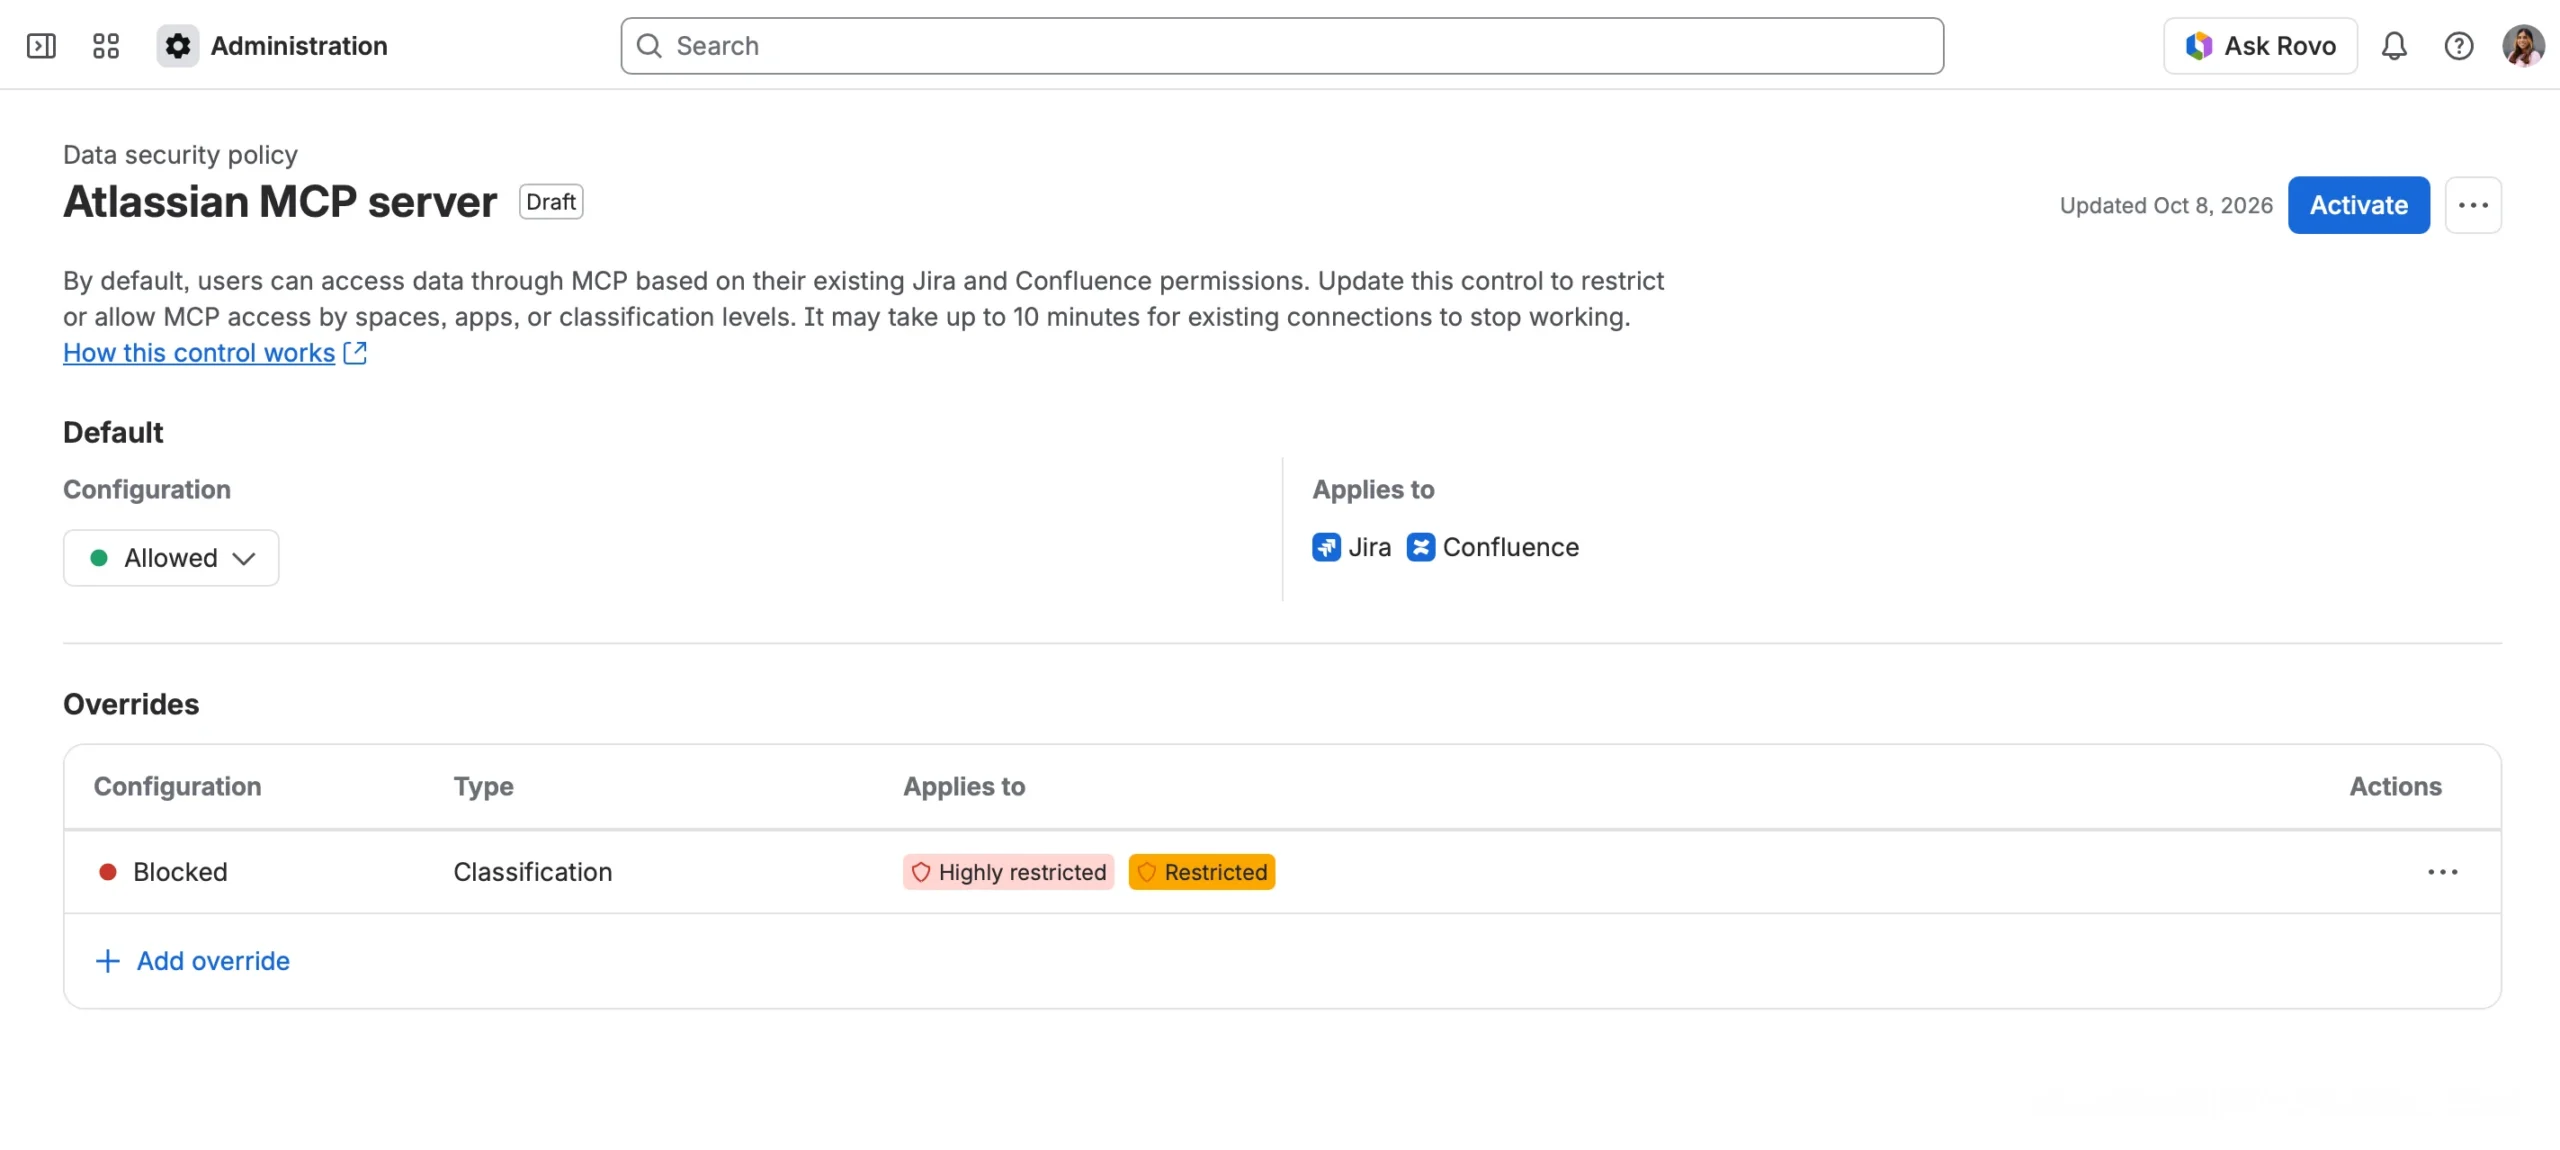
Sai lầm thứ hai là công cụ rời rạc và thông tin không được ghi chép: runbook trống, quyết định nằm trong chat riêng, tài liệu không cập nhật. Khi độ kết nối thấp, AI phải tìm đi tìm lại để đoán cái gì liên quan với nhau, tốn token và làm chậm hiệu suất AI. Thêm vào đó, nếu không phân loại và kiểm soát dữ liệu nhạy cảm, bạn vừa tăng rủi ro, vừa buộc phải giới hạn ngữ cảnh, làm chất lượng câu trả lời giảm. Hai lỗi này đều có thể sửa bằng thói quen hàng ngày: ghi chép đầy đủ, link mọi thứ với nhau, và dọn dẹp nội dung cũ.
Kết quả mong đợi: ít token hơn, output tốt hơn, ngữ cảnh thành tài sản
Khi bạn tối ưu hóa ngữ cảnh AI đúng cách, lợi ích xuất hiện ở cả chi phí lẫn chất lượng. Bạn sẽ thấy ít lần phải hỏi lại, ít câu trả lời “đúng mà vô dụng”, và ít trường hợp AI viết code kỹ thuật ổn nhưng thiếu bối cảnh nên người khác phải sửa lại. Nói cách khác, giảm lãng phí, tăng hiệu suất AI. Đồng thời, cùng một kết quả nhưng mô hình dùng ít token hơn, vì ngữ cảnh đã làm thay phần suy luận “mò mẫm” quanh những lỗ hổng kiến thức.
Một điểm đáng giá: chi tiêu cho mô hình là chi phí lặp lại hàng tháng, còn ngữ cảnh là tài sản tích lũy; mỗi nguồn dữ liệu bạn kết nối và mỗi bản ghi được giữ cập nhật làm cho mọi tương tác AI sau này tốt hơn, trên mọi mô hình và mọi đội. Tối ưu hóa ngữ cảnh AI vì thế không chỉ là mẹo giảm chi phí inference, mà là chiến lược dài hạn để biến dữ liệu làm việc hàng ngày thành lợi thế cạnh tranh bền vững.