
AI agent quản lý dữ liệu là gì và vì sao quyền truy cập phải đi trước AI
AI agent quản lý dữ liệu là tác nhân tự động trong các nền tảng như ChatGPT Work, có khả năng kết nối nhiều nguồn dữ liệu doanh nghiệp, thực hiện phân tích dữ liệu tự động và tạo dashboard dựa trên quyền truy cập hiện hữu của từng tài khoản người dùng, thay vì yêu cầu mở rộng đặc quyền hoặc thay đổi cấu trúc phân quyền đang vận hành. Việc OpenAI công bố Data agent trong ChatGPT Work và đưa công cụ vào thư mục Plugins dưới tên Data đã cho thấy một quan điểm rất rõ ràng: AI phải đi theo quyền, không phải quyền đi theo AI. Nếu doanh nghiệp muốn khai thác AI ở tầng dữ liệu mà vẫn an toàn, câu hỏi đúng không còn là “AI làm được gì?”, mà là “AI được phép thấy cái gì và trong bối cảnh nào?”.
Cách ChatGPT Data agent kết nối dữ liệu nhưng không phá vỡ kiểm soát quyền truy cập
Lợi thế lớn nhất của ChatGPT Data agent không phải là thông minh đến đâu, mà là tôn trọng kiểm soát quyền truy cập đến mức nào. Việc cài Data agent không trao cho AI quyền đọc toàn bộ kho dữ liệu; quản trị viên chọn nguồn kết nối và vai trò được phép sử dụng, còn mọi truy vấn đều tuân thủ quyền hiện hữu của tài khoản kết nối, kể cả giới hạn ở cấp bảng, hàng và cột. Luồng hoạt động được chia thành ba lớp: tổ chức cho phép một nguồn xuất hiện trong workspace; người dùng tự kết nối bằng tài khoản của mình; và Data agent chỉ phân tích phần dữ liệu mà tài khoản đó được phép xem. Hệ quả rất quan trọng: hai người hỏi cùng một câu vẫn có thể nhận phạm vi kết quả khác nhau nếu vai trò và quyền của họ khác. Đây là thiết kế mà bất kỳ doanh nghiệp nghiêm túc về bảo mật cũng nên đòi hỏi ở mọi AI agent quản lý dữ liệu.
Kết nối đa nguồn, phân tích dữ liệu tự động và tạo dashboard theo quyền sẵn có
Điểm đáng giá của ChatGPT Data agent nằm ở khả năng nối nhiều nguồn mà không cần đập đi xây lại hệ thống phân quyền. Danh sách nguồn được công bố bao gồm các kho và nền tảng như Amazon Redshift, Datadog, Google BigQuery, ClickHouse, Databricks, MongoDB và Snowflake. Data agent cũng có thể đưa tệp hoặc tài liệu từ Google Drive và SharePoint vào phép phân tích khi các kết nối tương ứng được tổ chức cho phép. Người dùng có thể bắt đầu bằng một câu hỏi về chỉ số, tiếp tục yêu cầu so sánh các giai đoạn hoặc tách một nhóm dữ liệu, rồi xem bằng chứng đứng sau từng phát hiện. Kết quả sau đó có thể trở thành dashboard tương tác để chỉnh sửa, chia sẻ và làm mới, đồng thời tác nhân có thể xây dựng hoặc tương tác với dashboard trong Omni, Oracle BI, Power BI, Sigma, Tableau và ThoughtSpot. Đây là phân tích dữ liệu tự động đúng nghĩa: hội thoại, có bằng chứng, và không buộc phải nâng quyền nền tảng.
Dữ liệu vận hành, email doanh nghiệp và ranh giới giữa đọc, phân tích và hành động
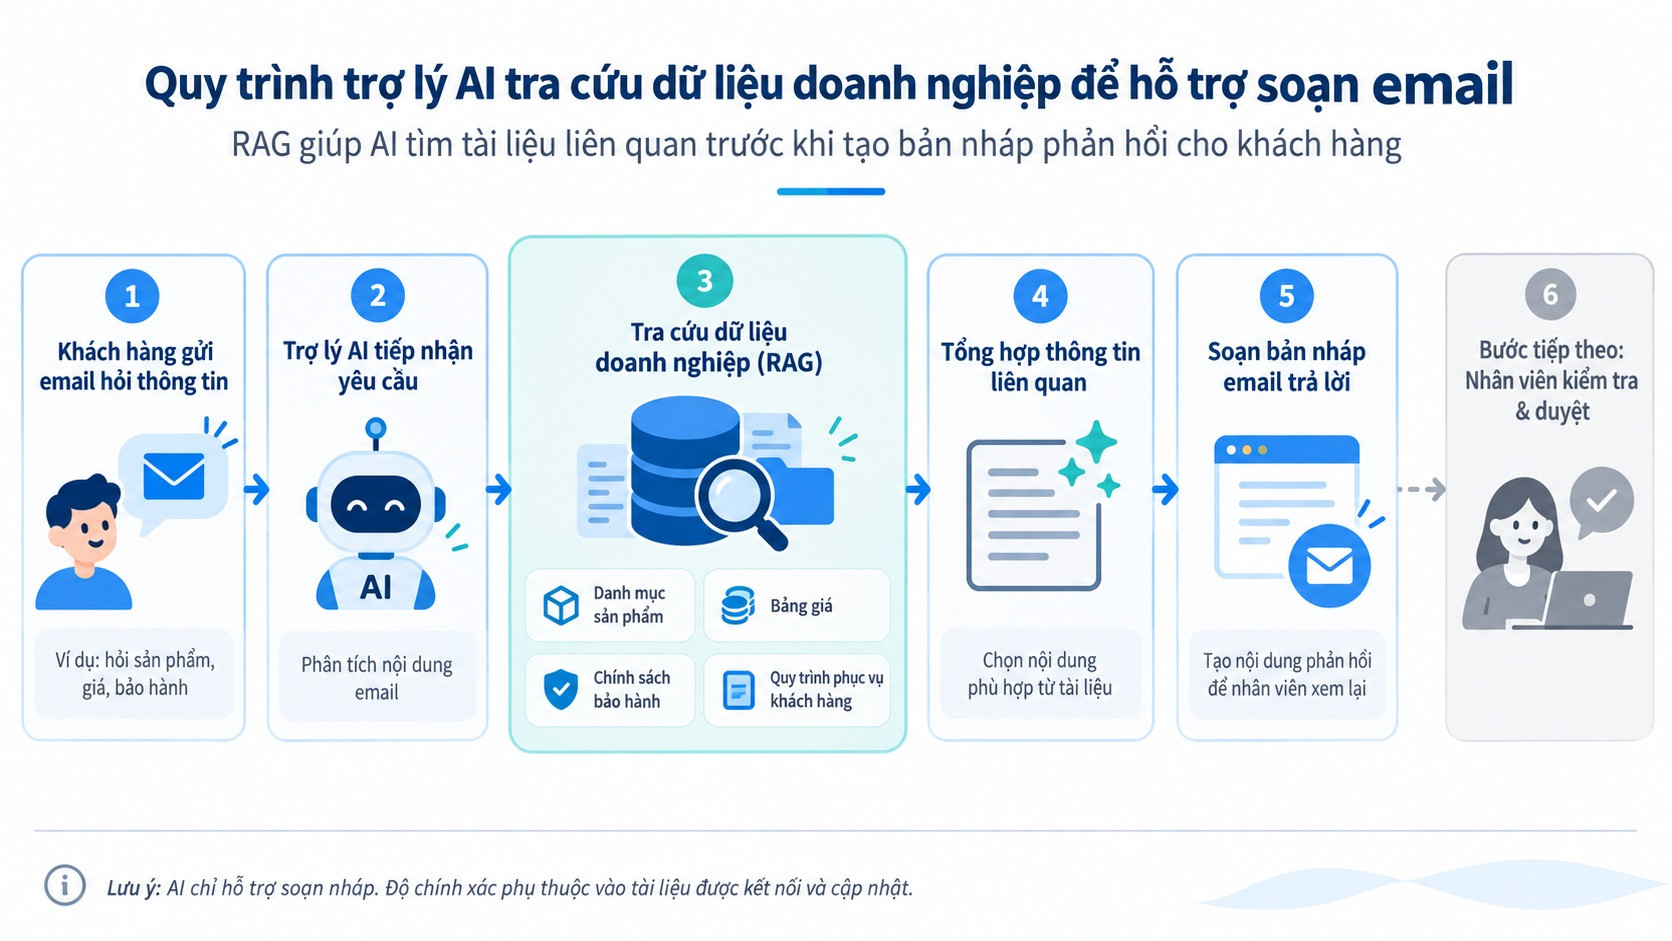
Không phải mọi nguồn dữ liệu đều giống nhau, và AI agent phải phản ánh được khác biệt đó. Với MongoDB Atlas, Data agent có thể truy vấn nơi đơn hàng, phiên sử dụng và sự kiện ứng dụng được ghi nhận khi hệ thống đang vận hành, giúp đội dữ liệu điều tra biến động mà không cần chờ bản trích xuất ETL, miễn là sự kiện đã được ghi và tài khoản có quyền đọc tương ứng. Tuy nhiên, nhãn “thời gian thực” này không thể suy rộng sang mọi kết nối, vì nếu một kho dữ liệu chỉ đồng bộ ban đêm, câu trả lời vẫn bị giới hạn bởi lần làm mới gần nhất. Trên tầng ứng dụng như email doanh nghiệp, bài học tương tự: khi tích hợp với email, doanh nghiệp nên xác định cụ thể hộp thư mà trợ lý được phép truy cập, nguồn dữ liệu được sử dụng, phạm vi công việc có thể thực hiện và những trường hợp bắt buộc phải có người kiểm tra trước khi gửi. Nói cách khác, đọc và phân tích có thể tự động, nhưng hành động cuối cùng phải nằm trong quy trình phê duyệt đã được định nghĩa.
Chiến lược cho doanh nghiệp: khóa schema, giữ quyền cũ, mở ra năng lực mới
Doanh nghiệp muốn hưởng lợi từ AI agent quản lý dữ liệu mà không đánh đổi an toàn cần coi quyền truy cập là “luật bất biến”. Data agent đã gợi ý một mô hình khôn ngoan: quyền ở nguồn dữ liệu quyết định AI được thấy gì; tổ chức chỉ bật những kết nối chấp nhận được; người dùng tự chịu trách nhiệm với tài khoản của mình. Đổi lại, họ có thể phân tích những câu hỏi phức tạp qua hội thoại, yêu cầu so sánh, bóc tách nhóm dữ liệu và biến kết quả thành dashboard mà không cần can thiệp thủ công hoặc xin thêm quyền quản trị mỗi lần phân tích. Trong bức tranh rộng hơn, email doanh nghiệp kết hợp trợ lý AI cho thấy cùng một nguyên tắc: trợ lý chỉ nên đọc và soạn trên phần dữ liệu được phép, còn các tình huống nhạy cảm phải có người phụ trách kiểm tra và phê duyệt trước khi gửi. Nếu schema, định nghĩa KPI và quyền truy cập được khóa chặt, AI không trở thành rủi ro, mà trở thành tầng “siêu người dùng” cho mọi bộ phận.