
Tỷ số 23–4 là một tuyên bố, chưa phải kết luận
Benchmark mô hình nhỏ là phép đánh giá có cấu trúc nhằm đo hiệu suất của các mô hình AI gọn trên những tác vụ được chọn, nhưng kết quả chỉ có ý nghĩa khi cách thử đủ minh bạch và có thể đối chiếu. Ngày 27 tháng 10 năm 2026, Liquid AI công bố bảng gồm 27 bài kiểm chuẩn, tuyên bố LFM3-1.7B thắng 23 bài còn MiniCPM5-2B thắng bốn. Đây là một kết quả đáng quan tâm, nhất là khi hai mô hình nhắm đến triển khai trong điều kiện tài nguyên hạn chế. Nhưng bảng điểm do chính một nhà cung cấp lựa chọn bài thử, dựng cách chạy và đánh giá cả hai mô hình không thể tự biến thành phán quyết độc lập. Điểm số mở ra câu hỏi đúng: LFM3 mạnh ở đâu? Chúng chưa đủ để trả lời mô hình nào sẽ tốt hơn trong mọi công việc thực tế.
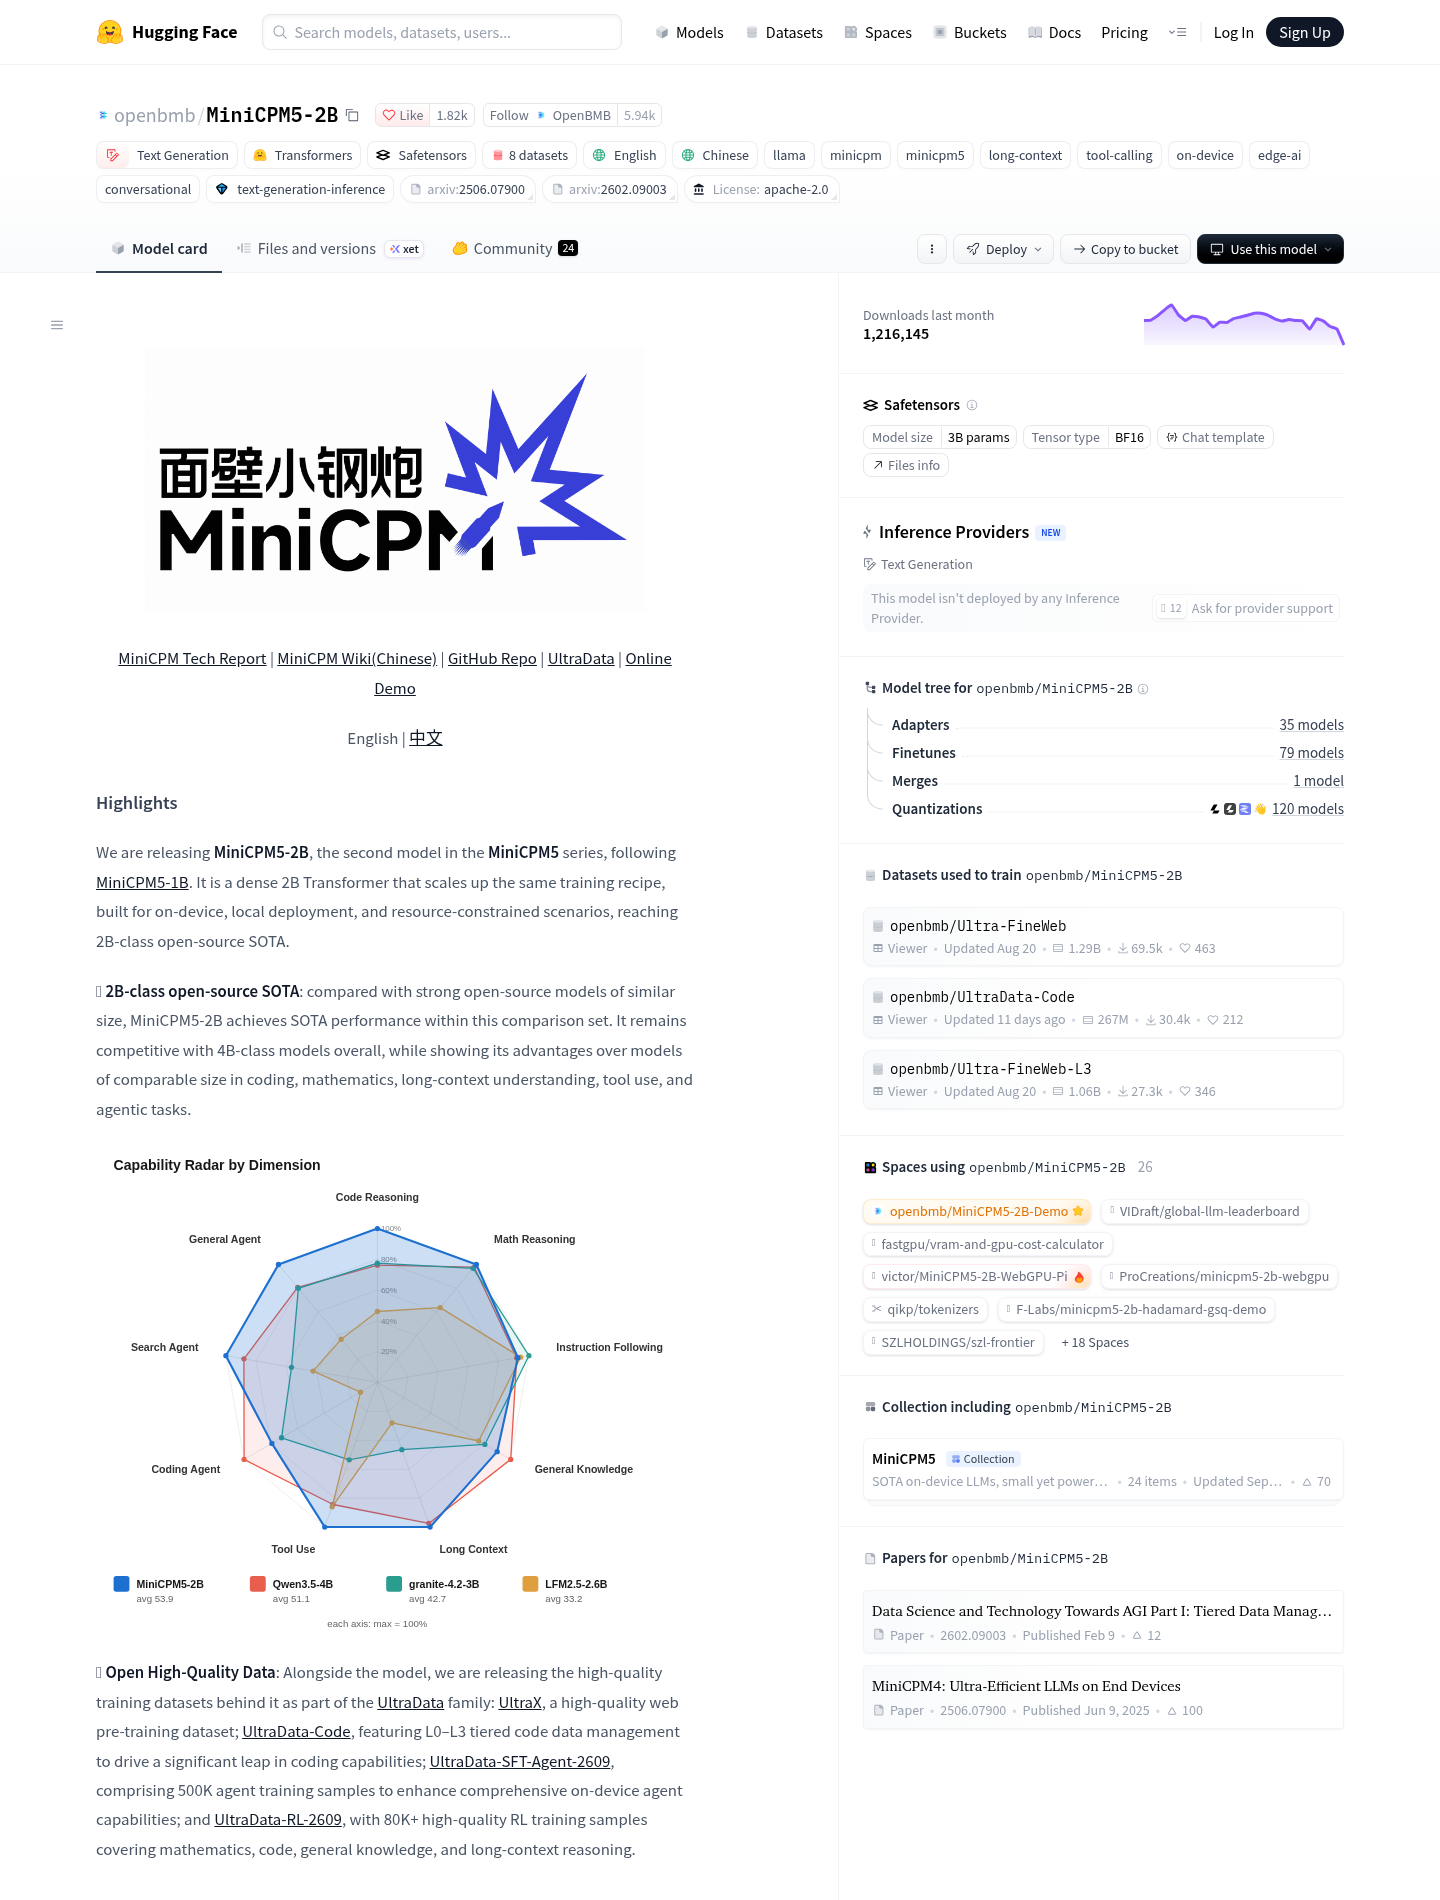
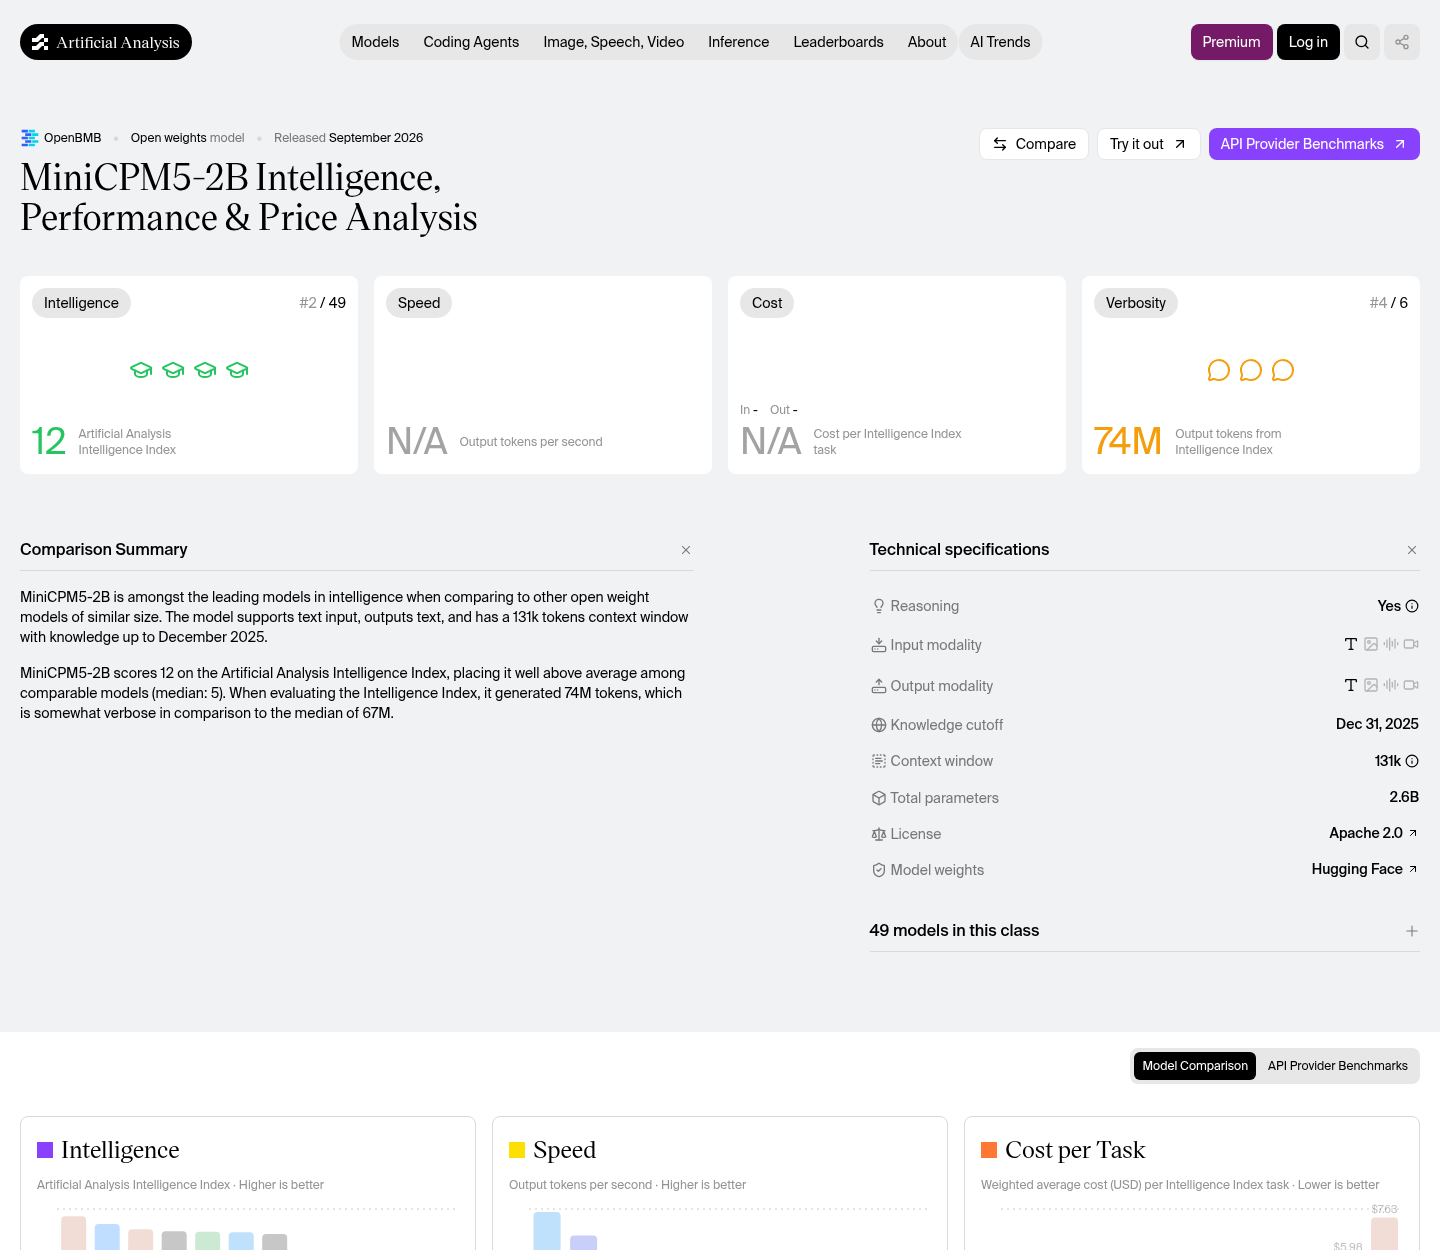
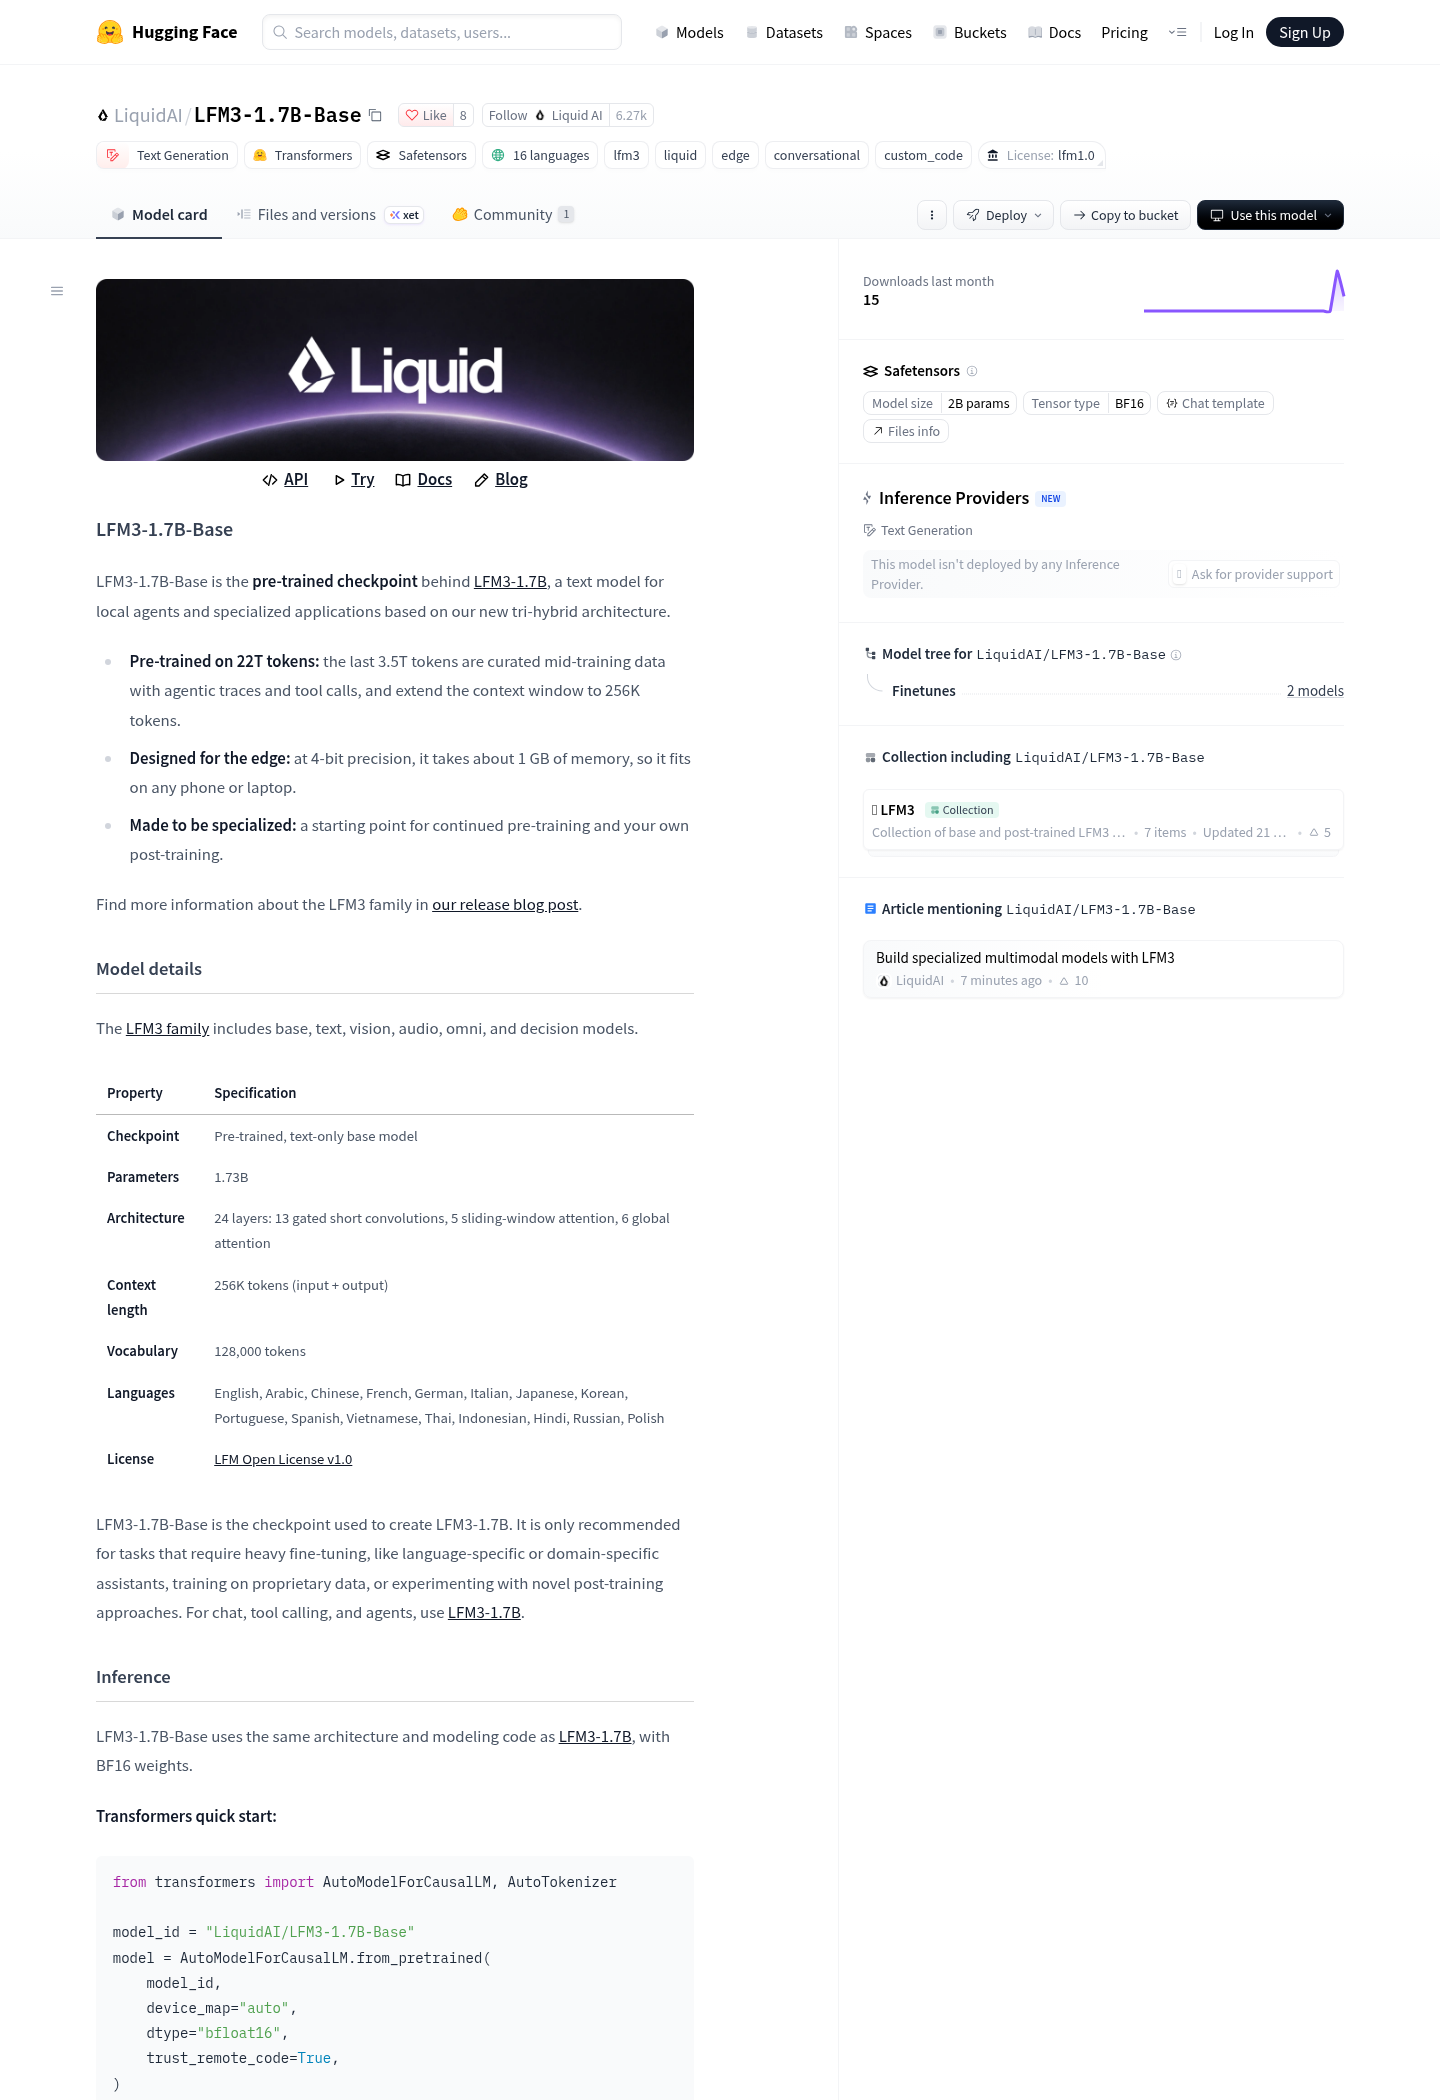
Thời điểm công bố cũng góp phần khiến tỷ số lan nhanh: Liquid đăng bảng đối đầu sau một cuộc so sánh checkpoint gốc trước đó chưa tìm được dữ liệu đánh giá tương ứng. LFM3-1.7B là mô hình văn bản và tác tử 1,73 tỷ tham số; MiniCPM5-2B là mô hình suy luận dense khoảng 2,52 tỷ tham số. Chúng cùng hướng tới nhóm mô hình nhỏ, nhưng được xây dựng với trọng tâm khác nhau. Vì vậy, so sánh mô hình AI bằng một con số thắng-thua duy nhất dễ che khuất cả mục tiêu thiết kế lẫn điều kiện kiểm thử.
Bảng điểm gợi ý lợi thế về tác tử, nhưng không đồng nghĩa thắng mọi việc
Trong bảng của Liquid, khoảng cách nổi bật nhất nằm ở các tác vụ tác tử, gọi công cụ và ngữ cảnh dài. LFM3-1.7B đạt 38,42 so với 9,11 của MiniCPM5-2B trên WebArena-Verified; ở AutomationBench, điểm tương ứng là 41,29 và 4,71. Với RULER 128K, LFM3 đạt 65,56, còn MiniCPM5 đạt 37,96. Nếu các mức chênh lệch này được tái lập trong điều kiện chung, chúng sẽ là bằng chứng đáng kể cho lợi thế của LFM3 ở công việc nhiều bước và xử lý ngữ cảnh dài.
MiniCPM5 lại dẫn ở bốn hạng mục trong bảng: τ³-bench, GPQA Diamond, Humanity’s Last Exam không dùng công cụ và độ chính xác AA-Omniscience. Những kết quả ấy gợi ý mô hình của OpenBMB có thể phù hợp hơn với một số tác vụ kiến thức hoặc suy luận đơn lượt, nhưng không chứng minh nó luôn trội ở nhóm này. Các điểm số thuộc những bài kiểm tra cụ thể, với mức chênh khác nhau; không nên cộng chúng thành một thước đo tổng quát về trí tuệ hay chất lượng sử dụng. Bảng cho thấy hai mô hình có những thế mạnh tiềm năng khác nhau, chứ chưa xác lập thứ hạng phổ quát.
Khác biệt về cách đo làm phép đối chiếu kém chắc chắn
Điểm cần dè chừng nhất là hai bộ kết quả do hai nhà cung cấp công bố, trong khi cấu hình kiểm thử, chính sách thử lại và cách dựng lời nhắc chưa được công khai đầy đủ. Ngay cả cùng một benchmark cũng có thể cho câu trả lời khác khi harness thay đổi. Chẳng hạn, OpenBMB báo MiniCPM5-2B đạt 46,4 trên SWE-bench Verified, trong khi Liquid báo LFM3-1.7B đạt 43,40; nhưng khi so hai mô hình bằng các con số trong bảng riêng của Liquid, thứ tự lại đảo chiều. Đó không phải phép đối chiếu trực tiếp giữa hai điểm cùng điều kiện.
Một số chênh lệch như WebArena-Verified hay AutomationBench đủ lớn để đáng kiểm tra nghiêm túc, nhưng vẫn cần tái lập trước khi xem là bằng chứng chắc chắn về năng lực thực tế. Chênh lệch nhỏ ở các bài khác càng dễ chịu ảnh hưởng bởi thiết lập và biến động trong quá trình chạy. Hơn nữa, bảng điểm hậu huấn luyện không cho biết riêng checkpoint gốc sẽ ra sao: LFM3-1.7B-Base được đưa lên kho lưu trữ ngày 26 tháng 10, nhưng các điểm Liquid công bố thuộc mô hình đã qua các bước hậu huấn luyện. Vì thế, tỷ số 23–4 nên được xem là lập luận của Liquid, không phải kết quả đã được cả ngành xác nhận.
Người dùng nên chọn theo tác vụ và chờ phép thử chung
Với người dùng, lựa chọn hợp lý phụ thuộc vào công việc chứ không phải số dòng thắng. Nếu cần tác vụ nhiều bước, gọi công cụ hoặc xử lý tài liệu dài, LFM3-1.7B là ứng viên đáng thử dựa trên các kết quả Liquid công bố. Mô hình này có ngữ cảnh tối đa 256K token; checkpoint gốc được mô tả là có thể chiếm khoảng 1 GB ở độ chính xác 4-bit, một điểm có ý nghĩa khi triển khai trên thiết bị hạn chế tài nguyên. Với nhu cầu truy xuất kiến thức hoặc suy luận một lượt, MiniCPM5-2B vẫn là lựa chọn đáng cân nhắc; giấy phép Apache 2.0 của nó cũng khác với giấy phép riêng của LFM3.
Bước tiếp theo cần thiết không phải là thêm một bảng tự chấm điểm, mà là chạy cả hai mô hình qua cùng một harness, công khai cấu hình, lời nhắc và chính sách thử lại. Một cuộc kiểm thử chung dự kiến trong 30 ngày sẽ giúp xác định khoảng cách agentic của LFM3 có giữ được hay phần nào đến từ cách dựng bài. Hỗ trợ LFM3 trong SGLang vẫn đang ở trạng thái yêu cầu kéo mở tại thời điểm nguồn ghi nhận, dù yêu cầu liên quan cho cookbook đã được hợp nhất. Cho đến khi có kết quả tái lập, 23–4 là tín hiệu hữu ích để định hướng thử nghiệm, không phải câu trả lời cuối cùng.