
Grok 4.7 là gì và vì sao giới lập trình cần quan tâm?
Grok 4.7 là mô hình AI coding mới nhất của xAI, được định vị cho công việc lập trình và xử lý tri thức dài với cửa sổ ngữ cảnh 500.000 token, hướng đến khả năng giải quyết chuỗi nhiệm vụ kỹ thuật phức tạp và tài liệu khối lượng lớn trong một phiên duy nhất, đồng thời duy trì mức giá dịch vụ cạnh tranh so với các đối thủ cao cấp trên thị trường. Đây không phải một bản nâng cấp mang tính trình diễn, mà là nỗ lực rõ ràng của Elon Musk đưa xAI chen chân vào nhóm phòng thí nghiệm AI hàng đầu, dù vẫn chấp nhận đứng dưới các tên tuổi như Claude Fable, Opus hay GPT Astra. Vấn đề nằm ở chỗ: sức mạnh lập trình của Grok 4.7 đã khá tốt, nhưng cái giá phải trả bằng token cho mỗi nhiệm vụ đang khiến nó trở thành lựa chọn phải cân nhắc kỹ, chứ không phải “no-brainer” cho mọi team.
Hiệu năng thực tế: điểm số ấn tượng nhưng vẫn ở chiếu dưới
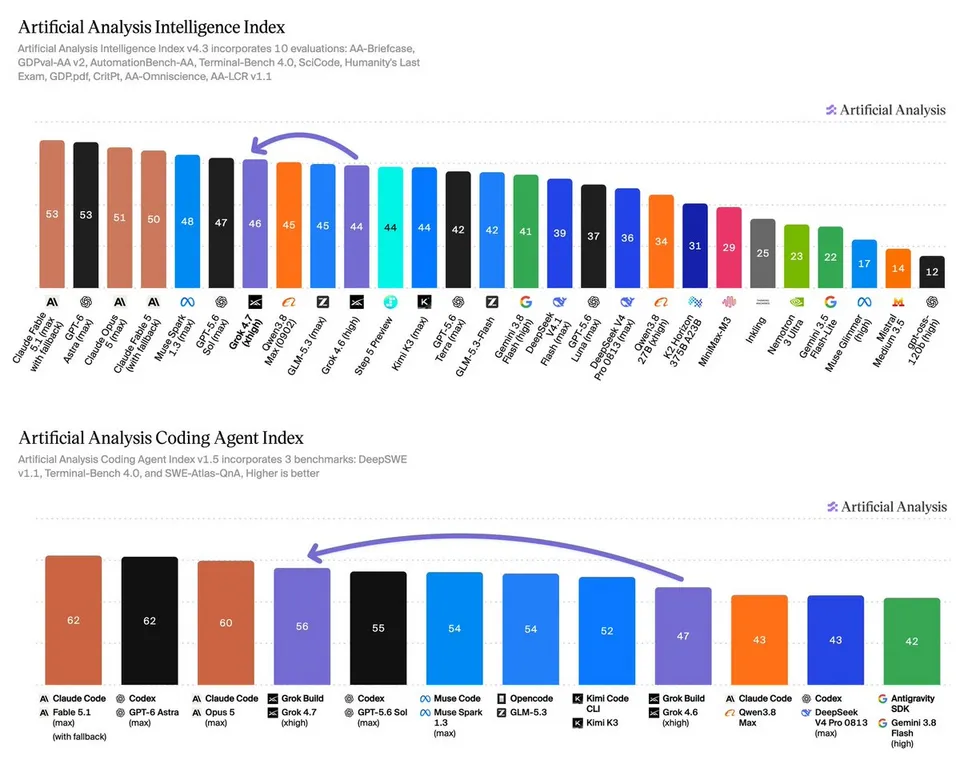
Về mặt điểm số, Grok 4.7 tiến bộ rõ rệt so với 4.6 nhưng vẫn không chạm đỉnh. Artificial Analysis chấm mô hình này đạt 46 điểm trên Chỉ số Thông minh, đưa SpaceXAI vào top 4 phòng thí nghiệm AI hàng đầu hiện nay. Trong các bài test tri thức chuyên môn như AA-Briefcase và GDPval-AA, Grok 4.7 lần lượt đạt 1.657 và 1.695 Elo, tăng mạnh so với 4.6 nhưng vẫn đứng sau các đại diện như Claude Fable 5.1 và GPT-6 Astra. Điểm Coding Agent Index khi kết hợp với trợ lý Grok Build đạt 56, vượt GPT-5.6 Sol và tiến gần nhóm dẫn đầu. Elon Musk cũng thẳng thắn thừa nhận Grok 4.7 chỉ tương đương Claude Opus 5.0, chưa thể vượt được Opus 5.1 của Anthropic, đặc biệt ở năng lực đa phương thức. Nói cách khác, đây là mô hình đủ mạnh để làm việc nghiêm túc, nhưng chưa phải “vũ khí hạng nặng” tối ưu nhất cho mọi use case khó.
Lập trình với Grok 4.7: sức mạnh context đổi bằng chi phí token
Ở góc độ Grok 4.7 lập trình, bức tranh thú vị hơn nhưng cũng phức tạp hơn. Mô hình này được thiết kế cho các tác vụ coding dài hơi, từ refactor codebase lớn đến xây dựng hệ thống đa module, nhờ cửa sổ ngữ cảnh 500.000 token cùng việc tích hợp Grok Build làm trợ lý lập trình chuyên biệt. Trên CursorBench 4.0 – bài test mô hình AI coding ngay trong IDE Cursor – Grok 4.7 rơi vào nhóm giữa: độ chính xác khá, nhưng chi phí mỗi tác vụ lại cao hơn GPT-6 Astra và Claude Sonnet 5, trong khi kết quả vẫn chưa bắt kịp Fable 5.1 ở mọi phân khúc chi phí. Artificial Analysis thống kê trung bình một nhiệm vụ kiểm tra của Grok 4.7 tạo ra tới khoảng 81.000 output token, trong khi Grok 4.6 dừng ở 36.000 và GPT-6 Astra chỉ 27.000. Nghĩa là cùng một job, Grok 4.7 có xu hướng "nói" nhiều hơn, kéo theo hóa đơn token phình ra – lợi nếu bạn cần tài liệu chi tiết, bất lợi nếu bạn tối ưu ngân sách.
Giá rẻ, cửa sổ lớn: chiến lược dài hơi của xAI
Điều đáng nói là xAI kiên định với chiến lược giá rẻ và phổ cập, thay vì đua “top tier” bằng mọi giá. Mức giá token của Grok 4.7 giữ nguyên so với 4.6, và theo các tuyên bố, vẫn thấp hơn các gói cao cấp từ Anthropic hay OpenAI, dù sức mạnh xử lý thuần chưa bằng. Với việc mô hình có thể tung ra câu trả lời dài, giàu chi tiết, tổng chi phí mỗi nhiệm vụ lại có xu hướng tăng, khiến mảng AI này tiếp tục ghi nhận khoản lỗ lớn ở cấp công ty mẹ. Nhưng từ góc nhìn người dùng thông thường, Grok 4.7 vẫn là công cụ “đủ tốt”: không cần danh sách chờ, xuất hiện ngay trên ứng dụng Grok, nền tảng Cursor, Grok Build và API, đồng thời đang phục vụ hàng triệu người dùng trên mạng xã hội X và xe Tesla. Đây là bài toán đường dài: nếu Grok hiện diện ở mọi nơi với chi phí tương đối thấp, xAI hy vọng hiệu ứng mạng sẽ quan trọng hơn việc thua đôi chút về điểm benchmark.
Vị trí của Grok 4.7 trên thị trường AI và bước tiếp theo
Grok 4.7 đặt xAI (hay SpaceXAI trong một số tài liệu) vào vị trí thú vị: không dẫn đầu về hiệu năng, nhưng đã chen chân vào top 4 phòng thí nghiệm AI quan trọng. Elon Musk vẽ ra lộ trình rõ ràng: Grok 4.8 sẽ là bước nhảy đáng kể, Grok 4.9 được kỳ vọng cạnh tranh trực diện với GPT-6 Astra và Claude Fable, còn Grok 5 được ông gọi là ứng viên đầu tiên cho trí tuệ nhân tạo tổng quát (AGI). Dù vậy, không có lịch phát hành cụ thể, và mọi tuyên bố vẫn nằm ở phía trước. Thực tế hiện tại là Grok 4.7 giúp xAI thoát khỏi hình ảnh “đồ chơi trên mạng xã hội” và trở thành mô hình AI coding nghiêm túc, nhưng cái bóng của Claude Opus, Fable và Astra vẫn còn rất dài. Nếu các bản 4.8, 4.9 không giải quyết được bài toán chi phí token AI trên mỗi nhiệm vụ, cơ hội bứt phá của Grok 5 sẽ bị hạn chế, dù tham vọng AGI nghe rất hấp dẫn trên giấy.