
Gemini 4 Argon là gì và vì sao bảng điểm lại gây tranh cãi?
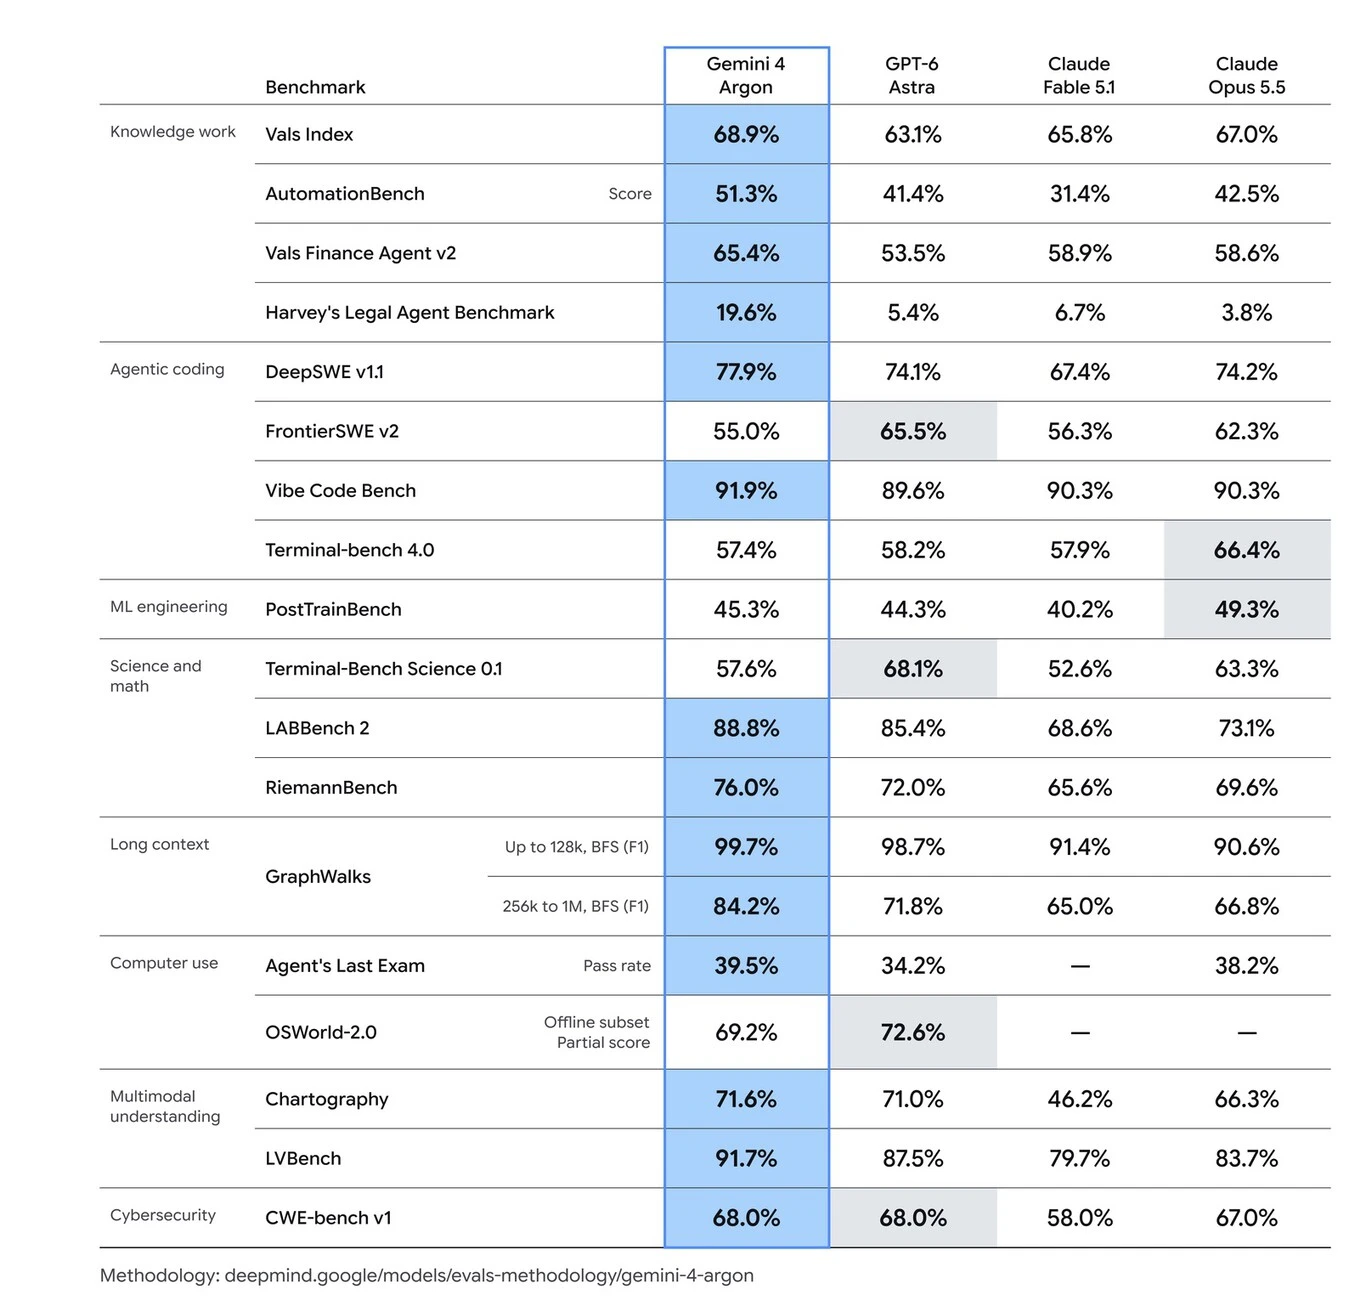
Gemini 4 Argon là mô hình AI Google thuộc nhóm "model biên" mới, được quảng bá là đạt điểm số hàng đầu trong các bài benchmark trí tuệ nhân tạo, đặc biệt về lập trình, bảo mật và khả năng giảm ảo giác, qua đó được xem như đòn phản công của Google trong cuộc đua mô hình AI thế hệ mới với các đối thủ OpenAI và Anthropic. Sau nhiều tháng trì hoãn, Google mới mang Gemini 4 Argon ra ánh sáng, kỳ vọng nó đưa hãng trở lại nhóm ba mô hình AI mạnh nhất thế giới theo kết quả benchmark. Theo đánh giá Intelligence Index của Artificial Analysis, Gemini 4 Argon đạt 53 điểm, ngang GPT-6 Astra và được các thử nghiệm nội bộ xem là vượt Opus 5.5 và Fable 5.1 trong nhiều bài test khác nhau. Trên giấy tờ, hiệu năng AI của Gemini 4 Argon gần như "thủ khoa"; vấn đề là chính đội ngũ kỹ sư Google lại không hoàn toàn tin vào bảng điểm đó và bắt đầu đặt dấu hỏi về khả năng thực chiến của mô hình.
Benchmark xuất sắc: điểm số đẹp nhưng câu chuyện chưa trọn vẹn
Nếu chỉ nhìn vào các bảng Gemini 4 Argon benchmark, khó mà không ấn tượng. Mô hình được Artificial Analysis chấm 53 điểm trong Intelligence Index, ngang GPT-6 Astra, và trong các phép đo nội bộ thì được coi là "con quái vật" vượt mặt Opus 5.5 và Fable 5.1 trên nhiều bài test. Tỷ lệ ảo giác trong thử nghiệm AA-Omniscience chỉ ở mức 15%, trong khi GPT-6 Astra đạt tới 50%. Đây là một phát biểu đáng trích dẫn: "Artificial Analysis cho biết Gemini 4 Argon chỉ có tỷ lệ ảo giác 15% trong AA-Omniscience, so với 50% của GPT-6 Astra". Nghe qua, Gemini 4 Argon là mô hình AI Google có hiệu năng AI cực kỳ ấn tượng. Nhưng cần nhớ, benchmark phải là các tác vụ rõ ràng, có đáp án và dễ kiểm chứng, chứ không phản ánh môi trường người dùng thật với codebase khổng lồ, tài liệu thiếu sót và yêu cầu mơ hồ. Benchmark giỏi chỉ chứng minh mô hình biết "làm bài thi" tốt; nó chưa đủ để khẳng định mô hình sẽ là trợ lý AI hữu ích, tiết kiệm thời gian và đáng tin cho đa số người dùng.
Kỹ sư Google nghi ngờ: khi "thủ khoa" bước vào phòng thí nghiệm
Điểm thi thì thủ khoa, nhưng khi bước vào phòng thí nghiệm của chính Google, Gemini 4 Argon lại bị chấm khá thấp. Nhân viên được phỏng vấn cho biết: dù mô hình đạt điểm số cực cao trong các bài kiểm tra, khi dùng vào một số tác vụ lập trình thực tế thì hiệu năng AI trở nên kém mượt, lời giải không còn sắc sảo như trên bảng điểm. Một số kỹ sư Google thẳng thắn lắc đầu trước mô hình AI đắt đỏ này, đặt câu hỏi liệu hãng đang đuổi theo "thành tích ảo" thay vì sản phẩm dùng tốt. Người sáng lập Surge AI, Edwin Chen, chỉ rõ căn bệnh chạy theo benchmark: phòng lab mải tối ưu để mô hình vượt bài test viết mã ở một ngôn ngữ, mà ít tập trung vào trải nghiệm, giao diện và khả năng trở thành công cụ dễ dùng trong quy trình làm việc thật. Nội bộ Google xuất hiện khoảng cách rõ rệt: có người cho rằng Gemini 4 đang thụt lùi so với Fable hay Astra, có người tin nó đã kịp đứng chung mâm với các phòng thí nghiệm hàng đầu. Khi chính đội phát triển còn tranh cãi, bảng điểm đẹp không đủ xoa dịu nỗi bất an.
Ý nghĩa và giới hạn của benchmark trong đánh giá mô hình AI
Câu chuyện Gemini 4 Argon cho thấy một sự thật khó chịu: benchmark là công cụ cần thiết, nhưng là thước đo phiến diện. Các bài test lập trình hay tự động hóa được thiết kế thành nhiệm vụ có phạm vi rõ, dễ lặp lại, dễ chấm điểm. Trong khi đó, đời sống người dùng AI hiếm khi "sạch sẽ" như vậy; họ làm việc với repo hỗn độn, hệ thống phụ thuộc chằng chịt, tài liệu thiếu và yêu cầu mơ hồ. Nhiều chuyên gia đã nhắc lại: những con số điểm chuẩn không kể hết câu chuyện về chất lượng của một mô hình AI. Gemini 4 Argon hiện mới chỉ được cung cấp cho nhóm "probadores de confianza" và chuyên gia an ninh thông qua chương trình Fairwind, đồng thời chịu sự rà soát của chính phủ Mỹ trước khi được phát hành rộng rãi. Điều này càng nhấn mạnh rằng, mọi đánh giá dựa trên benchmark vẫn là "chuyện trong phòng lab"; sức mạnh thật sự chỉ lộ diện khi mô hình AI Google này được cắm sâu vào quy trình làm việc của hàng triệu nhà phát triển, doanh nghiệp và người dùng phổ thông.
Từ phòng thí nghiệm đến người dùng: Google có dám đặt lại trọng tâm?
Bối cảnh ra mắt Gemini 4 Argon đặt Google vào thế "ngàn cân treo sợi tóc": sau nhiều tháng bị xem là lạc nhịp trong cuộc đua model biên, hãng buộc phải chứng minh mình vẫn thuộc top đầu. Mô hình này gánh nhiệm vụ "thay máu" câu trả lời AI trên hàng loạt siêu ứng dụng như Search, Maps, Gmail, Chrome, mỗi nền tảng đều có trên một tỉ người dùng. Nếu Gemini 4 Argon chỉ mạnh trên giấy tờ nhưng yếu trong thực tế, rủi ro cho trải nghiệm của số đông là rất lớn. Trong khi đó, giao diện Gemini bị chê là không nổi bật, chi phí vận hành mô hình đồ sộ tạo sức ép lên biên lợi nhuận, và làn sóng nhà nghiên cứu kỳ cựu như Quốc Lê, Jeff Dean, Sanjay Ghemawat, Oriol Vinyals rời công ty để lập startup Discovery Loop càng khiến câu chuyện nhân sự thêm căng thẳng. Ở thời điểm này, câu hỏi không phải "Gemini 4 Argon đạt bao nhiêu điểm benchmark?" mà là "Google có dám dịch chuyển trọng tâm từ điểm số sang giá trị sử dụng thật cho người dùng hay không?". Nếu không, bảng điểm đẹp của Gemini 4 Argon sẽ chỉ là một trang CV bóng bẩy cho một ứng viên chưa chứng minh được năng lực trên công việc.