
Meta AI: minh bạch ở bề mặt, mâu thuẫn ở lõi dữ liệu
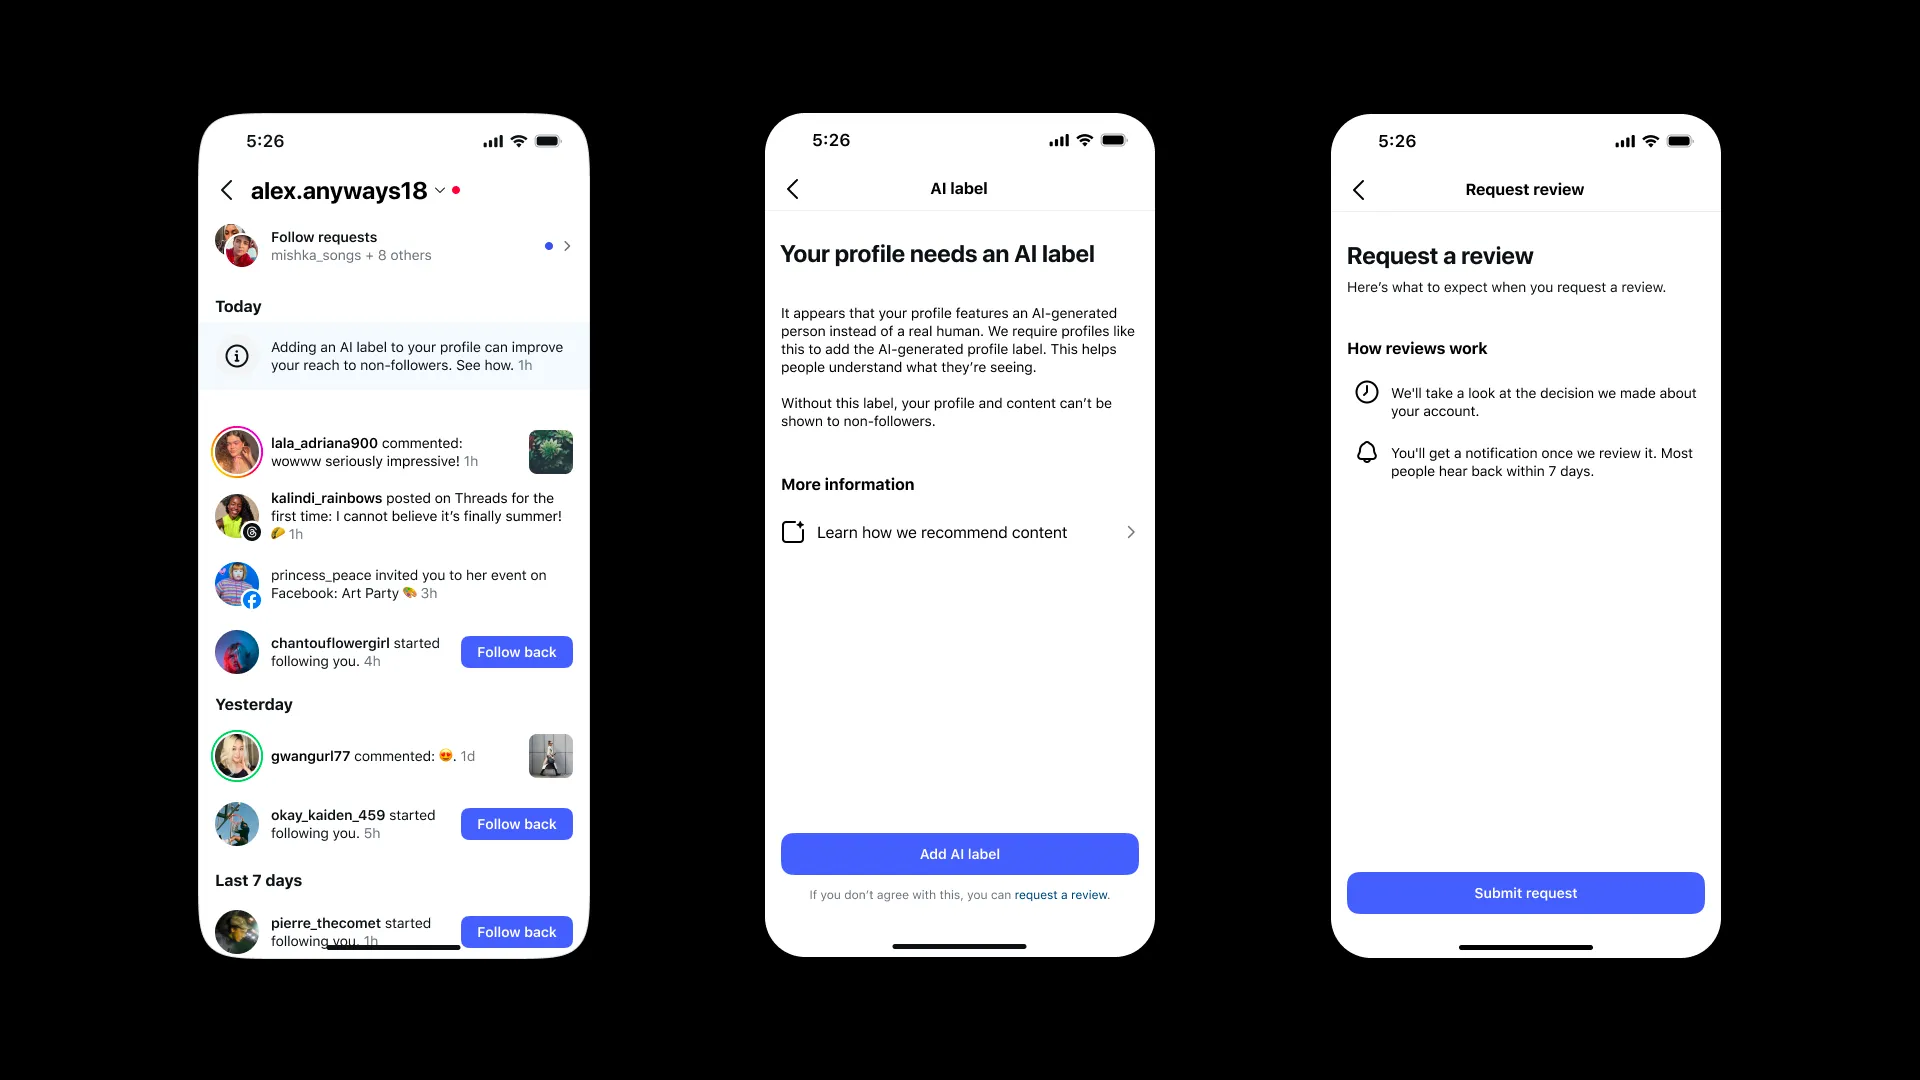
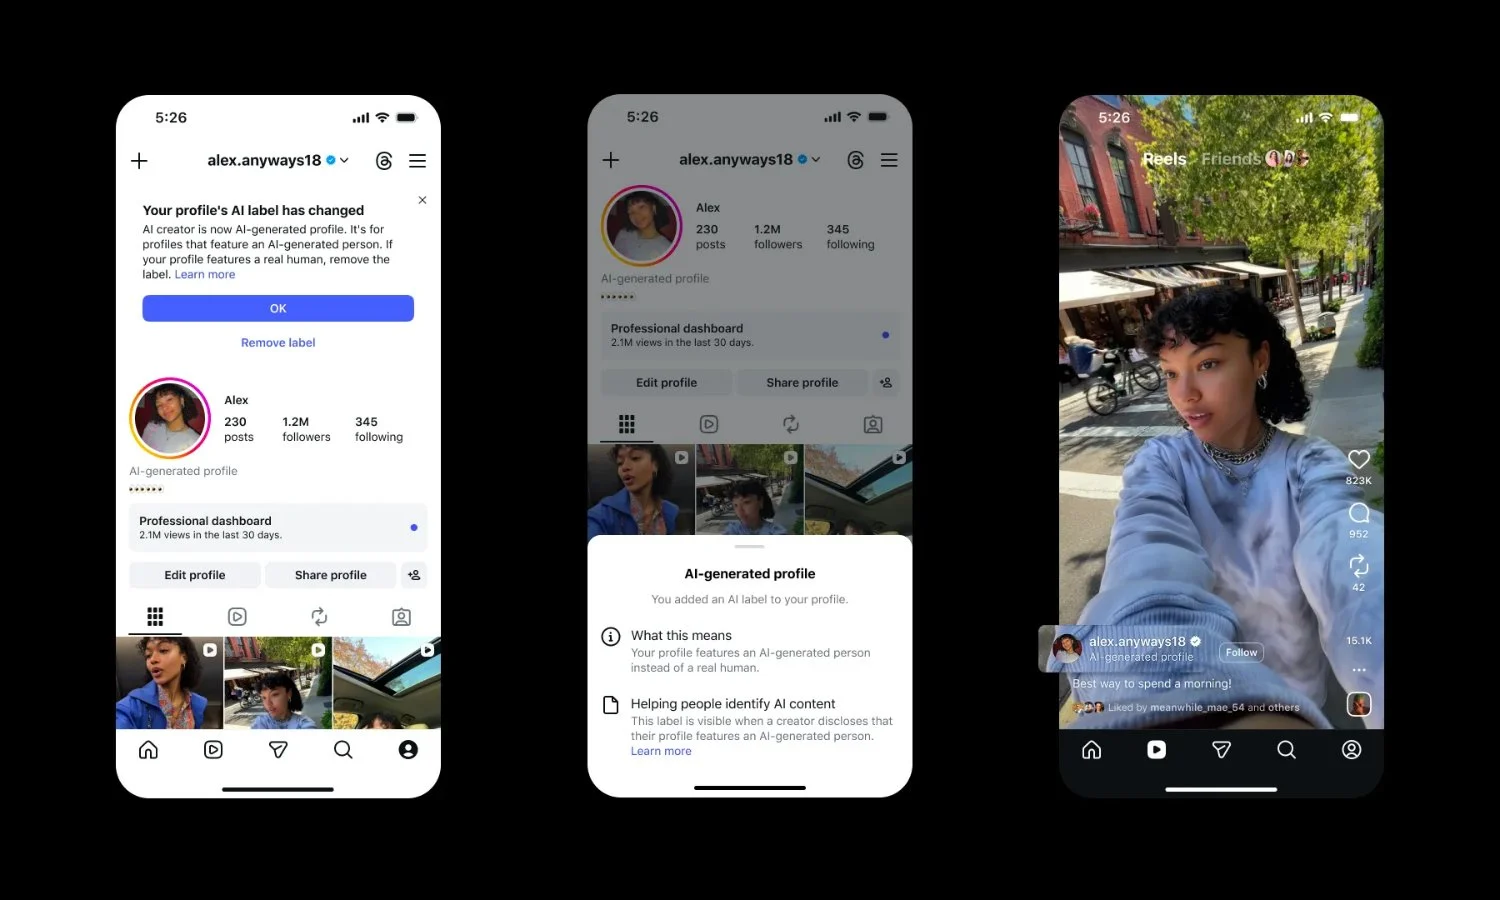
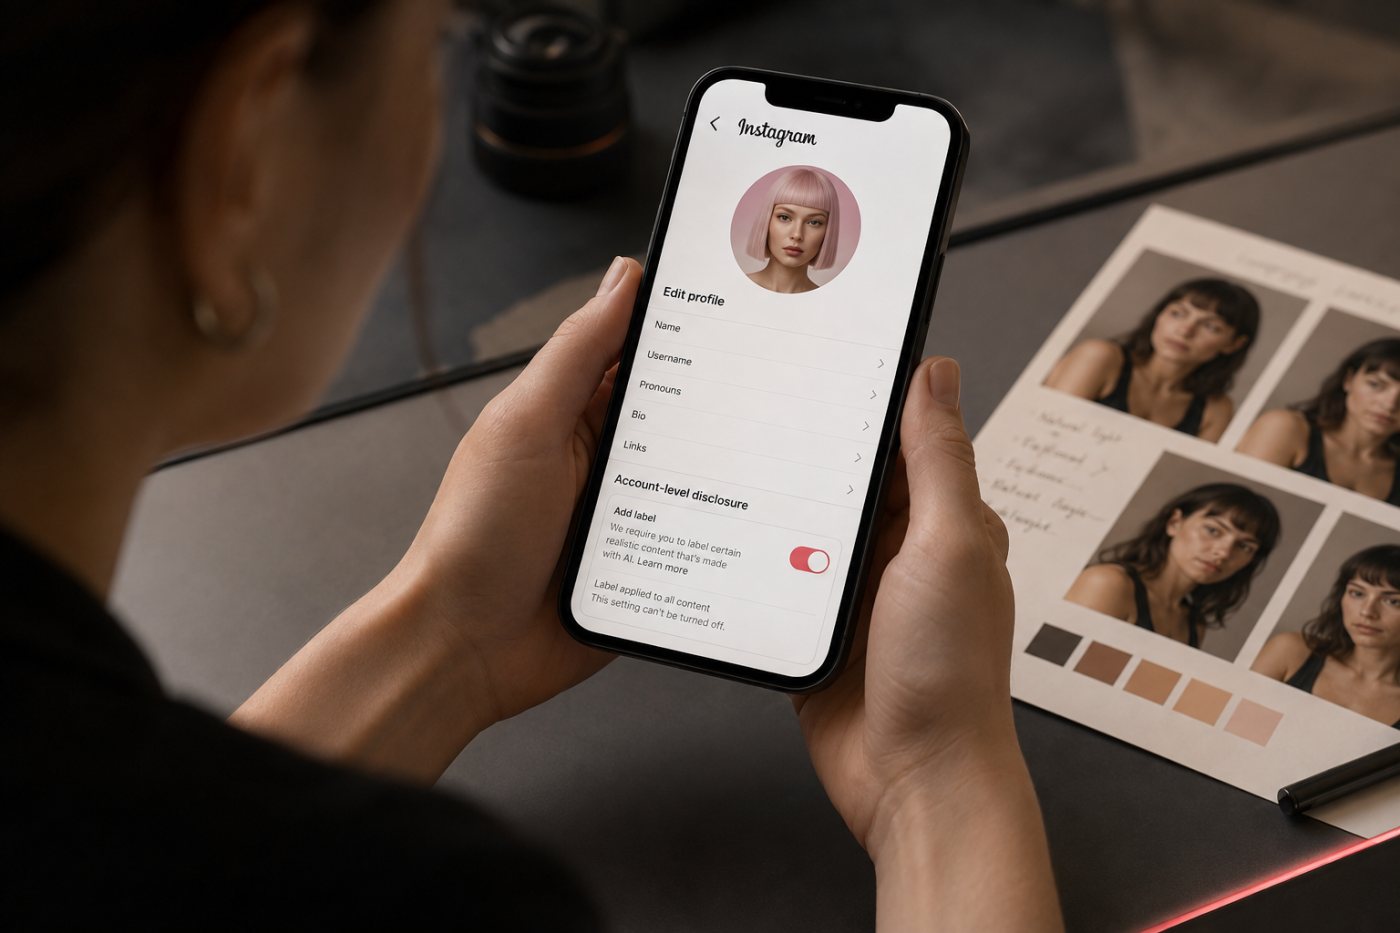
Chiến lược Meta AI minh bạch là tập hợp các chính sách nhãn hồ sơ AI, thông báo sử dụng dữ liệu và điều chỉnh sản phẩm được trình bày như nỗ lực bảo vệ quyền riêng tư dữ liệu, nhưng song song lại xuất hiện các cáo buộc lợi dụng dữ liệu AI, thu thập thông tin sinh trắc học và thử nghiệm nhận diện khuôn mặt trong kính thông minh, tạo ra khoảng cách lớn giữa lời hứa công khai và cách nền tảng xử lý ảnh, video, hành vi người dùng ở hậu trường. Ngày 31/8, Instagram đổi nhãn tài khoản từ “AI creator” sang “AI-generated profile” và tuyên bố sẽ giảm phạm vi tiếp cận đối với hồ sơ có nhân vật do AI tạo nhưng không khai báo. Biện pháp này được quảng bá như một bước tiến về minh bạch danh tính trên nền tảng, nhưng lại diễn ra trong bối cảnh Meta đối mặt cùng lúc với hàng loạt vụ kiện và bê bối dữ liệu xoay quanh chính công nghệ AI của mình.
Nhãn hồ sơ AI: bước tiến minh bạch hay lớp sơn PR?
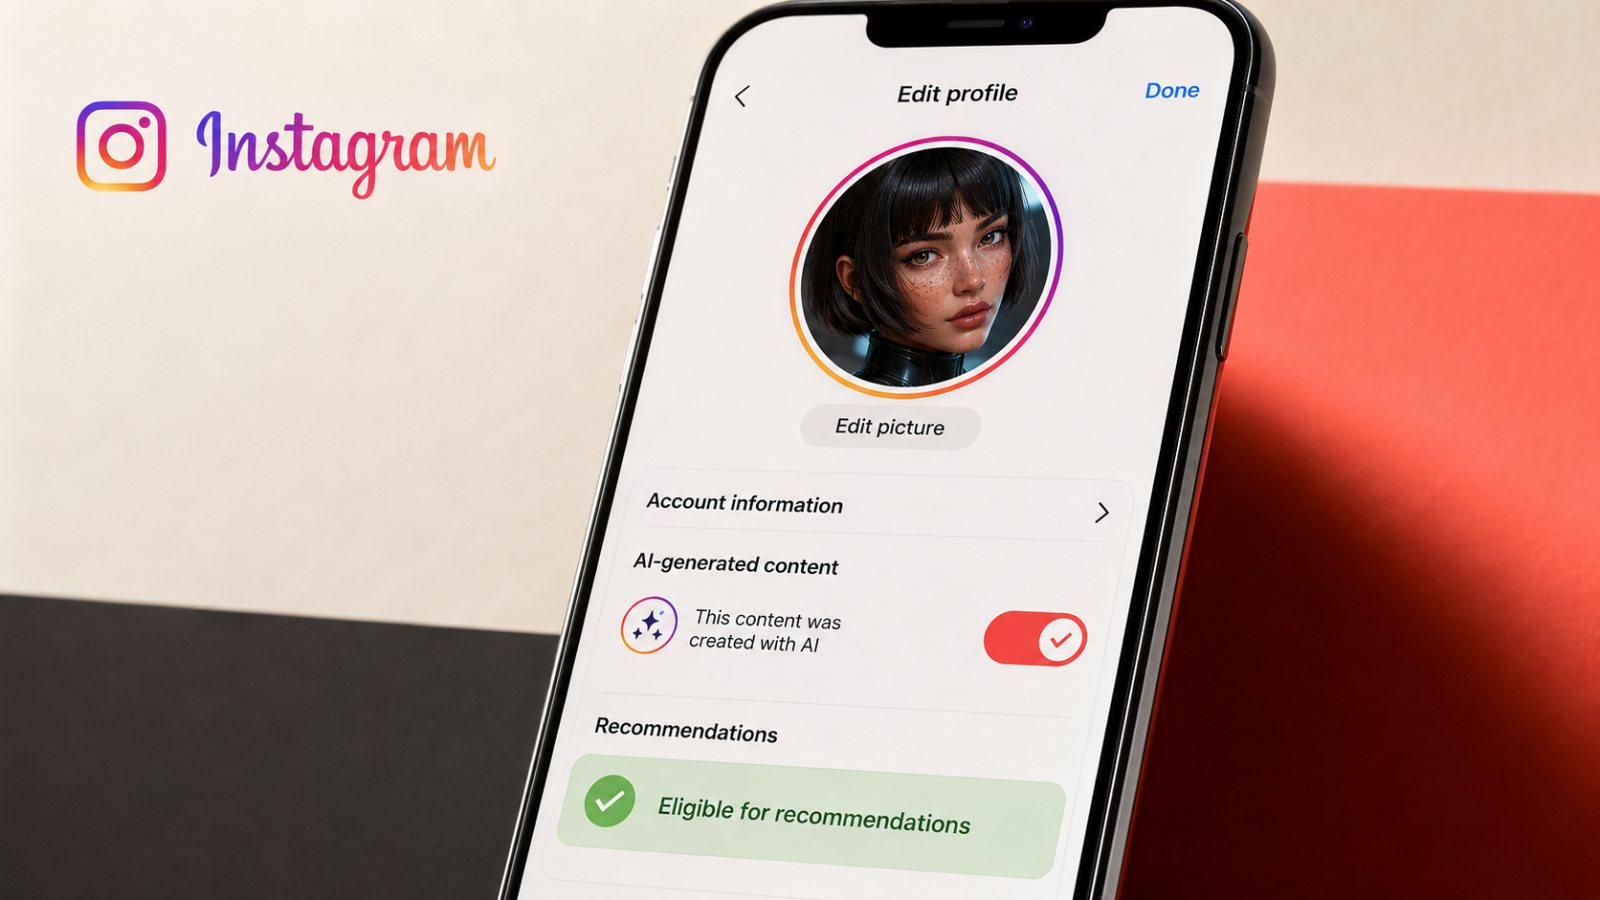
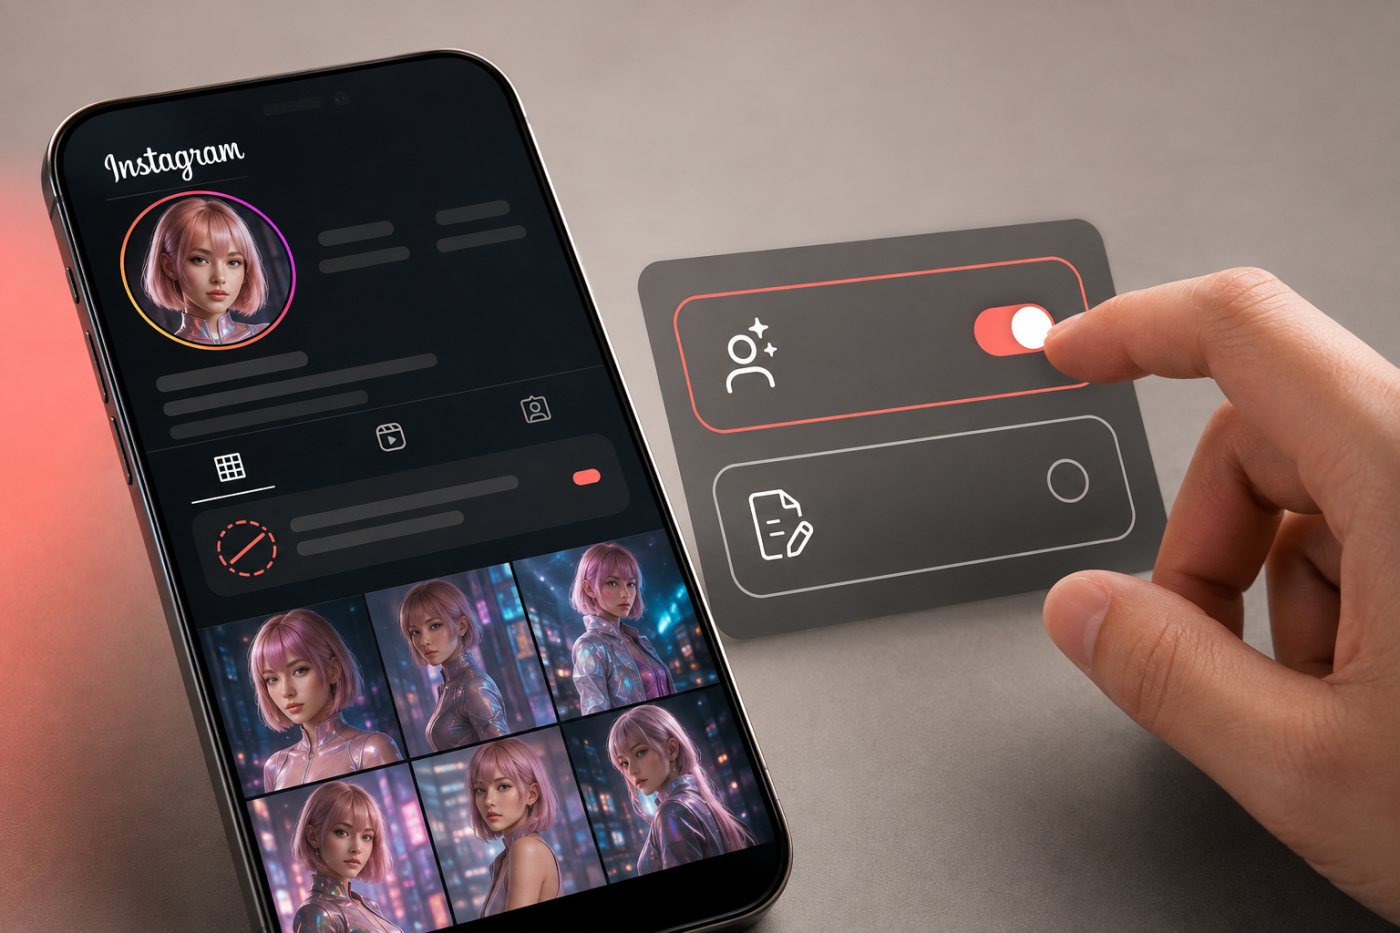
Việc siết nhãn hồ sơ AI trên Instagram cho thấy Meta thừa nhận người dùng cần rõ ràng về việc họ đang tương tác với người thật hay nhân vật nhân tạo. Nhãn “AI-generated profile” nhắm thẳng vào tài khoản lấy một người do AI tạo làm chủ thể trung tâm của hồ sơ. Creator có thể vào phần chỉnh sửa và bật tuỳ chọn này, trong khi nội dung riêng lẻ vẫn có lớp thông tin “AI Info” ở cấp ảnh, video hoặc Reel. Quan trọng hơn, đây không phải quy tắc mang tính hình thức: hồ sơ thuộc diện phải gắn nhãn nhưng giấu nhãn có thể bị giảm reach và mất điều kiện xuất hiện trong mục đề xuất, trực tiếp ảnh hưởng khả năng tiếp cận khán giả của các “người ảo”. Tuy vậy, Meta thừa nhận hệ thống phát hiện không phải lúc nào cũng chính xác và chưa công bố thời gian xử lý kháng nghị được bảo đảm, cho thấy việc thực thi vẫn còn mơ hồ.
Từ kính AI đến NameTag: nhận diện khuôn mặt và cái giá quyền riêng tư
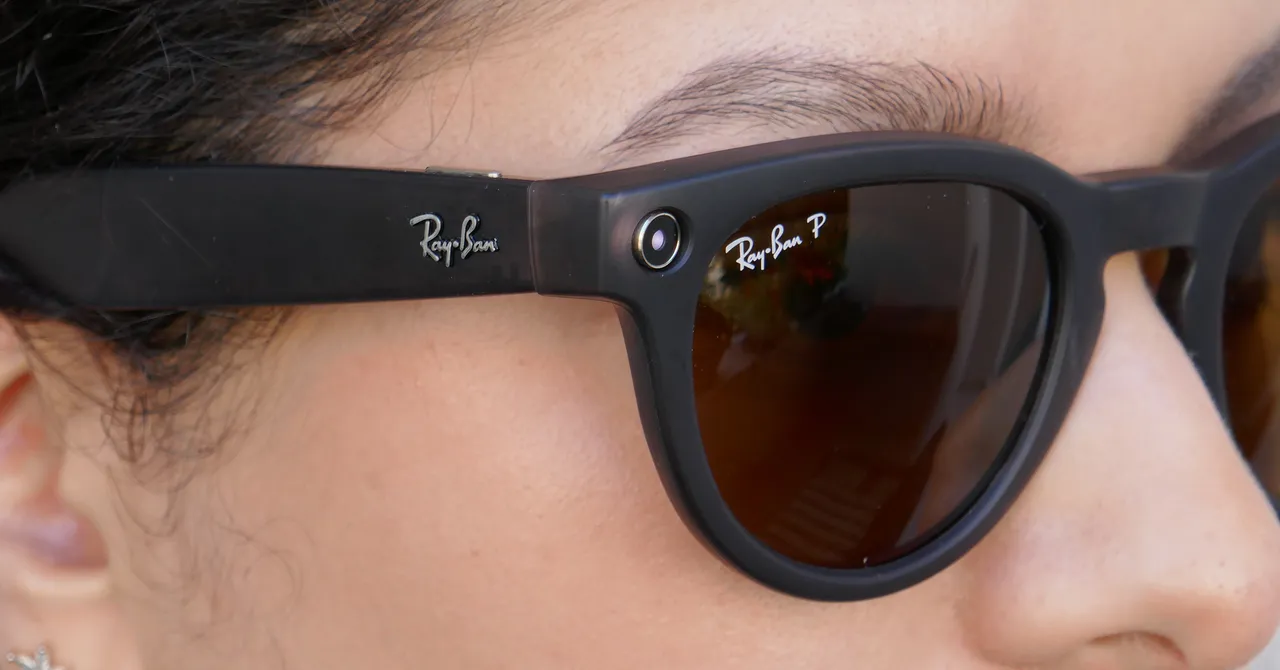
Song song với việc nói nhiều về minh bạch, Meta lại bị kéo vào tâm điểm tranh cãi vì kính AI và hệ thống nhận diện khuôn mặt NameTag. Tại London, kính AI của hãng làm dấy lên lo ngại về độ an toàn của phụ nữ trên tàu điện ngầm và các phương tiện công cộng, vốn đã là điểm nóng quấy rối, với khả năng quay phim kín đáo được xem như mở cửa cho hành vi lạm dụng và bóc lột những người dễ bị tổn thương. Meta nói rằng đèn trắng trên kính sẽ nhấp nháy để báo hiệu đang ghi hình, và khuyên người dùng dừng quay nếu ai đó không thoải mái. Nhưng các chuyên gia cảnh báo thiết kế “kín đáo” khiến nạn nhân không biết mình bị ghi hình, thúc đẩy lời kêu gọi siết chặt quy định đối với kính thông minh và công nghệ giám sát, trong đó có nhận diện khuôn mặt trực tiếp.
Ở cấp độ sâu hơn, một nhóm phụ huynh tại Illinois và California đã nộp đơn kiện tập thể lên toà liên bang ở Chicago, cáo buộc Meta dùng trái phép ảnh Facebook và Instagram của họ để xây NameTag – một hệ thống nhận diện khuôn mặt chưa phát hành cho kính thông minh – và để huấn luyện các mô hình tạo sinh Emu và Muse Image. Đơn kiện cho rằng Meta đã vi phạm luật quyền riêng tư của Illinois và California bằng cách trích xuất thông tin sinh trắc học từ ảnh mà không hề thông báo hay xin phép. Dù Meta khẳng định “chưa có gì được tung ra cho người dùng và chưa có quyết định cuối cùng về việc sẽ làm gì ở đây, nếu có” và hứa rằng nếu triển khai sẽ theo cách “thận trọng, minh bạch”, bản thân việc nhúng sẵn mã NameTag trong ứng dụng kính AI lại làm người dùng khó tin vào tuyên bố không xây dựng cơ sở dữ liệu khuôn mặt trung tâm.
Vụ chatbot hỏi về con nhỏ: minh hoạ sống động cho rủi ro dữ liệu AI
Nếu kính AI và NameTag đặt ra câu hỏi về giám sát công cộng, vụ chatbot Meta AI tương tác với một bà mẹ trên Instagram cho thấy rủi ro quyền riêng tư dữ liệu ngay trong đời sống gia đình. Sau khi người dùng Kalie Robins đăng video cùng con gái, hệ thống gợi ý câu hỏi: “Who is the child passenger?”, rồi trong trao đổi tiếp theo, chatbot đưa ra tên, tuổi, chi tiết gia đình, thông tin liên quan đến địa điểm của các con cô, và thậm chí hiển thị lại một bức ảnh mà cô tin rằng đã xóa. Meta thừa nhận prompt này “đi chệch mục tiêu” và nói chatbot chỉ dùng nội dung người dùng vốn đã có quyền truy cập. Tuy nhiên, lời giải thích đó khó trấn an phụ huynh khi AI có thể ghép dữ liệu từ các bài cũ, tài khoản người thân, và nội dung tưởng là đã xoá để xây dựng một “hồ sơ” về trẻ nhỏ.
Sự cố này phơi bày thực tế: trong thế giới Meta AI, “xóa bài” không đồng nghĩa xóa mọi bản sao hoặc mọi tham chiếu từng tồn tại trên mạng xã hội. Robins cho rằng hệ thống dường như kết nối thông tin từ nhiều bài của các thành viên gia đình để dựng chân dung dữ liệu con cô. Meta cho biết đã sửa lỗi gây ra prompt nhạy cảm, nhưng chưa công khai chi tiết cụ thể về thay đổi đối với hệ thống gợi ý hay tần suất sự cố tương tự từng xảy ra. Sự im lặng này làm dày thêm cảm giác rằng người dùng không kiểm soát được cách dữ liệu cá nhân – đặc biệt là dữ liệu về trẻ em – được dùng trong lợi dụng dữ liệu AI cho sản phẩm mới.
Khi “minh bạch” va vào lợi dụng dữ liệu: niềm tin bị bào mòn
Tự thân Meta khẳng định các cáo buộc trong vụ kiện là “vô căn cứ” và nói rằng họ đã minh bạch về cách sử dụng thông tin người dùng để xây dựng và cải thiện sản phẩm AI. Nhưng việc chính người dùng gần như không có lựa chọn thực chất về chuyện dữ liệu ảnh, video, khuôn mặt có được đưa vào tập huấn luyện hay không khiến tuyên bố Meta AI minh bạch trở nên khó thuyết phục. Công ty thừa nhận đã dùng lượng lớn ảnh và văn bản từ Facebook, Instagram để huấn luyện Emu, coi đây là “lợi thế dữ liệu” cho hệ thống AI của mình. Khi “lợi thế dữ liệu” đồng thời bị cáo buộc là quá trình thu hoạch bất hợp pháp thông tin sinh trắc học xuất hiện trong ảnh, khoảng cách giữa thông điệp minh bạch và thực tiễn lợi dụng dữ liệu AI càng rõ.
Ở cấp người dùng, bức tranh hiện lên đầy mâu thuẫn: Instagram siết nhãn hồ sơ AI để tăng minh bạch danh tính, kính AI được quảng cáo có đèn báo ghi hình bảo vệ quyền riêng tư dữ liệu, và Meta hứa hẹn tiếp cận “thận trọng” với NameTag. Nhưng cùng lúc, các hệ thống AI âm thầm nối lại ảnh tưởng đã xoá, trích xuất khuôn mặt trong kho ảnh khổng lồ, và vận hành thuật toán mà người dùng không được giải thích ở mức chi tiết. Chừng nào Meta chưa chuyển từ minh bạch phần nổi sang chịu trách nhiệm với cách thu thập, lưu trữ, và xử lý dữ liệu ở tầng sâu, mọi nhãn hồ sơ AI hay phát ngôn về “không xây dựng cơ sở dữ liệu khuôn mặt trung tâm” sẽ chỉ giống lớp sơn PR mỏng, khó có thể cứu vãn niềm tin đã sứt mẻ của cộng đồng.