
Kimi hấp dẫn về chi phí, nhưng không thắng mọi phép so sánh
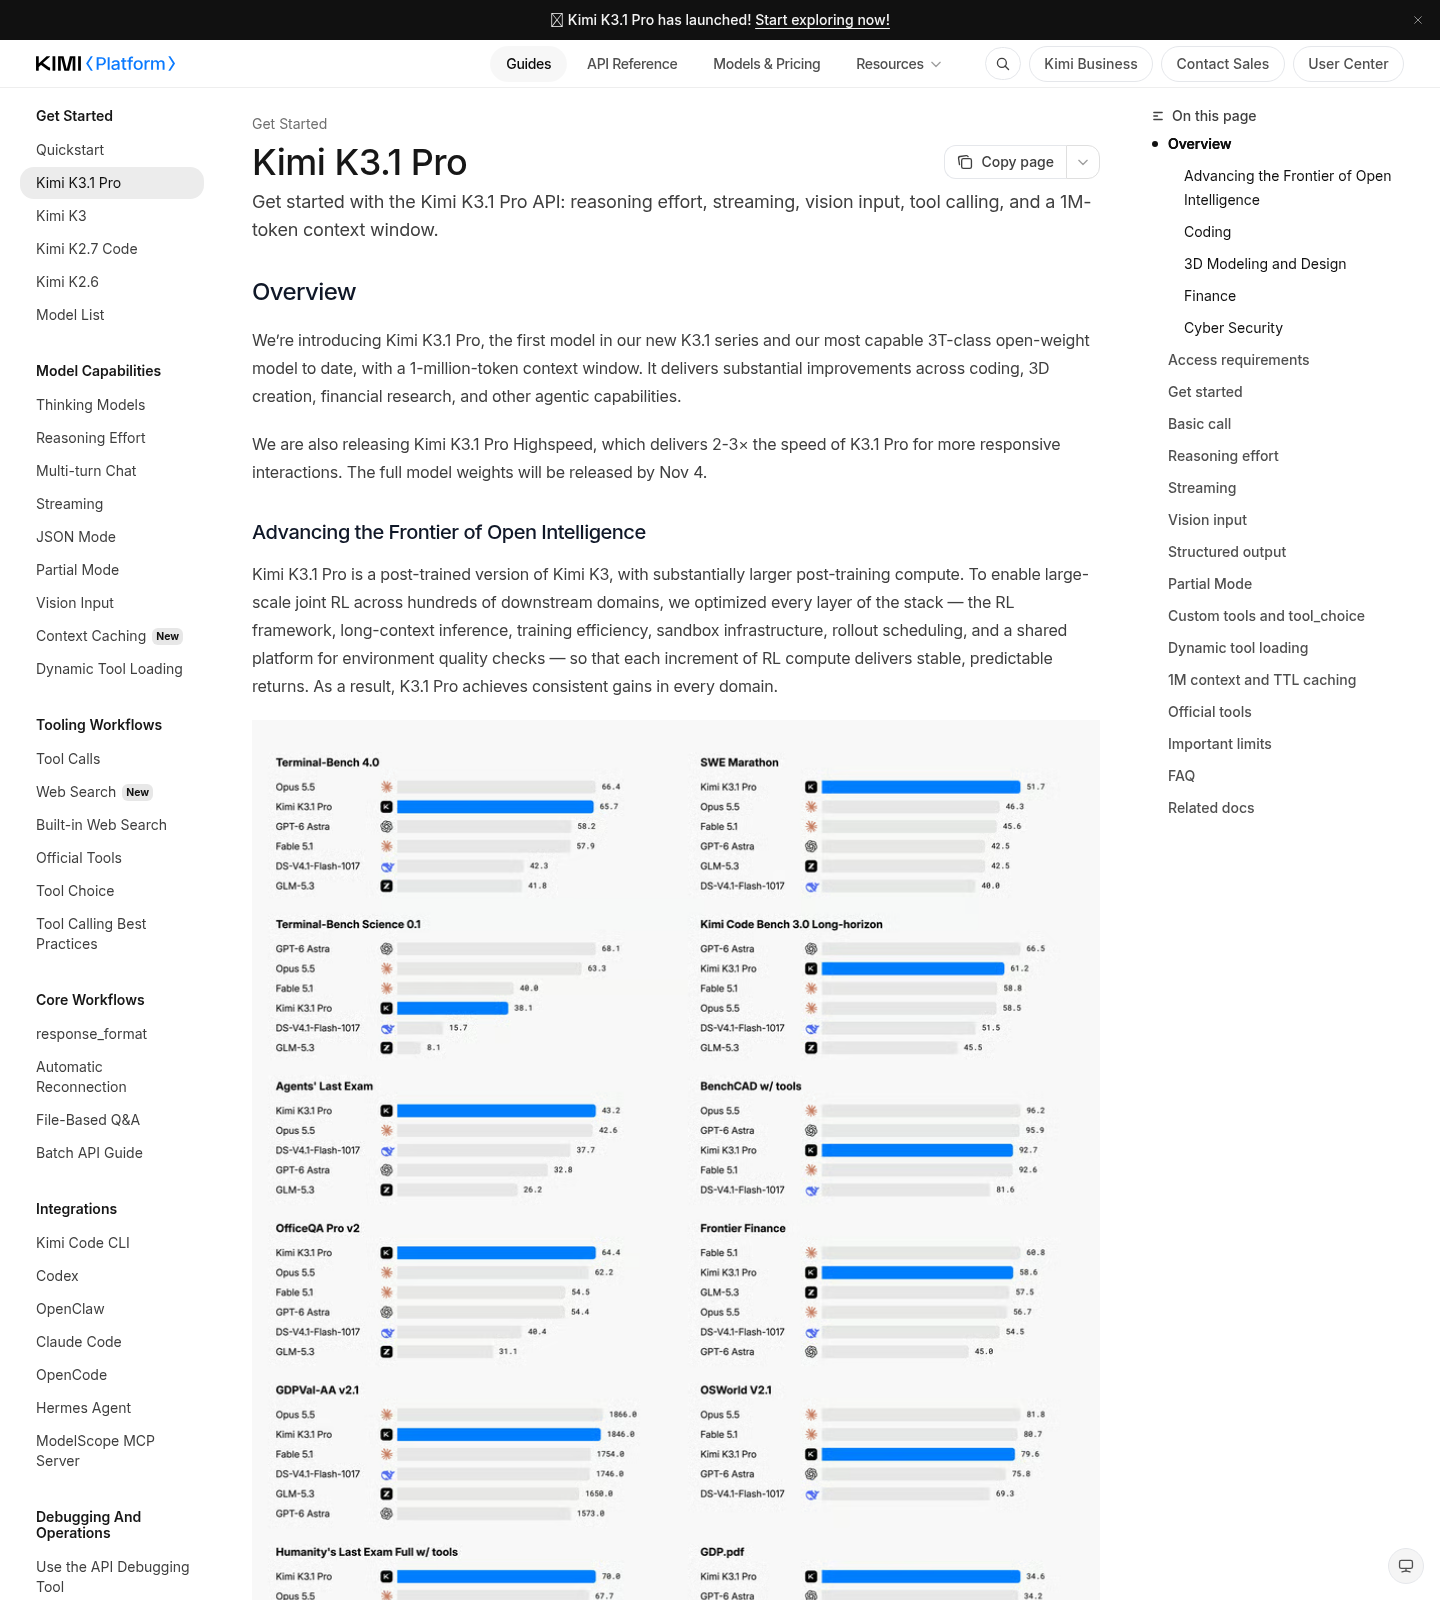
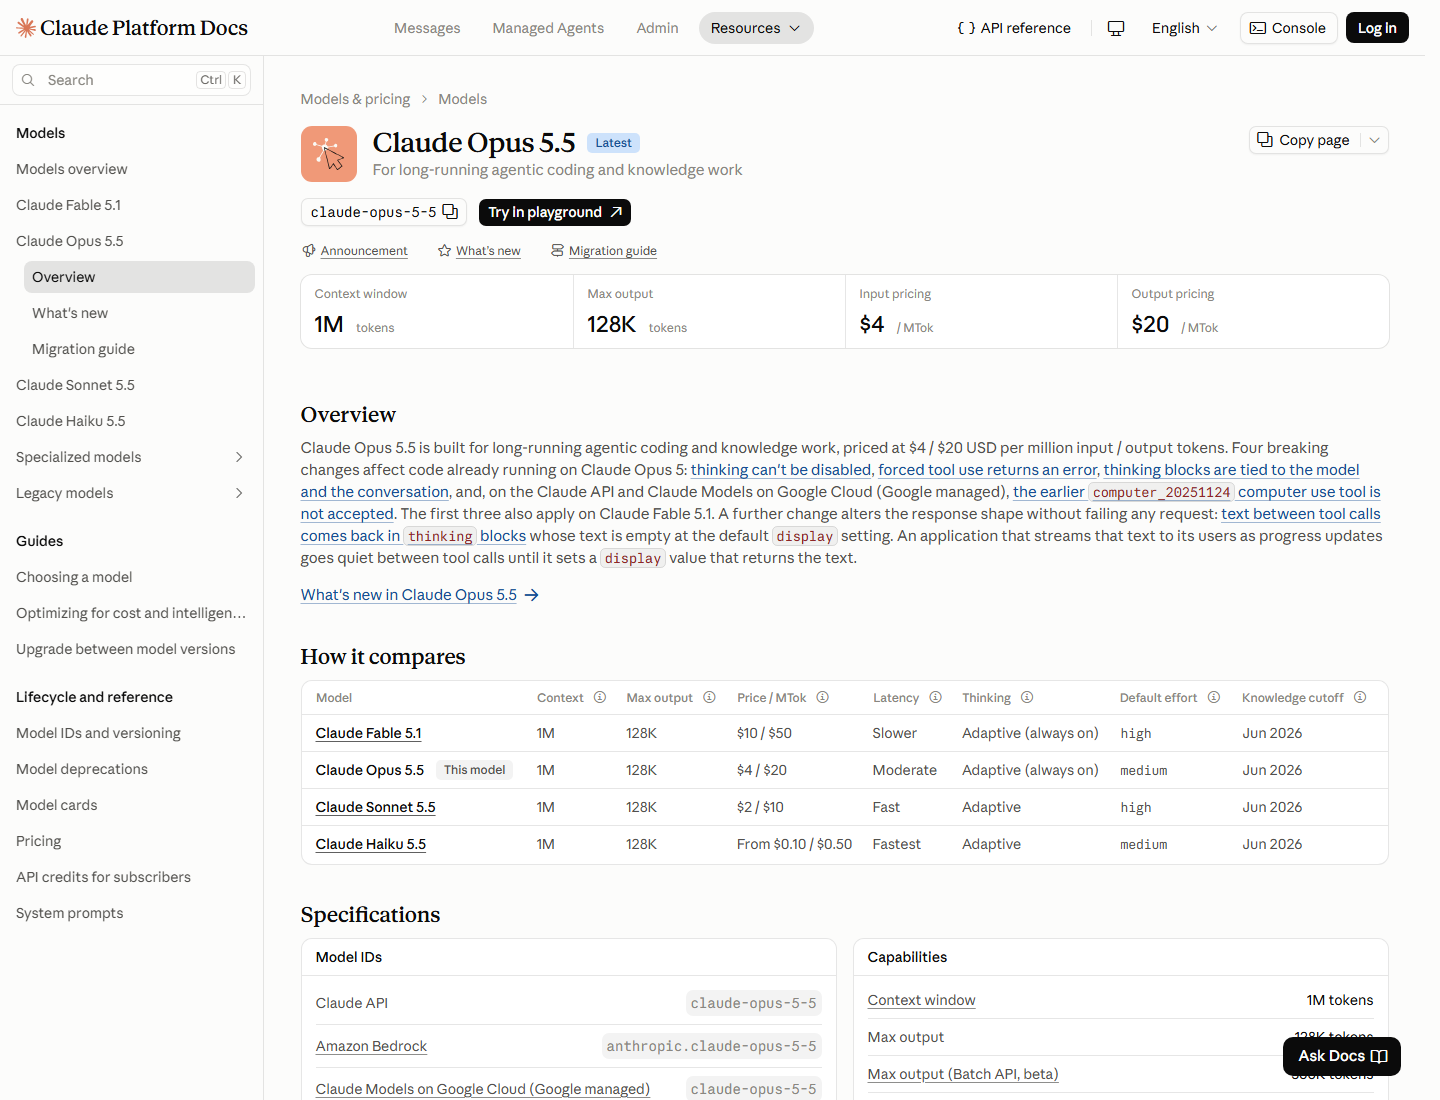
Kimi K3.1 Pro là mô hình trí tuệ nhân tạo của Moonshot, được tinh chỉnh từ Kimi K3 để xử lý các tác vụ suy luận và tác tử với cửa sổ ngữ cảnh dài, chứ không phải một kiến trúc hoàn toàn mới. Trong so sánh mô hình AI, điểm thu hút của Kimi là giá theo token thấp hơn Claude Opus 5.5, còn điểm cần dè chừng là lợi thế đó không tự động biến thành chi phí thấp hơn cho mọi tác vụ. Kimi và Claude đều hỗ trợ một triệu token ngữ cảnh; trên Terminal-Bench 4.0, Kimi đạt 65,7% còn Claude đạt 66,4%, chênh 0,7 điểm nghiêng về Claude. Hai điểm số được thực hiện ở các cài đặt khác nhau, nên không thể xem đây là một cuộc đối đầu hoàn toàn đồng nhất. Kết luận hợp lý: Kimi đáng thử khi ngân sách và ngữ cảnh dài là ưu tiên, nhưng điểm benchmark không đủ để tuyên bố mô hình này hơn Claude.
| Tiêu chí | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Cửa sổ ngữ cảnh | Một triệu token | Một triệu token |
| Mức giá theo token | Thấp hơn | Cao hơn; giá Claude Opus được nêu là gấp đôi Kimi |
So với Grok, kết quả phụ thuộc vào bài kiểm tra
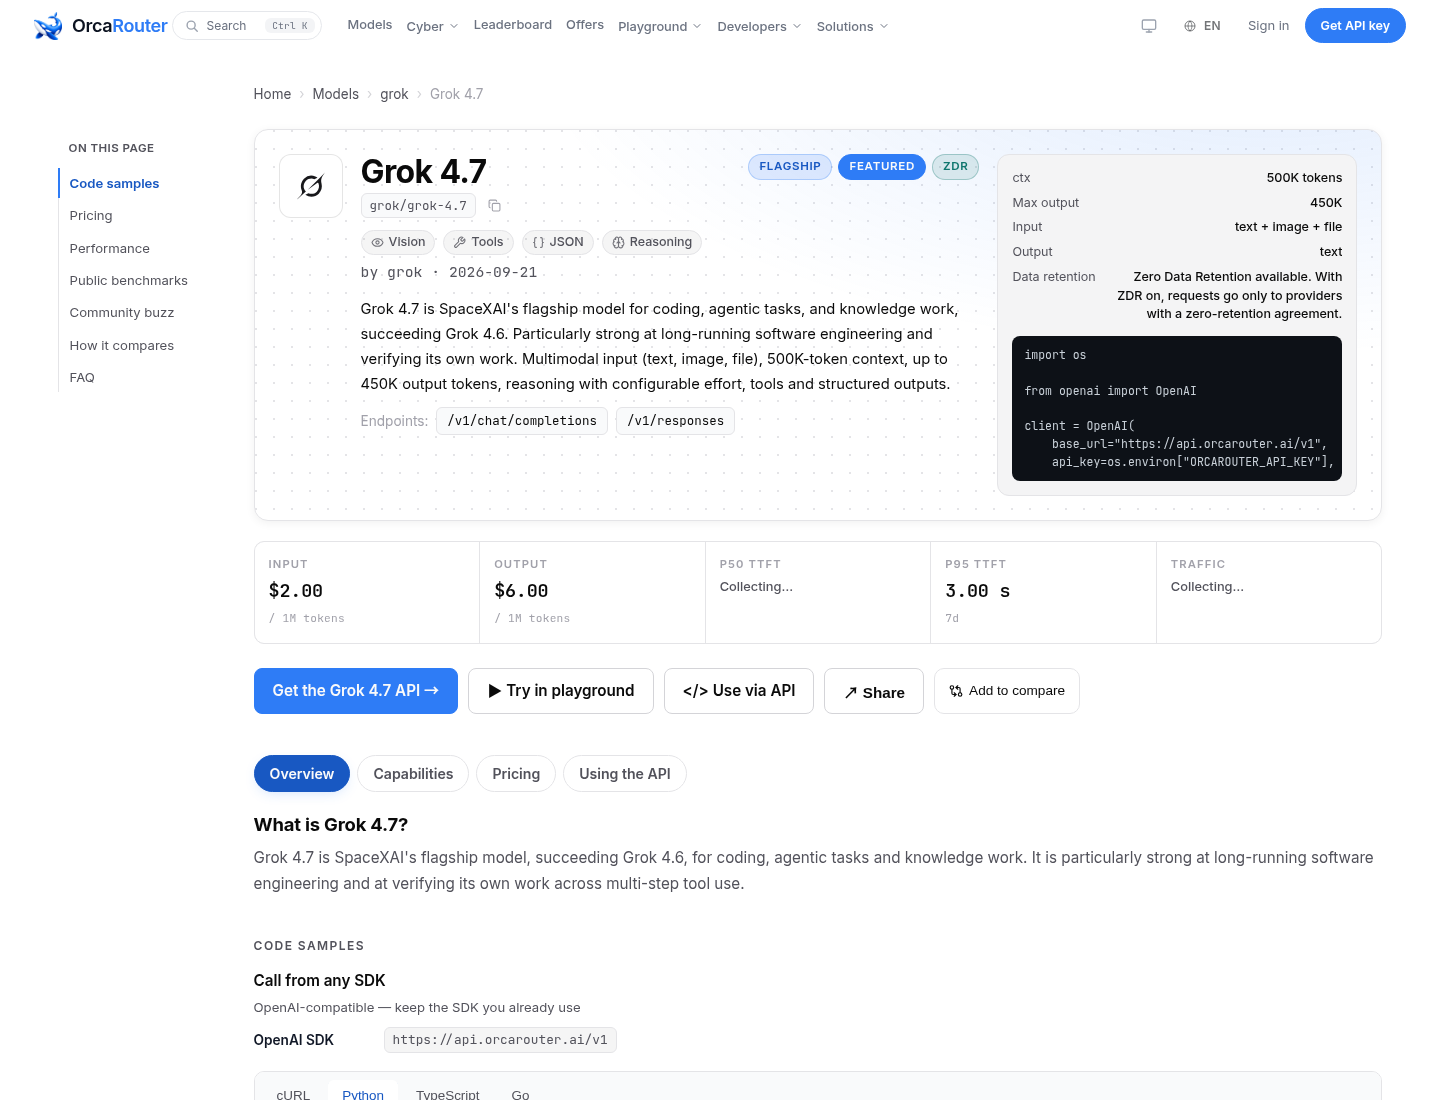
Với Grok 4.7, Kimi không có ưu thế chính xác nhất quán. Trong một bài kiểm tra phân tích dữ liệu gồm 43 câu hỏi trên bộ dữ liệu tổng hợp, cả hai đạt 42 điểm và cùng xếp đồng hạng ba trong số 34 mô hình. Tuy nhiên, một lượt chạy của Grok tốn kém hơn 72% so với lượt chạy Kimi trong bài kiểm tra đó. Đây là phép so sánh trực tiếp hữu ích, nhưng chỉ phản ánh một loại công việc và một lần chạy, không phải mức chi phí phổ quát. Các kết quả khác còn cho thấy thứ hạng có thể đảo chiều: trong đánh giá kế toán của DualEntry, Grok đạt 88,1% và Kimi đạt 86,1%. Với benchmark Grok 4.7 trên Terminal-Bench 4.0, số liệu do các bên tự công bố chênh lệch lớn, nhưng 65,7% của Kimi và 38,0% của Grok đến từ các phòng thí nghiệm khác nhau; cùng tên benchmark không bảo đảm cùng điều kiện đo. Vì vậy, một con số riêng lẻ không thể phân định mô hình nào tốt hơn.
Chi phí, tốc độ và benchmark không kể hết câu chuyện
Kimi có thể hấp dẫn với khối lượng công việc đọc nhiều, nhưng mức tiết kiệm theo token không đồng nghĩa tiết kiệm tương ứng cho mỗi tác vụ hoàn thành. Kimi mặc định suy luận ở mức tối đa, trong khi Claude Opus 5.5 mặc định ở mức trung bình; lượng token suy luận phát sinh vì thế có thể làm thay đổi hóa đơn thực tế. Mức chênh giá được công bố là giá theo token, không phải giá theo tác vụ. Tốc độ cũng có thể làm thay đổi lựa chọn: số đo được nêu cho Kimi là thời gian trung vị đến token đầu tiên 6,9 giây, ở tốc độ 48 token mỗi giây; Grok được thử nghiệm bên thứ ba ghi nhận khoảng 1,3 giây và khoảng 61 token mỗi giây. Khoảng cách đó đáng lưu ý với ứng dụng tương tác hoặc chuỗi tác vụ tuần tự, nhưng không quyết định chất lượng ở mọi tình huống. Benchmark, tốc độ và chi phí đều phụ thuộc vào tác vụ, thiết lập, lượng token sử dụng và cách tính hóa đơn.
Chọn theo công việc và mức sử dụng thực tế
Không có người thắng chung cho mọi nhu cầu: hai bài kiểm tra trung lập cho Kimi và Grok cho kết quả gần ngang bằng, nhưng thứ hạng đảo chiều giữa các bài. Thay vì chọn theo điểm cao nhất trên một bảng, hãy xác định mô hình sẽ đọc nhiều tài liệu, tạo nhiều đầu ra hay phải phản hồi nhanh; sau đó đo chi phí và chất lượng trên chính quy trình của bạn.
- Chọn Kimi K3.1 Pro nếu cần xử lý ngữ cảnh dài, rà soát hợp đồng, nghiên cứu tài chính, phân tích kho lưu trữ nhiều tệp hoặc kiểm toán chất lượng dữ liệu.
- Chọn Grok 4.7 nếu độ trễ thấp là yêu cầu sản phẩm, chẳng hạn với trợ lý lập trình tương tác, tác nhân trong môi trường phát triển hoặc công cụ phục vụ khách hàng.
- Cân nhắc Claude Opus 5.5 nếu kết quả Terminal-Bench 4.0 và lựa chọn mô hình suy luận phù hợp quy trình quan trọng hơn chênh lệch chi phí theo token.
- Trước khi quyết định, hãy thử trên tác vụ thật và theo dõi lượng token, độ chính xác, tốc độ lẫn chi phí theo mức sử dụng của bạn; đừng coi giá token hay một benchmark riêng là đại diện cho toàn bộ công việc.
Tóm lại, Kimi K3.1 Pro đáng chọn khi công việc thiên về đọc, cần ngữ cảnh rộng và lợi thế chi phí theo token có ý nghĩa trong cách bạn sử dụng. Grok hợp hơn khi phản hồi nhanh là thiết yếu; Claude vẫn có thể là lựa chọn phù hợp nếu ưu tiên kết quả của bài kiểm tra chung được nêu. Hãy chọn theo loại tác vụ và mức sử dụng thực tế, không theo một con số hấp dẫn đứng riêng lẻ.