
Bức tranh chung: chi phí API mô hình AI so với mô hình cục bộ
Chi phí API mô hình AI là tổng số tiền bạn trả cho mỗi lần gửi token lên dịch vụ đám mây, trong khi triển khai mô hình cục bộ là cách bạn tải trọng số về máy của mình và trả bằng phần cứng, điện năng cùng công sức vận hành thay vì trả theo lượt gọi. Ở bài viết này, chúng ta đặt Liquid AI d1-ultra, d1-omni và Mistral Large 4 lên cùng một bàn cân để trả lời câu hỏi thực tế: với khối lượng công việc của bạn, nên thuê API hay chạy mô hình riêng. Kết luận ngắn gọn: d1-ultra phù hợp khi bạn cần quyết định khó, yêu cầu hiệu chuẩn xác suất cao; d1-omni phù hợp khi bạn muốn sở hữu một bộ phân loại đa phương thức chạy cục bộ; Mistral Large 4 là lựa chọn cho các tác vụ ngôn ngữ lớn, ngữ cảnh dài, nhưng chi phí mỗi token cao hơn nên chỉ hợp lý khi giá trị mỗi quyết định đủ lớn.
So sánh thông số cốt lõi: d1-ultra, d1-omni và Mistral Large 4
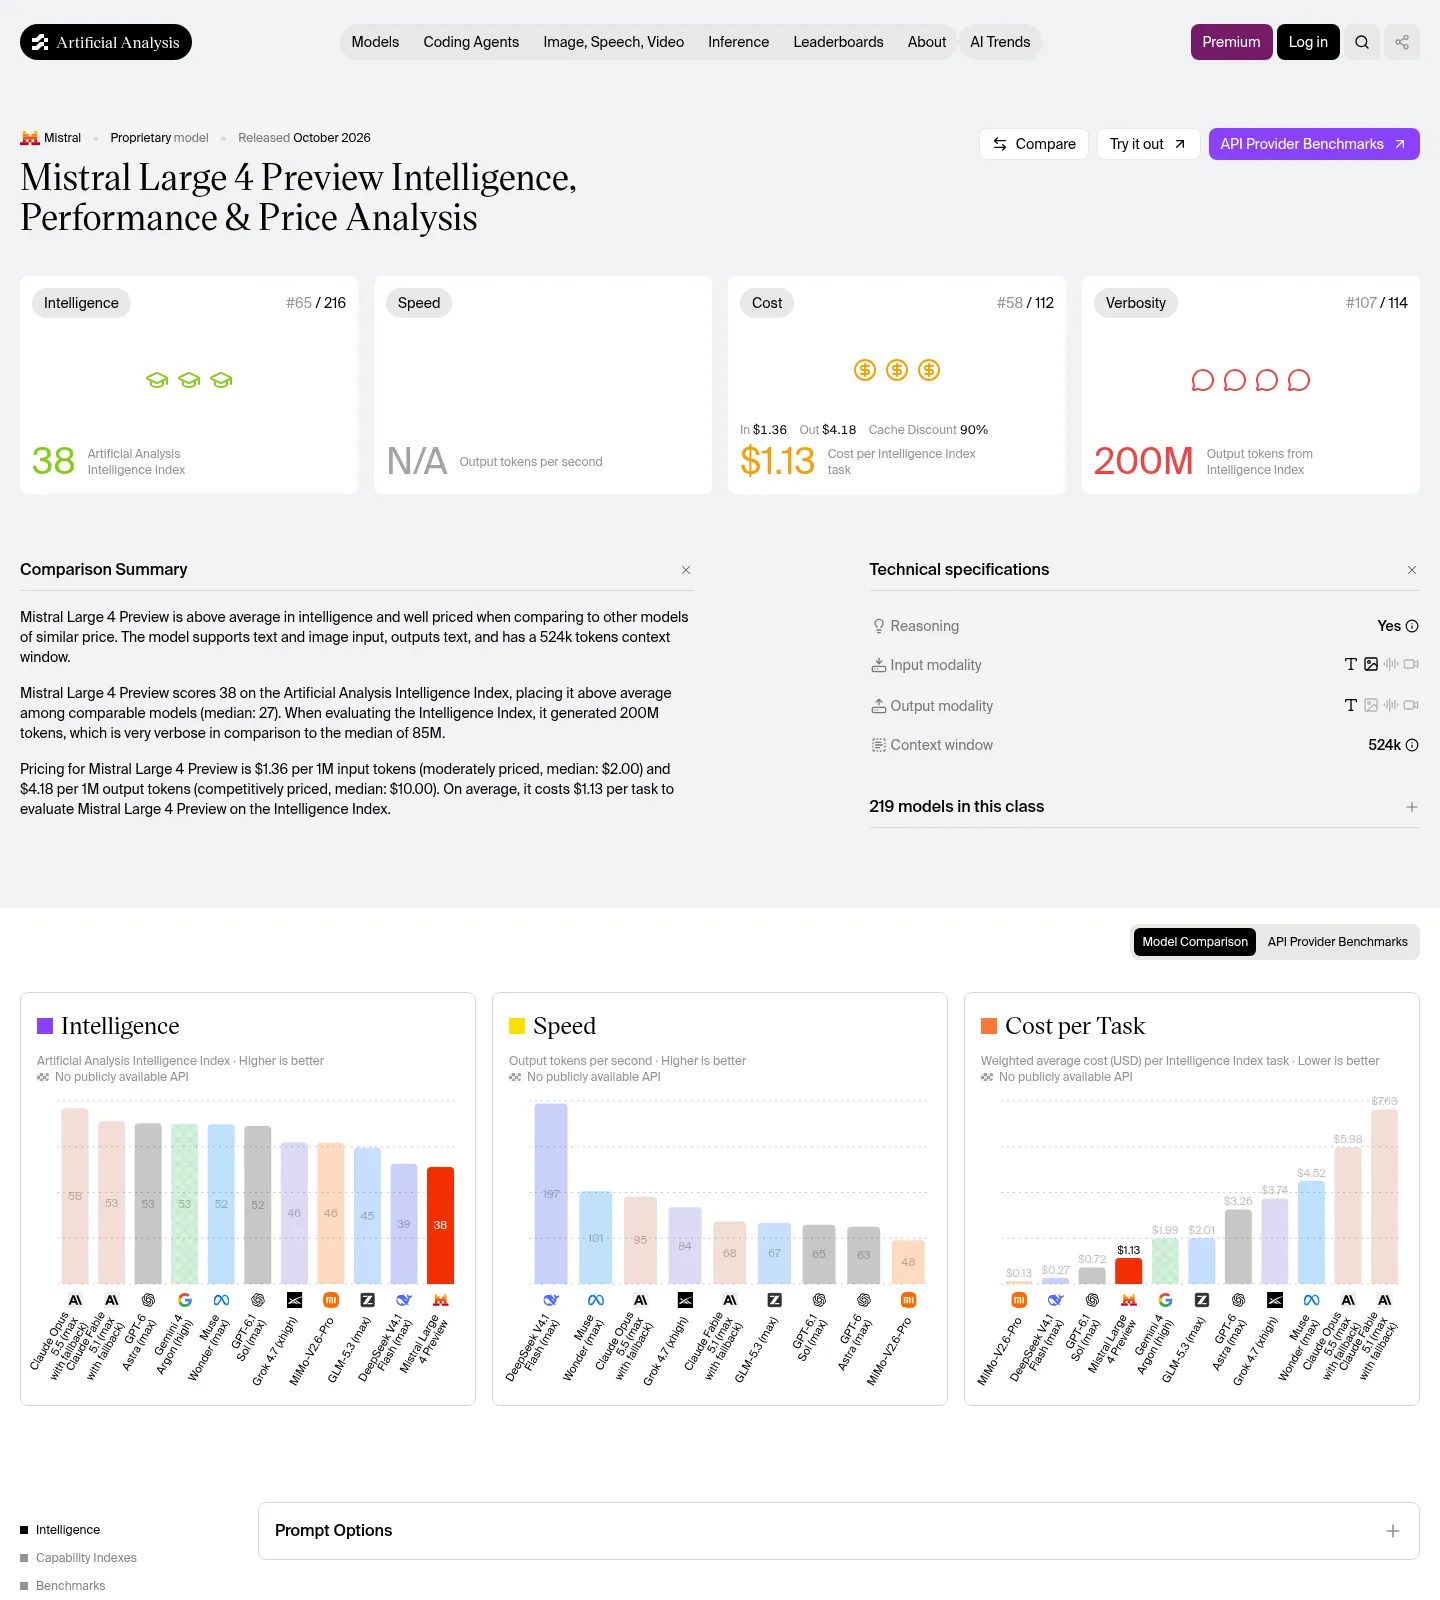
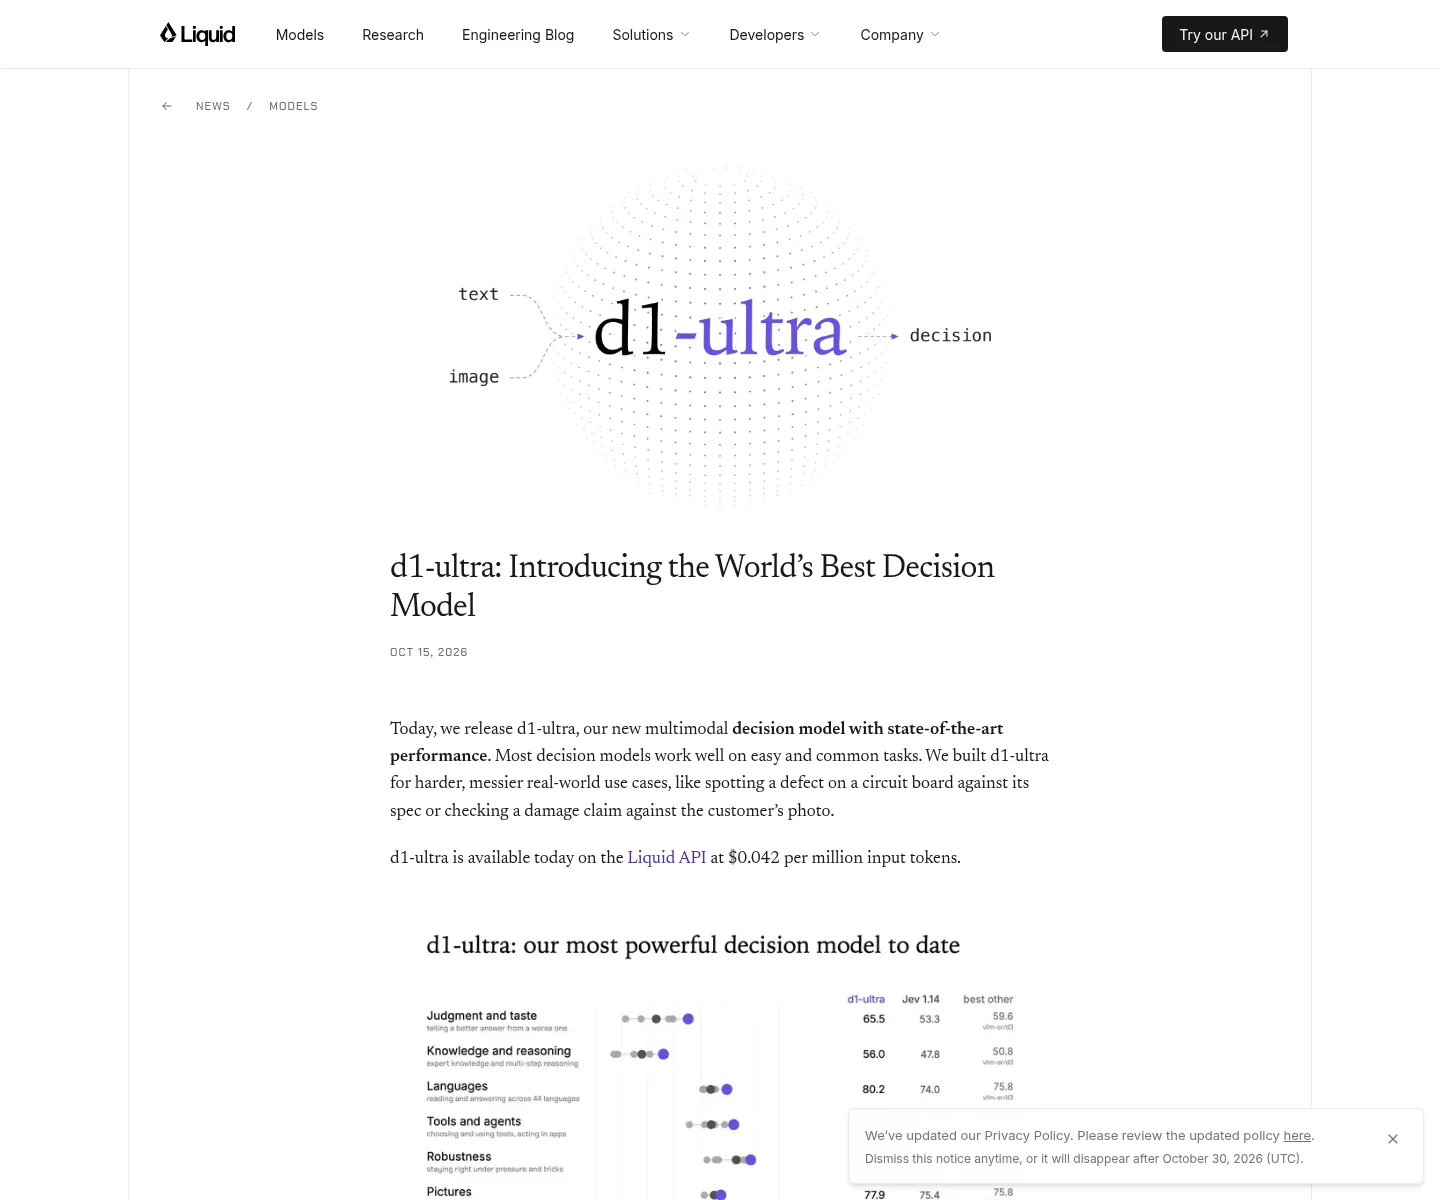
Trước khi bàn về chi phí, cần nhìn rõ ba mô hình này là gì và khác nhau ra sao. Liquid AI d1-ultra là một endpoint API thuần túy, không công bố trọng số, không có bản GGUF hay MLX, và nhà cung cấp chỉ cho phép truy cập qua API duy nhất. d1-omni ngược lại là một tệp trọng số mở, 587 triệu tham số, gồm 381 triệu cho phần thân chia sẻ và đầu quyết định, 94 triệu cho bộ mã hóa thị giác SigLIP2 và 112 triệu cho bộ mã hóa âm thanh, phát hành với các bản dựng GGUF và MLX để chạy cục bộ. Mistral Large 4 là một mô hình ngôn ngữ quy mô rất lớn, với 1,05 nghìn tỷ tham số, ngữ cảnh lên tới 1 triệu token và giá mỗi triệu token đầu vào cao hơn đáng kể so với d1-ultra.
| Thông số | Liquid AI d1-ultra | d1-omni | Mistral Large 4 |
|---|---|---|---|
| Hình thức triển khai | Chỉ API, không tải trọng số | Tệp trọng số mở, chạy cục bộ | API (thường qua nhà cung cấp mô hình lớn) |
| Số tham số | Không công bố | 587M tham số | 1,05T tham số |
| Kiểu tác vụ chính | Ra quyết định (yes/no, nhãn, thang điểm) trong một lượt truyền xuôi, không sinh token | Ra quyết định đa phương thức (văn bản, hình ảnh, âm thanh) trong một lượt truyền xuôi, không sinh token | Mô hình ngôn ngữ lớn sinh văn bản, ngữ cảnh dài |
| Cửa sổ ngữ cảnh | Danh mục bên thứ ba ghi nhận khoảng 32.768 token (chưa được nhà cung cấp xác nhận) | Không nêu rõ trong tài liệu d1-omni | 1.000.000 token |
| Chi phí theo token đầu vào | Tính phí theo số token đầu vào, không tính token đầu ra | Không tính phí theo lượt gọi; chi phí nằm ở phần cứng và vận hành | Giá mỗi triệu token đầu vào cao hơn d1-ultra |
| Khả năng sở hữu / tùy biến | Không thể tự host, không tải trọng số | Có thể tải, tinh chỉnh và triển khai trên hạ tầng riêng | Không trọng số mở, phụ thuộc nhà cung cấp |
Khi nào nên thuê API: d1-ultra và Mistral Large 4 trong bối cảnh chi phí
Thuê API phù hợp khi bạn gọi mô hình vài nghìn lần mỗi tháng và không muốn gánh chi phí vận hành hạ tầng riêng; trong trường hợp đó, endpoint được host có thể rẻ hơn cả cuộc họp nơi bạn bàn chuyện tự host. Với Liquid AI d1-ultra, điểm mạnh không nằm ở việc sinh văn bản mà ở hiệu chuẩn xác suất: mô hình được tinh chỉnh để giảm hiện tượng quá tự tin, trả về xác suất đáng tin cậy hơn cho các quyết định yes/no, nhãn hoặc thang điểm. Đây là lựa chọn đúng khi bản thân quyết định mới là phần khó, ví dụ các câu hỏi nặng về kiến thức, các khẳng định trực quan cần đối chiếu với ngữ cảnh thực tế như lỗi bo mạch hay khớp khiếu nại hư hỏng với ảnh khách hàng, hoặc các trường hợp đuôi dài nơi độ tự tin của mô hình nhỏ không đủ. Mistral Large 4, với 1,05 nghìn tỷ tham số và ngữ cảnh 1 triệu token, phù hợp cho các ứng dụng cần phân tích tài liệu rất dài hoặc tác vụ ngôn ngữ phức tạp, nhưng chi phí mỗi token cao hơn nên chỉ đáng dùng khi mỗi yêu cầu mang lại giá trị kinh tế lớn.
Khi nào nên triển khai mô hình cục bộ: d1-omni và bài toán điểm hòa vốn
Triển khai mô hình cục bộ nghĩa là bạn tải trọng số về và chạy trên phần cứng của mình; chi phí của d1-omni chính là phần cứng bạn đã có cộng thêm công sức duy trì nó vận hành. d1-omni là một tệp bạn chạy, không có giá theo từng lượt gọi, nên càng nhiều lượt suy luận, chi phí biên càng tiến về gần 0, đặc biệt với khối lượng lớn như phân loại hộp thư đến, định tuyến lệnh thoại hay gắn cờ tin đăng để con người xem xét. Một ví dụ cụ thể: với một lượt chạy hằng đêm trên 25.000 trang đăng bán sản phẩm, mỗi trang có một ảnh 1024×1024 và khoảng 200 token văn bản, đặt hai câu hỏi cho mỗi trang, tổng số token đầu vào rơi vào khoảng 86,8 triệu; nếu trả bằng API d1-ultra, chi phí mỗi lượt chạy chỉ ở mức vài đơn vị tiền tệ, và một tháng sẽ là vài trăm đơn vị. Điều này cho thấy điểm hòa vốn không chỉ phụ thuộc vào số lượt gọi mà còn vào việc bạn có sẵn hạ tầng và đội ngũ để vận hành mô hình cục bộ hay không.
Những điểm mù và cách ra quyết định thực tế
Cả ba lựa chọn đều có những điểm mù mà nhà phát triển phải tự đo đạc. Liquid AI d1-ultra không công bố số lượng tham số và không có số liệu độ trễ, nên bạn không thể đánh giá chi phí trên mỗi token tương quan với quy mô công việc hoặc thiết kế luồng tương tác mà không đo thử. d1-omni cũng không công bố các con số suy luận chi tiết, nên phép tính thuê so với sở hữu có một vế chỉ có thể lấp bằng benchmark trên chính phần cứng của bạn. Thêm vào đó, chưa ai đưa d1-ultra và d1-omni qua cùng một khung kiểm thử chung, nên mọi so sánh hiệu năng đều chỉ là suy luận. Khi cân nhắc chi phí API mô hình AI so với triển khai mô hình cục bộ, bạn cần tính cả chi phí hạ tầng, độ trễ và khả năng cập nhật mô hình: nếu pipeline bị giới hạn bởi độ trễ hơn là độ chính xác, việc thiếu số liệu độ trễ trên API đắt tiền là một rủi ro lớn, và cách duy nhất để biết là đo trên workload thực tế của bạn.
Buy if / Skip if
- Buy the Liquid AI d1-ultra if bạn cần quyết định khó, nặng về kiến thức hoặc thị giác, nơi hiệu chuẩn xác suất là yêu cầu quan trọng và khối lượng gọi mỗi ngày không quá lớn.
- Skip the Liquid AI d1-ultra if pipeline của bạn bị giới hạn bởi độ trễ, bạn không chấp nhận mô hình không công bố thông số và không muốn phụ thuộc hoàn toàn vào một endpoint API.
- Buy the d1-omni if bạn có sẵn GPU/CPU phù hợp, cần phân loại khối lượng lớn, rủi ro thấp trên thiết bị và muốn giảm chi phí biên về gần 0 khi số lượt suy luận tăng.
- Skip the d1-omni if bạn không có đội ngũ vận hành mô hình, không muốn xử lý cập nhật trọng số và cần một giải pháp "gọi là chạy" với SLA rõ ràng.
- Buy the Mistral Large 4 if bạn cần ngữ cảnh 1M token, xử lý tài liệu rất dài hoặc tác vụ ngôn ngữ phức tạp nơi mô hình cực lớn mang lại giá trị kinh tế cao cho mỗi yêu cầu.
- Skip the Mistral Large 4 if workload của bạn chủ yếu là quyết định ngắn, lặp lại nhiều lần, nơi chi phí mỗi token cao sẽ nhanh chóng vượt ngân sách.