
NVHBM là gì và tại sao NVIDIA chọn thời điểm này?
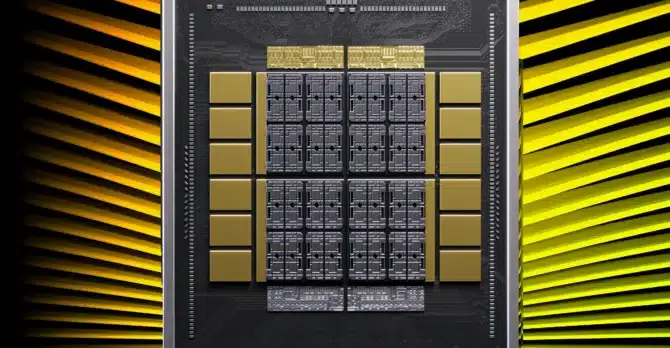
NVIDIA NVHBM memory là một kiến trúc bộ nhớ HBM GPU technology tùy chỉnh được thiết kế riêng cho AI accelerator memory, trong đó bộ điều khiển không nằm trên die tính toán như HBM chuẩn mà chuyển sang base die của bộ nhớ nhằm tăng băng thông, giảm điện năng và giải phóng diện tích silicon cho năng lực tính toán trên GPU. NVHBM được NVIDIA công bố như nền tảng bộ nhớ cho các bộ tăng tốc AI dùng NVLink Fusion và cho cả thế hệ GPU tương lai. Điểm cần nhấn mạnh: đây không phải phát minh hoàn toàn mới, mà là một dạng custom HBM architecture, đi theo xu hướng chung của ngành nơi HBM tiêu chuẩn dần nhường chỗ cho thiết kế theo nhu cầu khách hàng. Custom-HBM được mô tả là “the next big thing” tại hội nghị Hot Chips, cho thấy thời điểm NVIDIA tham gia không phải tình cờ mà là phản ứng mang tính chiến lược với làn sóng bộ nhớ tùy chỉnh đang nổi lên.
NVHBM khác HBM truyền thống ở đâu – và có đáng gọi là đột phá?
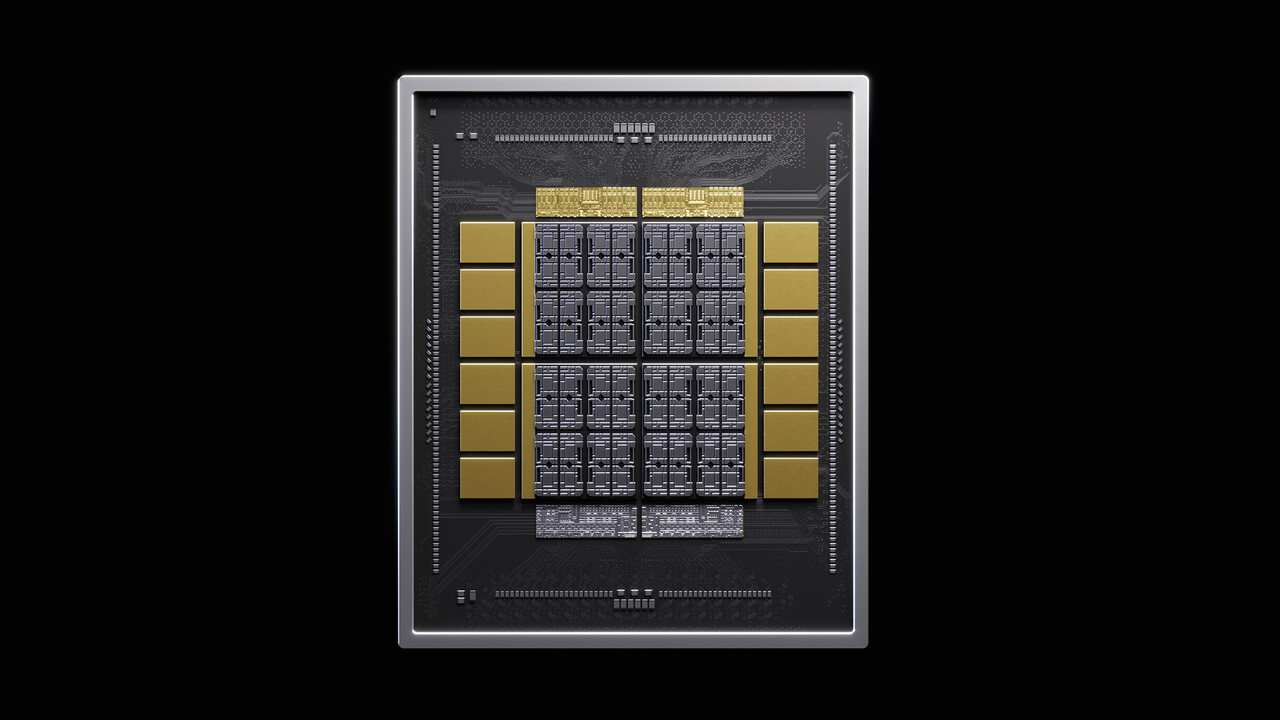
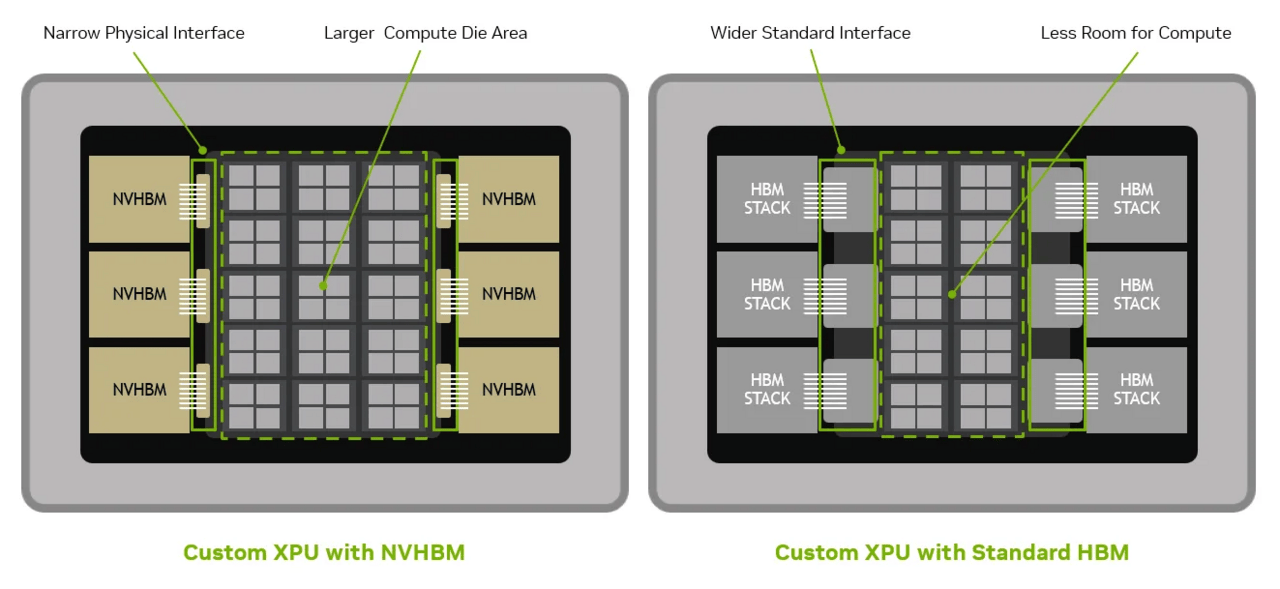
Về mặt kỹ thuật, NVHBM đảo vai trò giữa GPU và bộ nhớ: thay vì để bộ điều khiển HBM nằm trên die tính toán, NVIDIA đặt nó vào base die của stack bộ nhớ. Điều này thu hẹp giao diện giữa GPU và bộ nhớ, cắt giảm tới 67% diện tích dành cho PHY và các khối hỗ trợ so với chuẩn JEDEC HBM4e, đồng thời giúp đơn giản hóa việc routing trên interposer và mang lại đến 80% diện tích silicon hữu dụng hơn trên toàn package. Theo tài liệu kỹ thuật, "NVHBM có thể tăng băng thông bộ nhớ tối đa 30% mỗi stack và giảm 15% điện năng tiêu thụ so với HBM4e". Tuy nhiên, như một nguồn phân tích đã chỉ ra, những con số này gần với các đề xuất custom HBM trước đó từ các nhà cung cấp PHY và controller, nghĩa là NVHBM là bước gia nhập cuộc chơi custom HBM hơn là cuộc cách mạng công nghệ.
Tái cấu trúc HBM: lợi thế thực tế cho GPU AI là gì?
Điểm hấp dẫn thực sự của NVIDIA NVHBM memory không chỉ nằm ở vài phần trăm băng thông hay điện năng, mà ở việc giải phóng không gian cho năng lực tính toán trên GPU. Thiết kế interface hẹp hơn cho phép die tính toán AI ở trung tâm mở rộng vào khu vực vừa được giải phóng, với các nguồn kỹ thuật ghi nhận mức tăng diện tích silicon khả dụng cho compute có thể đạt khoảng 25–30%. Về thực tế, điều này dịch thành nhiều đơn vị tính toán hơn, thêm các khối xử lý chuyên dụng hoặc GPU-die bổ sung trên cùng một package, tất cả đều bám chặt nhu cầu huấn luyện và suy luận mô hình AI ngày càng lớn. NVHBM vì vậy là công cụ để NVIDIA đẩy các GPU flagship và workstation chuyên nghiệp lên một bậc mới về mật độ compute, thay vì chỉ là nâng cấp bộ nhớ đơn lẻ. Đó là bước tiến mang tính "thiết kế hệ thống", nơi bộ nhớ và NVLink Fusion kết hợp thành một nền tảng AI accelerator memory đồng nhất.
Không phải phát minh mới: NVIDIA nhập cuộc custom HBM như thế nào?
Dù được đặt tên riêng là NVHBM, bản chất công nghệ này phù hợp nhận xét "là vật liệu quen thuộc được sắp xếp lại theo cách khác" trong thế giới custom HBM. Các hãng chuyên về controller và PHY đã trình bày chi tiết mô hình chuyển logic bộ nhớ sang base die và thu hẹp giao diện từ trước, với những con số về diện tích compute tăng thêm khá tương đồng. NVIDIA vì thế không đi một mình, mà bước vào dòng chảy chung để cùng định hình chuẩn thiết kế bộ nhớ HBM thế hệ mới. Điểm khác là NVIDIA gắn NVHBM chặt với NVLink Fusion. Khách hàng mua nền tảng này thực chất mua một "bản thiết kế" hoàn chỉnh: bộ nhớ custom HBM architecture + interconnect NVLink, thay vì tự ghép các mảnh rời. Amazon Annapurna Labs là đối tác đầu tiên, phát triển Trainium4 hỗ trợ NVLink Fusion và NVLink 6 để các accelerator Amazon và GPU NVIDIA có thể hoạt động trong cùng kiến trúc ở cấp rack. Đây là chiến lược khóa hệ sinh thái quanh thiết kế của NVIDIA hơn là cuộc chơi công nghệ thuần túy.
Tác động dài hạn lên GPU flagship và workstation NVIDIA
Ở thời điểm công bố, NVHBM vẫn nằm trên giấy, chưa xuất hiện trong sản phẩm thương mại nào. Các chip AI Vera Rubin hiện tại của NVIDIA vẫn dùng HBM4 tiêu chuẩn, nhưng nhiều phân tích cho rằng NVHBM sẽ được đưa vào các thế hệ GPU tương lai như dòng Feynman, dự kiến ra mắt vào năm 2028, hoặc trong một đợt làm mới của dòng Vera Rubin. Điều này đồng nghĩa những GPU flagship và workstation chuyên nghiệp tiếp theo của hãng rất có thể xem NVHBM là cấu phần cơ bản. Việc chuyển sang custom HBM cũng đánh dấu bước ngoặt: bộ nhớ không còn là thành phần thay thế đơn giản theo chuẩn, mà là phần của kiến trúc đồng thiết kế giữa NVIDIA, các hãng bộ nhớ và đối tác cloud. Được ràng buộc với NVLink Fusion, NVHBM sẽ hình thành nền tảng thiết kế nguyên khối cho các hệ thống AI ở cấp rack, nơi GPU và accelerator bên thứ ba cùng dùng một blueprint bộ nhớ và interconnect. Tác động lên hiệu năng vì vậy sẽ không chỉ thể hiện trong benchmark GPU đơn lẻ, mà trong toàn bộ kiến trúc cụm tính toán AI.