
RTX Spark NPU là gì và vì sao đáng để quan tâm?
RTX Spark NPU là bộ tăng tốc thần kinh tích hợp trong nền tảng laptop Windows RTX Spark, kết hợp CPU ARM, GPU Blackwell và bộ nhớ hợp nhất dung lượng lớn để xử lý các mô hình AI ngay trên thiết bị, giảm phụ thuộc vào đám mây và mở đường cho trải nghiệm AI cục bộ an toàn, riêng tư và ổn định hơn trong đời sống hàng ngày.
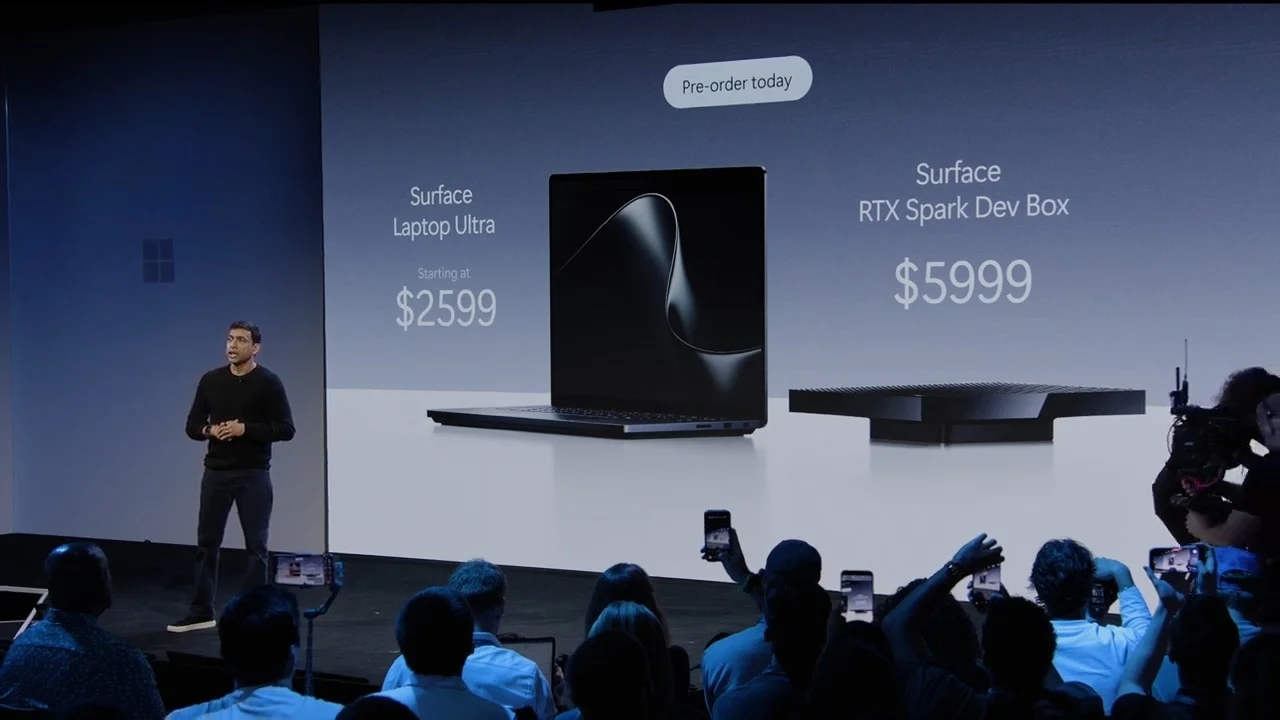
Điểm đáng nói không phải là việc Nvidia đưa NPU lên laptop Windows AI, mà là cách hãng… gần như im lặng về nó. RTX Spark được giới thiệu như một nền tảng laptop Windows kết hợp CPU ARM và GPU Blackwell, nhắm vào AI, sáng tạo nội dung và chơi game. Tính năng nổi bật được nhấn mạnh là khả năng chạy các mô hình AI lớn trực tiếp trên máy, giảm phụ thuộc vào cloud. Nhưng phần NPU – thứ có thể định nghĩa lại trải nghiệm AI cục bộ – lại chỉ được nhắc lướt qua. Theo một nguồn Đức, NPU này là bộ tăng tốc 55 TOPS dành riêng cho các tính năng Copilot+. Việc một phần cứng quan trọng như vậy bị “giấu kỹ” cho thấy chiến lược AI trên PC của Nvidia phức tạp hơn những slide trình chiếu.
Kiến trúc RTX Spark: GPU Blackwell và bộ nhớ hợp nhất phục vụ AI cục bộ
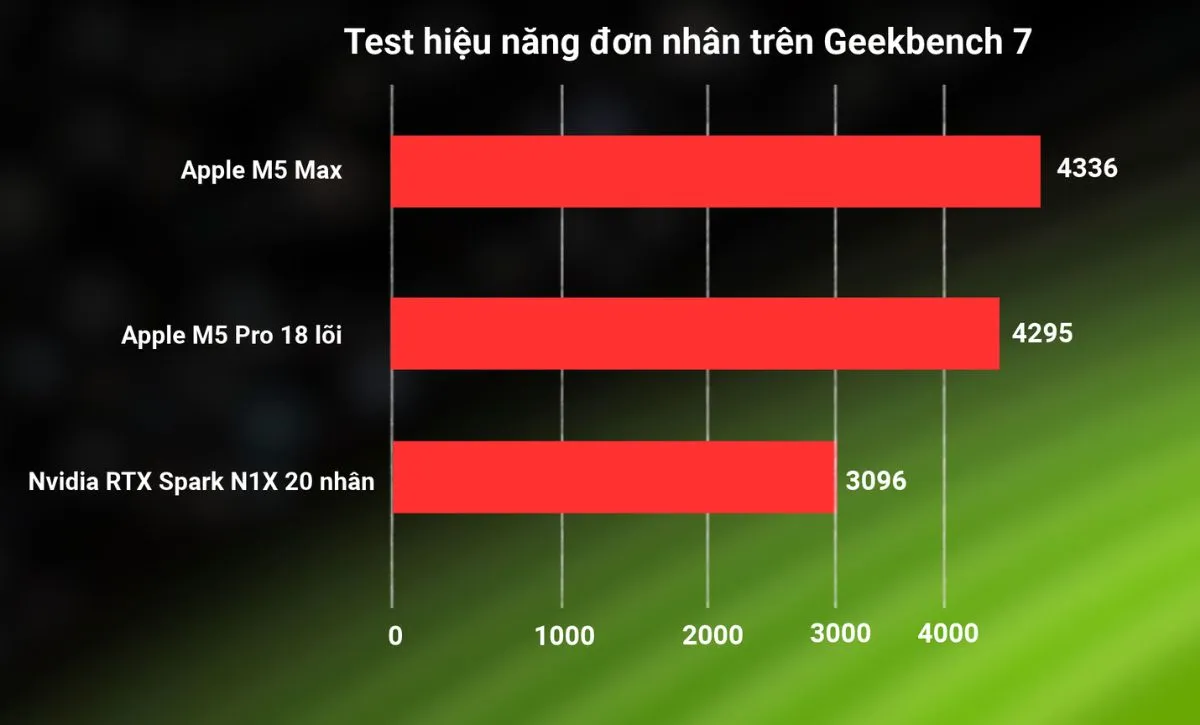
Để hiểu RTX Spark NPU có ý nghĩa gì, cần nhìn vào toàn bộ kiến trúc. RTX Spark là nền tảng laptop Windows AI kết hợp CPU ARM với GPU Blackwell, hướng đến xử lý AI, sáng tạo nội dung và gaming trên cùng một con chip. Bản mẫu RTX Spark N1X dùng CPU 20 nhân và GPU Blackwell với 6.144 nhân CUDA, tích hợp Tensor Core thế hệ 5 cho tăng tốc AI và RT Core thế hệ 4 cho ray tracing. Đây không phải cấu hình “cho vui Copilot”, mà là một GPU Blackwell laptop thực thụ.
Điểm then chốt cho xử lý AI cục bộ là bộ nhớ hợp nhất. Chip RTX Spark dùng LPDDR5X bố trí quanh lõi, dùng chung cho CPU và GPU để xử lý tác vụ AI cục bộ. Bộ nhớ này đạt băng thông tối đa 300 GB/giây và hỗ trợ tới 128 GB RAM, trong đó máy thử nghiệm dùng 64 GB bộ nhớ hợp nhất. Với 64 GB, RTX Spark có thể chạy các mô hình ngôn ngữ với hàng chục tỷ tham số ngay trên laptop. Nói cách khác, GPU Blackwell kết hợp bộ nhớ hợp nhất dung lượng lớn chính là nền móng phần cứng cho xử lý AI phức tạp mà không cần đám mây – và NPU được gắn thêm vào hệ sinh thái đó, chứ không thay thế nó.
Bên trong RTX Spark NPU: phần cứng âm thầm nhưng không hề “ảo”
Nvidia gần như không nói gì về RTX Spark NPU, ngoài thông tin đây là bộ tăng tốc 55 TOPS dành riêng cho Copilot+. Điều này khiến không ít người nghi ngờ đây chỉ là “thiết bị ảo” dựng lên để đạt chứng nhận NPU của Windows. Tuy nhiên, phân tích firmware, driver và công cụ lập trình cho thấy câu chuyện khác hẳn. Bảng ACPI của một mẫu laptop có RTX Spark định nghĩa thiết bị DLA0 với hai vùng thanh ghi riêng: 256 KiB tại 0x19000000 và 64 KiB tại 0x31380000, cùng hai ngắt độc lập. NPU này nằm trên die SoC cùng các khối hiển thị, camera, âm thanh, trong khi GPU là thiết bị PCI tách biệt.
Trên Windows, NPU được liệt kê như một thiết bị riêng, driver dùng MCDM – phiên bản compute-only của mô hình driver hiển thị dành cho bộ tăng tốc không xuất hình. DXCore nhận diện đây là phần cứng NPU, và bộ lập lịch của Windows gán cho nó một engine duy nhất tên NPU_0. Công cụ nvidia-smi thậm chí đếm NPU như một GPU thứ hai, với tên kiến trúc “NPU3”, UUID bắt đầu bằng “DLA-”, xung nhịp độc lập từ 430 MHz tới 1.562 MHz và báo cáo mức tiêu thụ điện riêng. Nói thẳng: đây là một khối phần cứng DLA thực sự, hậu duệ của kiến trúc Deep Learning Accelerator với lõi RISC-V, chứ không phải vài Tensor Core bị đổi tên.
Thực chiến: RTX Spark xử lý AI cục bộ trên laptop Windows ra sao?
Điểm thuyết phục nhất của RTX Spark không nằm ở slide marketing mà ở các bài test xử lý AI cục bộ. Với 64 GB bộ nhớ hợp nhất, nền tảng này có thể chạy mô hình ngôn ngữ với hàng chục tỷ tham số ngay trên laptop. Trong bài test AgentPerf Local mô phỏng tác vụ AI nhiều bước như phân tích yêu cầu và viết code, RTX Spark dùng mô hình Qwen3.8 27B để hoàn thành 168 vòng lặp trên 8 tác vụ. Tốc độ sinh văn bản tăng từ 20,69 token/giây ở cấu hình MTP lên 36,22 token/giây với DFlash, rút ngắn tổng thời gian khoảng 31,5%. Đây là con số đủ để đưa AI đa tác vụ vào quy trình làm việc hàng ngày, chứ không chỉ demo.
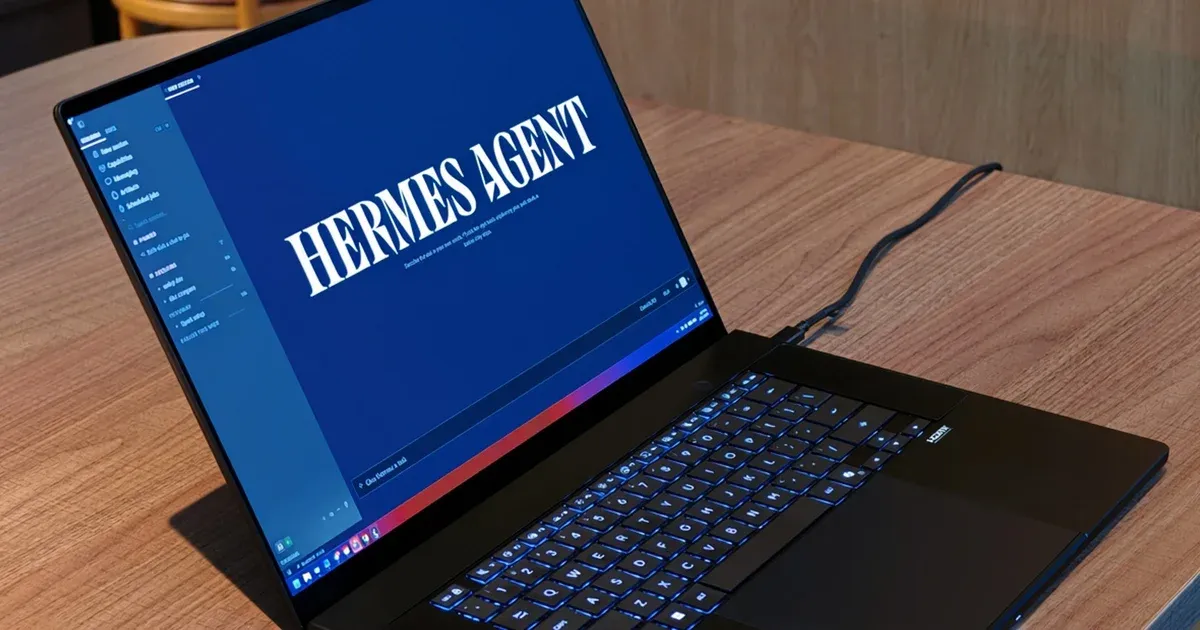
Khả năng xử lý AI cục bộ còn thể hiện ở các tác vụ sáng tạo nội dung. Với mô hình FLUX.2 Klein 4B, hệ thống đạt tốc độ sinh ảnh 37,69 ảnh/phút, tương đương 1,59 giây mỗi ảnh. Phần mềm ComfyUI được dùng để chạy các mô hình tạo ảnh và video trực tiếp trên máy, không cần kết nối mạng. Một bài test khác dùng Hermes – tác nhân AI có thể dùng công cụ, viết code và thao tác trực tiếp trên máy – chạy mô hình Qwen3.8 27B cục bộ để nhận yêu cầu tiếng Việt và phát triển ứng dụng Windows QuickWebP; sau khoảng 2 giờ 9 phút, Hermes hoàn thành ứng dụng dù gặp lỗi thư viện và môi trường Python. QuickWebP xử lý 329 ảnh JPG trong 246 giây, và với nhóm 20 ảnh, mất 8,8 giây để xuất JPG và 12,3 giây để chuyển sang WebP, đáp ứng nhu cầu xử lý ảnh thông thường. Đây là minh chứng rõ ràng rằng laptop Windows AI với RTX Spark có thể trở thành “xưởng AI” cá nhân, không phụ thuộc đường truyền.
Giới hạn hiện tại, rủi ro tương lai và ý nghĩa cho PC AI độc lập
Mặt trái của RTX Spark NPU là trải nghiệm nhà phát triển còn khá thô. Để chạy mạng nơ-ron trên NPU, phải tự ghép bộ công cụ beta: driver bán lẻ chứa cuDLA, TensorRT 11.4 cho Windows trên Arm khôi phục hỗ trợ DLA nhưng với nhiều giới hạn – mọi layer phải chạy trên DLA, batch size cố định là 1, shape tĩnh và chỉ dùng FP16. Nvidia còn cảnh báo các engine xây dựng với bản phát hành này có thể phải build lại khi hỗ trợ DLA đạt mức phát hành rộng rãi, nên những gì viết cho RTX Spark NPU hiện tại có thể không dùng được về sau. Dù có thể chạy ResNet-50 ở INT8 bằng cách đi vòng TensorRT, hiệu năng không nhanh hơn FP16, càng cho thấy NPU này được tối ưu cho một số khối lượng công việc rất cụ thể.
Tuy vậy, ý nghĩa lớn nhất của RTX Spark nằm ở việc đẩy AI độc lập xuống máy cá nhân. Qua thử nghiệm, nền tảng này cho thấy có thể xử lý nhiều tác vụ AI cục bộ trên laptop: từ chạy mô hình ngôn ngữ lớn, tạo ảnh và video đến phát triển ứng dụng. Với 64 GB bộ nhớ hợp nhất, RTX Spark thể hiện tiềm năng đưa các mô hình AI lớn vào quy trình làm việc hàng ngày, giảm phụ thuộc vào dịch vụ cloud. NPU 55 TOPS âm thầm đóng vai trò “động cơ nền” cho các tính năng Copilot+, trong khi GPU Blackwell và bộ nhớ hợp nhất gánh các tác vụ AI nặng. Nếu Nvidia mở khóa NPU cho nhà phát triển và ổn định hệ sinh thái phần mềm, RTX Spark có thể trở thành chuẩn mực mới: laptop Windows AI xử lý AI cục bộ như một máy trạm mini, không cần internet vẫn thông minh.