
AI y tế: Cánh tay phải hay chiếc gương méo của quá khứ?
AI chẩn đoán sai lệch là hiện tượng các hệ thống trí tuệ nhân tạo trong y tế đưa ra kết luận bệnh lý không phù hợp với tình trạng hiện tại của người bệnh, do bị ảnh hưởng bởi dữ liệu y tế thiên vị, lạc hậu hoặc thiếu đại diện, dẫn tới nguy cơ bỏ sót bệnh, chẩn đoán nhầm và điều trị sai hướng cho bệnh nhân. Trong vài năm gần đây, AI đã trở thành “cánh tay” công nghệ của bác sĩ, từ đọc dữ liệu hình ảnh, hỗ trợ can thiệp bào thai, tính liều thuốc đến lập kế hoạch cho những ca phẫu thuật phức tạp. Sự phát triển nhanh này mang lại kỳ vọng lớn về độ chính xác AI y tế, nhưng lại che khuất một sự thật khó chịu: rất nhiều mô hình đang được huấn luyện trên các bộ dữ liệu y tế mà chính bệnh nhân không hề biết đã tồn tại từ hàng thập kỷ trước.
Khi hồ sơ ẩn danh cũ kéo bệnh nhân quay về năm 2012
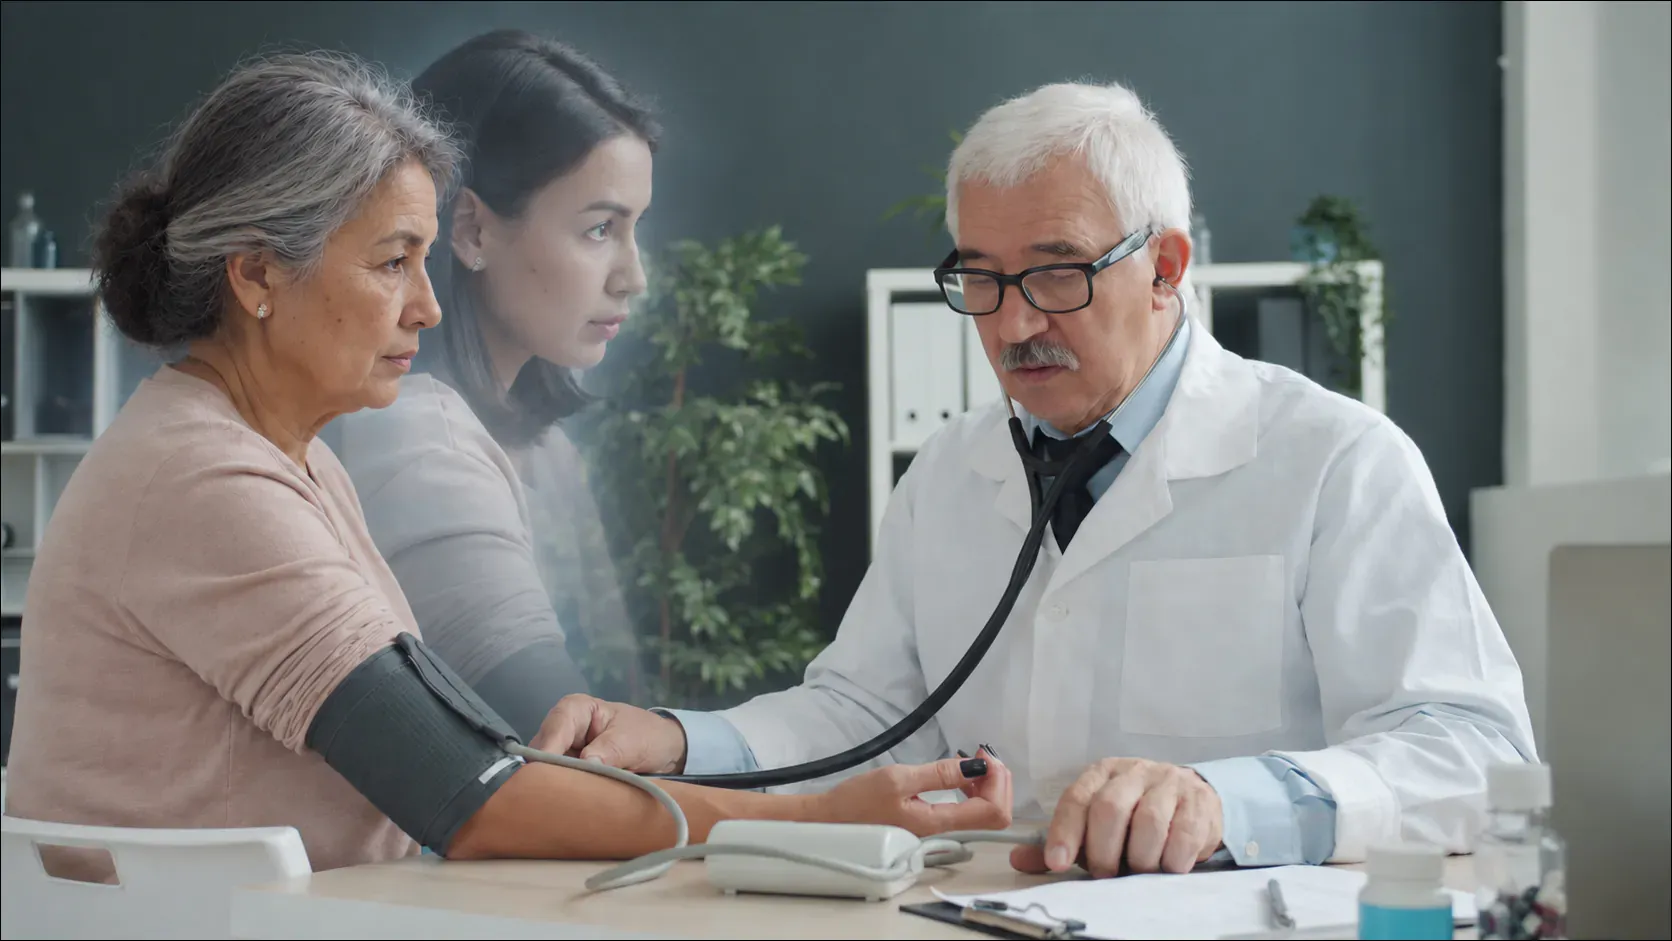
Một hợp tác nghiên cứu giữa Đức và Anh chỉ ra rằng các hồ sơ bệnh nhân ẩn danh đã được đưa vào bộ dữ liệu y tế từ hàng thập kỷ trước, và nay đang được dùng để huấn luyện mô hình AI chẩn đoán. Vấn đề là các hệ thống này thường được triển khai đúng trên nhóm dân số đã cung cấp dữ liệu huấn luyện. Khi một bệnh nhân quay lại sau nhiều năm, hồ sơ mới của họ có thể trở thành “gợi ý” cho chính bản ghi lịch sử đã bị mô hình ghi nhớ, kéo dự đoán về trạng thái sức khỏe cũ. Điều này tạo ra AI chẩn đoán sai lệch: người từng điều trị ung thư 20 năm trước nhưng đã thuyên giảm lâu dài có thể bị AI nhìn như vẫn còn bệnh, làm tăng khả năng chẩn đoán sai tái phát. Ngược lại, hồ sơ cũ “hoàn toàn khỏe mạnh” có thể che mờ các bệnh lý mới của phiên bản già hơn của chính bệnh nhân.
Thiên lệch ghi nhớ: Khi dữ liệu y tế thiên vị làm méo kết quả
Trong các mô hình y tế, vấn đề không chỉ là thiếu dữ liệu mà là kiểu dữ liệu. Các nghiên cứu trước về “thiên lệch hiện diện có thông tin” cho thấy hồ sơ sức khỏe điện tử thường nghiêng về những giai đoạn bệnh nhân ốm và tương tác với hệ thống y tế, thay vì ghi nhận đều đặn các giai đoạn khỏe mạnh. Kết quả là dữ liệu y tế thiên vị: bệnh nhân nặng bệnh có số ngày có dữ liệu xét nghiệm cao hơn 5,05 lần và số ngày có đơn thuốc cao hơn 6,85 lần so với nhóm khỏe mạnh nhất. Khi huấn luyện mô hình AI trên những bộ dữ liệu như vậy, hiện tượng “memorisation bias” – thiên lệch ghi nhớ – xuất hiện: mô hình ghi nhớ cấu hình cụ thể thay vì học khái quát, làm độ chính xác AI y tế bị kéo lệch. Với các tình trạng mới, hiệu ứng này luôn tiêu cực, khiến độ nhạy giảm trên nhiều loại chẩn đoán và tăng số ca âm tính giả khi sức khỏe bệnh nhân đã thay đổi.
Tham lam dữ liệu hay bảo vệ độ chính xác AI y tế?
Các quy định hiện nay lại vô tình khuyến khích rủi ro. EU AI Act yêu cầu dữ liệu huấn luyện phản ánh bối cảnh địa lý và ngữ cảnh dự kiến sử dụng, trong khi các hướng dẫn quốc tế cũng đòi hỏi quần thể bệnh nhân mục tiêu được đại diện đầy đủ trong bộ dữ liệu. Nghe có vẻ hợp lý, nhưng việc giới hạn dữ liệu trong một quốc gia làm tăng khả năng mô hình thấy lại cùng một bệnh nhân nhiều lần trong huấn luyện, nghĩa là tăng ghi nhớ thay vì tổng quát hóa. "Một mô hình AI sàng lọc ung thư vú ở Đức được huấn luyện trên 1,2 triệu ảnh chụp nhũ ảnh từ cùng chính chương trình sàng lọc mà nó đang phục vụ". Mở rộng bộ dữ liệu với dữ liệu “ngoại quốc” giúp đa dạng hóa, nhưng lại mang theo xu hướng sức khỏe không phù hợp với dân số triển khai. Cân bằng giữa tiện ích dữ liệu và độ chính xác AI y tế vì vậy đòi hỏi minh bạch về thành phần bộ dữ liệu, chứ không chỉ là khẩu hiệu “nhiều dữ liệu hơn là tốt hơn”.
AI chỉ là công cụ: Phải giữ bác sĩ ở ghế lái
Trong thực hành lâm sàng, những gì đang diễn ra ở Hà Nội cho thấy một hướng tiếp cận lành mạnh hơn. Một số bệnh viện đã đưa AI vào những lĩnh vực đòi hỏi độ chính xác cao như can thiệp bào thai, nơi từng thao tác gắn với quyết định chuyên môn tinh vi. AI được tích hợp vào công cụ hội chẩn và thiết bị chẩn đoán hình thái để nhận diện bất thường, cảnh báo nguy cơ, hỗ trợ định hướng xử trí, nhưng không thay bác sĩ trong can thiệp. Những hệ thống này chủ yếu hỗ trợ phân tích, cảnh báo, tính toán hoặc cung cấp thêm thông tin cho nhân viên y tế, còn quyết định chẩn đoán và điều trị vẫn thuộc về bác sĩ dựa trên tình trạng thực tế của từng người bệnh. Thực tế tương tự diễn ra trong dược lâm sàng: trước đây mỗi lần tra cứu và tính liều kháng sinh có thể mất 10–15 phút, nay được rút xuống dưới 2 phút, đồng thời giúp điều chỉnh liều phù hợp hơn với chức năng thận và giảm nguy cơ sai sót. Đó là mô hình đáng được nhân rộng: AI hỗ trợ, con người kiểm soát.
Song song với đó, cần tiếp cận kỹ thuật để giảm thiên lệch ghi nhớ. Một hướng là dùng độ riêng tư vi phân trong quá trình huấn luyện nhằm giới hạn lượng thông tin về từng bệnh nhân mà mô hình có thể giữ lại. Nhưng đây chỉ là hàng rào kỹ thuật. Cùng với đầu tư công nghệ, các cơ sở y tế phải giải quyết đồng thời yêu cầu về chất lượng dữ liệu, bảo mật thông tin, chuẩn hóa quy trình và kiểm chứng hiệu quả từng ứng dụng trước khi triển khai rộng rãi. Các tác giả nghiên cứu về memorisation bias cảnh báo: hiện tại tỷ lệ sự cố có thể còn thấp, nhưng có lý do để kỳ vọng số lượng chẩn đoán bỏ lỡ do thiên lệch ghi nhớ sẽ tăng trong tương lai. Nếu hệ thống y tế tiếp tục phụ thuộc vào AI mà không tăng cường giám sát con người, những sai lệch nhỏ hôm nay có thể trở thành thảm họa lịch sử bền vững ngày mai.