
Đừng bắt đầu từ mô hình mạnh nhất khi chọn mô hình Claude
Chọn mô hình Claude là quá trình quyết định giữa nhiều mô hình AI khác nhau dựa trên chi phí token, giới hạn xử lý, độ trễ, quyền truy cập và độ phức tạp suy luận của tác vụ, thay vì chỉ nhìn vào mô hình mạnh nhất rồi dùng cho mọi trường hợp. Đây là chỗ rất nhiều đội ngũ đốt ngân sách mà không tăng được chất lượng. Cách hợp lý là đặt ra ngưỡng chất lượng tối thiểu, sau đó chọn mô hình rẻ nhất vẫn đáp ứng được ngưỡng đó, thay vì mặc định dùng Opus 5 cho mọi việc. Nói cách khác, chiến lược chọn mô hình Claude phải xoay quanh câu hỏi: “Tôi cần mức suy luận đến đâu, nguồn lực bao nhiêu, tích hợp ở đâu?”, chứ không phải “Mô hình nào đang đứng top benchmark”. Chính sự dịch chuyển câu hỏi này mới giúp bạn kiểm soát chi phí dài hạn mà vẫn giữ chất lượng ổn định.

Chi phí token Claude: hiểu đúng trước khi so sánh Opus, Sonnet, Haiku
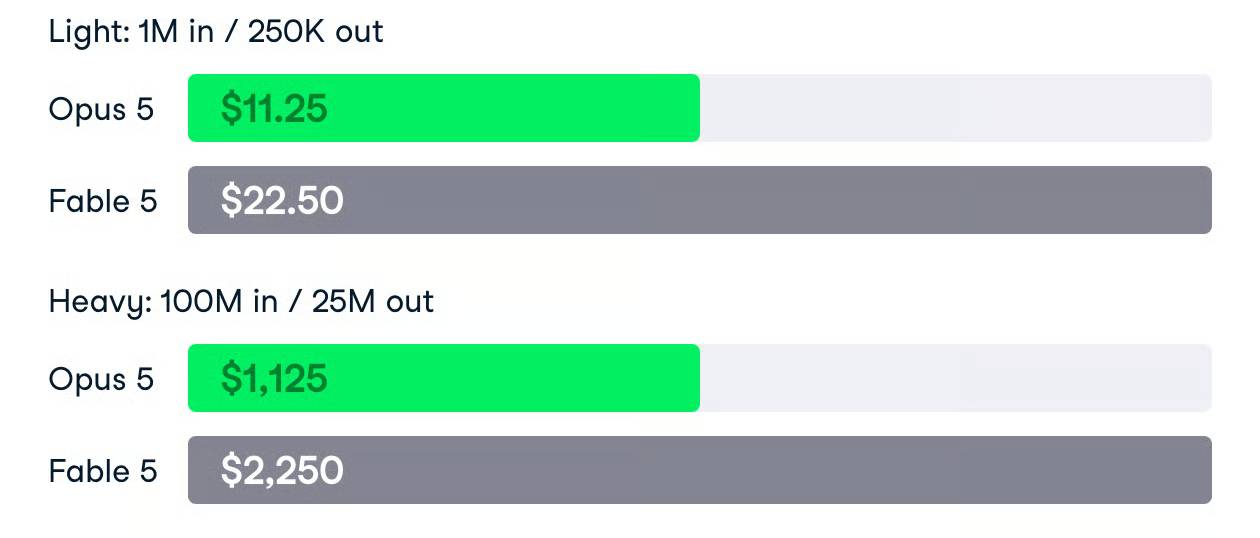
Chi phí token Claude không tính theo số lượt gọi mà theo tổng token đầu vào và đầu ra, mỗi loại có đơn giá khác nhau. System prompt, lịch sử hội thoại, định nghĩa công cụ và tài liệu đính kèm đều làm phình phần “input”; trả lời càng dài thì phần “output” càng đắt. Nếu chỉ nhìn tên mô hình, bạn gần như không đoán được hóa đơn cuối cùng. Theo bảng giá chính thức, các mô hình được chia cấp: Fable 5.1/Mythos 5.1 là phân khúc cao cấp, Opus 5 là phân khúc cao nhưng rẻ hơn đáng kể, Sonnet 5 là tầm trung, còn Haiku 4.5 là phân khúc tiết kiệm. Một hệ thống trích xuất hoặc phân loại chạy hàng chục nghìn yêu cầu có thể chênh nhau rất lớn giữa Haiku và các mô hình cao hơn, dù cùng logic. Trích dẫn đáng nhớ: “Chi phí thực không nằm ở số request mà nằm ở tổng token bạn để mô hình đọc và viết”.
| Mô hình | Vị trí chi phí tương đối | Gợi ý vai trò khởi điểm |
|---|---|---|
| Haiku 4.5 | Thấp nhất | Tóm tắt, phân loại, trích xuất có quy tắc rõ |
| Sonnet 5 | Trung bình | Coding thường ngày, phân tích dài nhưng không quá phức tạp |
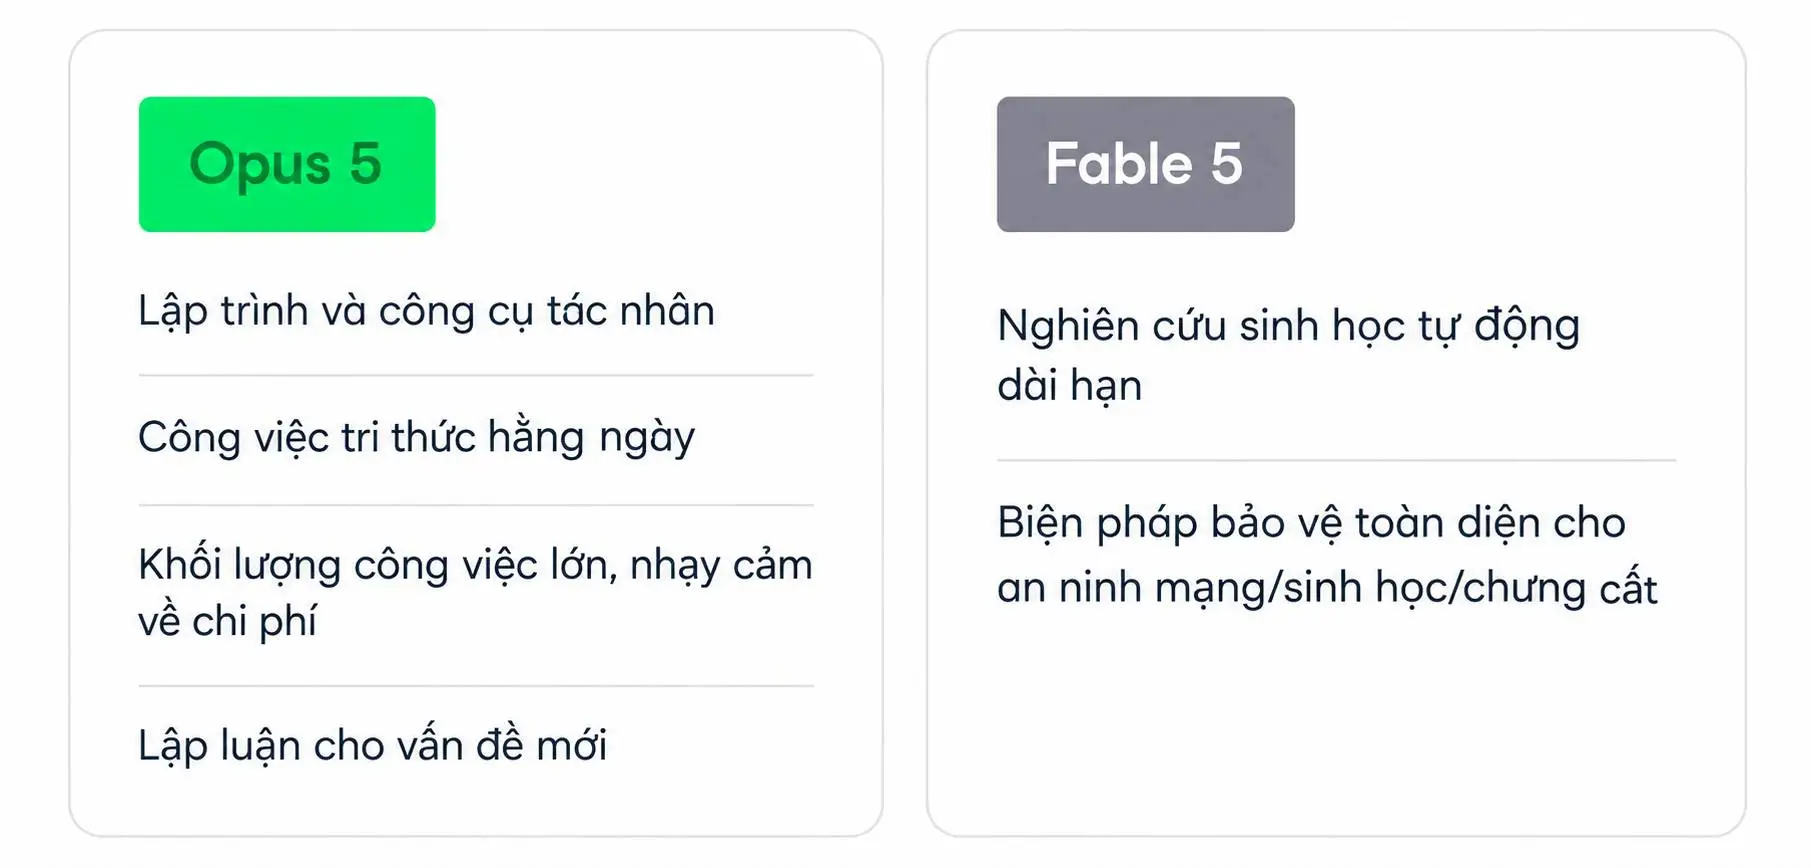
| Opus 5 | Cao | Agent phức tạp, thay đổi lớn, nhiệm vụ suy luận khó |
| Fable/Mythos | Cao nhất | Tác vụ cực kỳ khó, chuyên biệt, dài hạn |
So sánh mô hình AI Claude: Opus 5, Fable 5 và vai trò của Haiku
Khi so sánh mô hình AI, nhiều người chỉ nhìn vào benchmark rồi suy ra “đắt hơn = mạnh hơn”. Với Claude, điều này không còn đúng. Trong lập trình, Opus 5 đạt 96,0% trên SWE-bench Verified, cao hơn Fable 5 (95,0%); trên Frontier-Bench đánh giá coding qua terminal, Opus 5 đạt 43,3% so với 33,7% của Fable 5. Trên GDPval-AA v2 về xử lý công việc tri thức, Opus 5 cũng vượt Fable 5 với 1.861 điểm so với 1.747 điểm. Fable 5 chỉ nhỉnh hơn nhẹ ở SWE-bench Pro (80,3% so với 79,2% của Opus 5) và được đánh giá nổi bật hơn trong một số tác vụ suy luận khoa học khó, dài hơi thuộc nhóm Mythos. Ngoài ra, nhóm Mythos, trong đó có Fable 5.1/Mythos 5.1, đi kèm hệ thống phân loại an ninh khắt khe và quyền truy cập hạn chế hơn, không phải ai cũng có thể bật lên dùng. Điều này cho thấy việc chọn mô hình không thể dựa trên hiệu năng thuần túy. Ở chiều ngược lại, Haiku 4.5 được khuyến nghị làm điểm xuất phát cho trích xuất trường dữ liệu, phân loại khối lượng lớn, tóm tắt tài liệu ngắn và trung bình – các tác vụ lặp nhiều, quy tắc rõ ràng. Trong so sánh Claude Opus vs Haiku, Haiku không thắng ở suy luận, nhưng lại là vũ khí chủ lực để giảm chi phí trên mỗi tác vụ với chất lượng đủ dùng.

Giới hạn xử lý, độ trễ và quyền truy cập: khác biệt ít ai tính đến
Ngoài chi phí, khi chọn mô hình Claude bạn còn phải để ý đến giới hạn xử lý và quyền truy cập. Các mô hình cao cấp như Fable 5.1 và Mythos 5.1 có ngữ cảnh tới 1 triệu token và đầu ra tối đa 128.000 token, tương tự Opus 5 và Sonnet 5, trong khi Haiku 4.5 có ngữ cảnh 200.000 token và đầu ra tối đa 64.000 token. Nghĩa là bạn có thể nhồi rất nhiều tài liệu vào Opus, nhưng không có nghĩa lúc nào cũng nên làm vậy. Độ trễ cũng khác nhau: Fable được gắn nhãn chậm hơn, Opus ở mức trung bình, Sonnet “nhanh”, Haiku “nhanh nhất”. Đây không phải cam kết tuyệt đối, nhưng là gợi ý rằng Haiku phù hợp hơn cho pipeline nhiều request nhỏ, yêu cầu phản hồi nhanh, trong khi các mô hình lớn phù hợp hơn với tác vụ ít lần gọi nhưng mỗi lần dài và phức tạp. Về truy cập, Mythos 5.1 không phải là tùy chọn “đổi tên là xong”; nó chỉ cung cấp cho người được mời trong một chương trình riêng, dù thông số và giá tương đương Fable 5.1. Điều này nhắc chúng ta rằng không phải mô hình nào cũng có thể đưa vào sản phẩm ngay cả khi bạn muốn.
Chiến lược thực tế: đa số nên bắt đầu từ Haiku hoặc Sonnet
Luận điểm quan trọng nhất: đa số người dùng có thể đạt ngưỡng chất lượng mong muốn với mô hình tầm trung hoặc tiết kiệm nếu định nghĩa tác vụ đủ rõ và pipeline đủ sạch. Hướng đi được khuyến nghị là: với tóm tắt tài liệu, phân loại, trích xuất trường dữ liệu, nếu đầu vào dưới khoảng 200.000 token, hãy thử Haiku 4.5 trước; chỉ nâng lên Sonnet 5 khi tỷ lệ thiếu sót hoặc lỗi phân loại vượt ngưỡng chấp nhận. Với coding agent thông thường, nên dùng Sonnet 5 làm điểm khởi đầu: sinh code hàng ngày, viết đề xuất sửa nhiều file, tổng hợp lập luận từ tài liệu dài. Chỉ chuyển sang Opus 5 cho các thay đổi lớn ở kho mã, quá trình tự động hóa kéo dài nhiều giờ hoặc dùng nhiều công cụ theo chuỗi mà Sonnet lặp lại thất bại. Câu cần khắc ghi là: “Hãy tính chi phí theo toàn bộ workflow, không phải theo mô hình yêu thích”. Cả Opus lẫn Fable, Sonnet hay Haiku đều có điểm yếu riêng, và ngay cả benchmark tổng cũng chỉ nên xem như chỉ báo về tương quan giá–hiệu năng chứ không phải dự báo chính xác tuyệt đối cho mọi tác vụ.