
Mở khóa giới hạn AI trên GeForce RTX
Mở khóa GPU RTX là cách dùng các công cụ mã nguồn mở để thay đổi giới hạn tốc độ một số phép toán AI trên GPU GeForce, giúp phần cứng xử lý FP16 hoặc BF16 nhanh hơn mà không cần thay card. Các nhà phát triển gần đây đã thử phương pháp này trên một số GPU RTX 20, 30 và 40 series thông qua lỗ hổng firmware.
Động lực khá dễ hiểu: RTX 3090 với 24 GB VRAM vẫn được cộng đồng tự xây dựng hệ thống AI quan tâm, còn GPU máy trạm thường khó tiếp cận hơn. Trên một số GeForce, phép nhân ma trận FP16 hoặc BF16 kèm tích lũy FP32 bị giới hạn ở khoảng một nửa thông lượng so với chế độ tích lũy FP16, dù phần cứng có khả năng chạy nhanh hơn. FP16 và BF16 là các định dạng số thường dùng để tăng tốc AI; tích lũy FP32 giúp duy trì độ chính xác.
Các dự án gpu-unlock, gpu-unlock-ada và turing-unlock lần lượt nhắm tới một số card RTX 30, RTX 40 và RTX 20. Chúng can thiệp vào thanh ghi điều khiển trước khi trình điều khiển được nạp, thay vì thêm nhân xử lý hay ép xung. Cách làm này đáng chú ý, nhưng hiện chủ yếu dành cho Linux và đòi hỏi can thiệp sâu lúc khởi động; đây chưa phải nút bật an toàn, tiện dụng cho người dùng phổ thông.
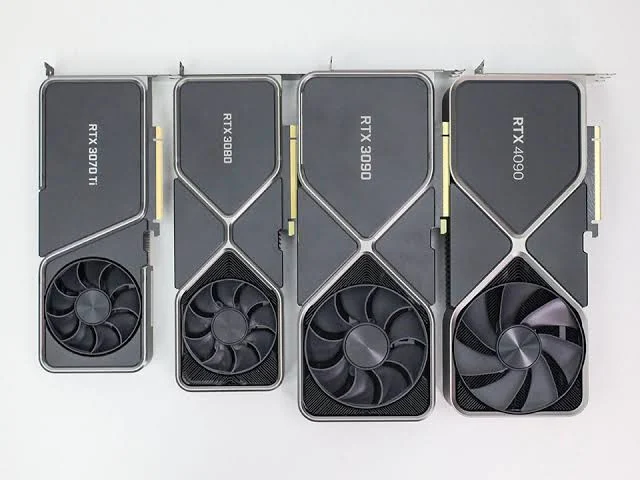
Benchmark Tensor gây ấn tượng, nhưng không kể hết câu chuyện
Các con số trên benchmark Tensor rất bắt mắt. Trong thử nghiệm của gpu-unlock-ada, RTX 4090 tăng tốc độ Tensor FP16 từ 165,6 lên 331,6 TFLOPS; BF16 tăng từ 165,5 lên 330,6 TFLOPS, gần gấp đôi. Thử nghiệm cộng đồng trên RTX 309 cũng ghi nhận tốc độ Tensor trong PyTorch tăng từ khoảng 75 lên 135 TFLOPS ở mức 360 W.
Mức tăng tới 80% cũng xuất hiện trong một số phép đo: RTX 3090 Ti được báo cáo cải thiện khoảng 35% với FP16, 80% với BF16 và 94% với TF32. Một thử nghiệm khác ghi nhận BF16 trên RTX 3090 Ti tăng từ 87,5 lên 157,4 TFLOPS ở mức công suất tối đa 450 W.
Nhưng thông lượng lý thuyết không đồng nghĩa ứng dụng nhanh gấp đôi. Trong phép nhân ma trận cuBLAS thực tế trên RTX 4090, FP16 chỉ tăng khoảng 12–34%, còn BF16 tăng tối đa 20%. Khoảng cách đó là lời nhắc quan trọng: benchmark cô lập khả năng tính toán, còn hiệu năng AI GPU trong ứng dụng còn phụ thuộc vào loại tác vụ, kích thước dữ liệu, giới hạn điện năng và phần mềm. Các kết quả hiện có cũng chưa đại diện cho mọi hệ thống hay độ ổn định lâu dài.
Tác vụ nào được lợi, và ai nên chờ?
Lợi ích có khả năng rõ hơn ở tác vụ phụ thuộc nhiều vào phép nhân ma trận, như tạo ảnh bằng AI, tinh chỉnh mô hình và xử lý lời nhắc đầu vào. Ngược lại, tốc độ sinh từng token của mô hình ngôn ngữ thường bị giới hạn bởi băng thông bộ nhớ nên gần như không thay đổi sau khi mở khóa. Vì vậy, người chạy chatbot tại nhà không nên kỳ vọng câu trả lời xuất hiện nhanh gấp đôi chỉ nhờ thông lượng Tensor cao hơn.
Với game thủ, kết luận còn đơn giản hơn: mở khóa này gần như không đem lại lợi ích đáng kể, bởi game thông thường ít phụ thuộc vào những phép toán AI nói trên. Hiện cũng chưa có benchmark độc lập chứng minh FPS tăng sau khi mở khóa. Đây là công cụ hướng tới một nhóm tác vụ cụ thể, không phải cách nâng hiệu năng toàn diện cho mọi phần mềm.
Rủi ro cũng không nên xem nhẹ. Công cụ can thiệp vào thanh ghi GPU; độ tương thích và ổn định có thể khác nhau theo mẫu card, hệ điều hành và phiên bản trình điều khiển. RTX 50 series hiện chưa được hỗ trợ. Nếu các kết quả được kiểm chứng trên nhiều cấu hình độc lập, dự án có thể kéo dài giá trị sử dụng của RTX 3090 hay RTX 2080 Ti. Cho đến lúc đó, đây là thử nghiệm đáng theo dõi với người dùng AI am hiểu Linux, chứ chưa phải bản nâng cấp nên cài đại trà.