
NetApp Novus: kiến trúc lưu trữ sinh ra cho AI Factory
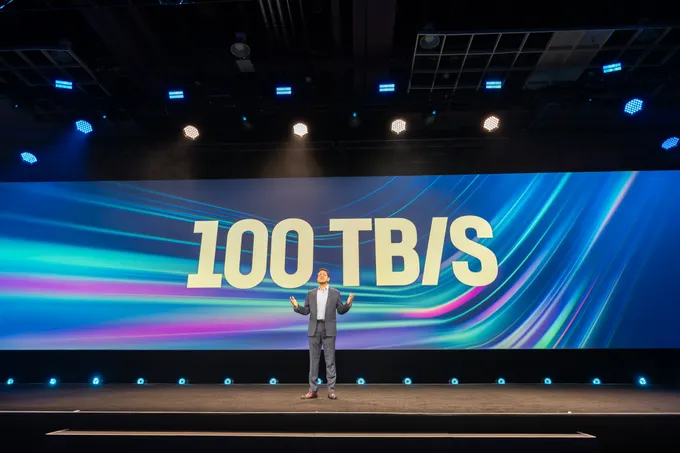
Kiến trúc lưu trữ NetApp Novus là giải pháp lưu trữ AI nhanh được thiết kế riêng cho các nhà cung cấp hạ tầng AI vận hành môi trường GPU quy mô lớn, với khả năng hỗ trợ hệ thống tệp ở quy mô zettabyte và duy trì nguồn dữ liệu liên tục cho hàng triệu GPU, nhằm loại bỏ điểm nghẽn dữ liệu, tối ưu hóa GPU và tối đa hóa lợi nhuận từ đầu tư hạ tầng AI. Thông điệp cốt lõi của NetApp ở đây rất rõ: nếu dữ liệu không theo kịp tốc độ tính toán thì mọi khoản chi cho GPU cao cấp đều trở nên phung phí. NetApp Novus không phải là một nâng cấp nhỏ, mà là nỗ lực đặt lại chuẩn chơi cho hạ tầng AI ở quy mô AI Factory – nơi hàng triệu GPU cần được "nuôi" bằng dữ liệu liên tục thay vì chờ đợi trong trạng thái nhàn rỗi.
Điểm nghẽn dữ liệu: kẻ thù giấu mặt của hiệu suất GPU
Lý do NetApp phải đưa ra một kiến trúc NetApp mới nằm ở thực tế khá phũ phàng: hạ tầng tính toán đang bỏ xa hạ tầng lưu trữ. Các neocloud tối ưu cho hạ tầng AI và nhà cung cấp GPU-as-a-Service đang xây dựng những AI Factory ở quy mô mà các hệ thống lưu trữ truyền thống chưa từng được thiết kế để xử lý. Kết quả là data pipeline bị nghẽn, GPU chờ dữ liệu thay vì xử lý, còn chi phí hạ tầng thì leo thang. Trong các mô hình lưu trữ cũ, mức sử dụng GPU có thể tụt xuống dưới 30% khi hệ thống không cung cấp đủ dữ liệu cho GPU xử lý. Đây là con số khó chấp nhận trong một thị trường mà mọi người đều nói về tối ưu hóa GPU nhưng lại ít ai nhìn thẳng vào gốc rễ: kiến trúc lưu trữ không theo kịp tham vọng AI.
Thông lượng 100 TB/giây: khi lưu trữ trở thành động cơ thay vì nút thắt
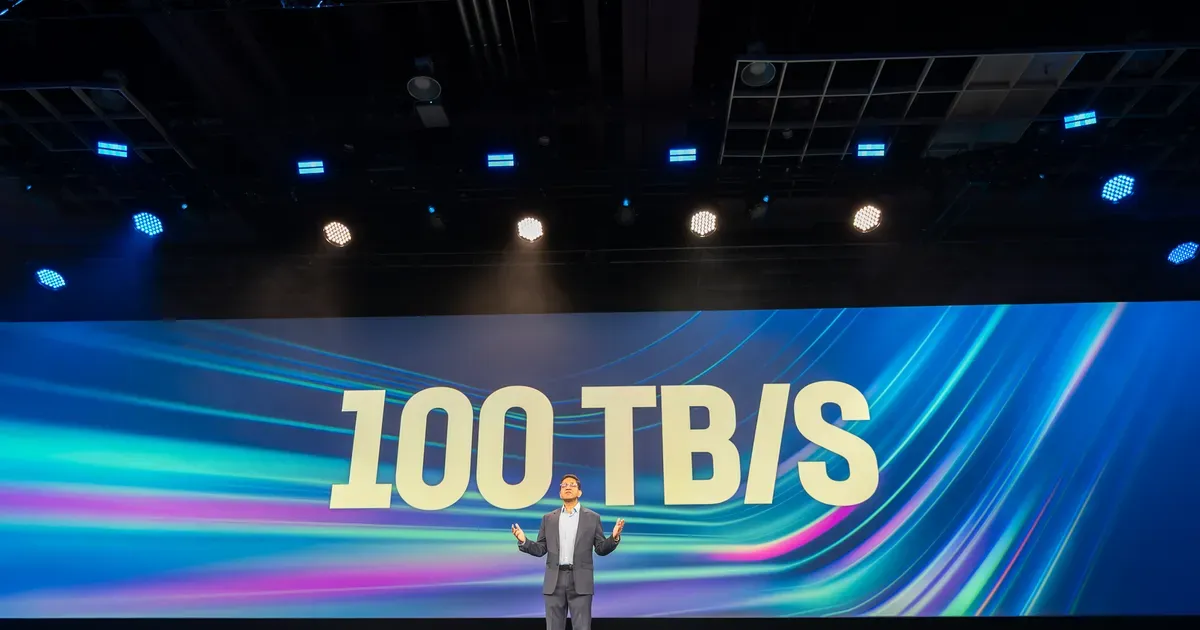
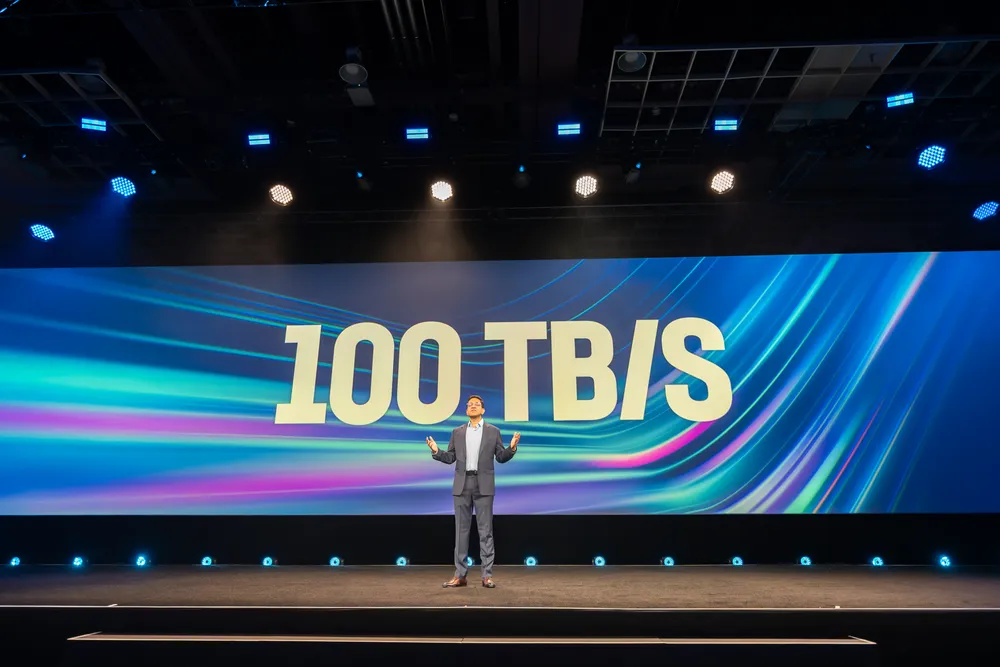
Điểm gây chú ý nhất của NetApp Novus là khả năng mở rộng hiệu năng tới 100 TB/giây, vượt trội so với mọi giải pháp hiện có trên thị trường. Ở ngưỡng này, lưu trữ không còn là cổ chai, mà trở thành động cơ chính cho những AI Factory tham vọng zettabyte. Đây là nền tảng đủ dư địa để chạy các workload đào tạo và suy luận AI cực lớn mà không phải liên tục "bóp" mô hình cho hợp với I/O. Theo ông Syam Nair, hiệu quả của AI Factory phụ thuộc không chỉ vào GPU mà còn vào khả năng cung cấp dữ liệu; khi dữ liệu không theo kịp tốc độ xử lý, GPU sẽ bị lãng phí và chi phí vận hành AI tăng cao. Câu nói này tóm gọn lý do vì sao thông lượng 100 TB/giây không phải là con số khoe mẽ, mà là điều kiện bắt buộc để tối ưu hóa GPU trong các hệ thống AI hiệu năng cao.
Tách metadata khỏi luồng dữ liệu: quyết định kiến trúc mang tính bước ngoặt
Thành công của Novus không chỉ đến từ tốc độ mà còn từ cách kiến trúc được thiết kế lại từ gốc. NetApp lựa chọn tách riêng phần quản lý siêu dữ liệu (metadata) khỏi luồng dữ liệu chính, qua đó loại bỏ các giới hạn về khả năng mở rộng vốn là điểm yếu cố hữu của nhiều hệ thống lưu trữ hiện nay. Khi metadata không còn là điểm nóng chia sẻ tài nguyên với dữ liệu, hệ thống có thể mở rộng hiệu năng, dung lượng và khả năng xử lý đồng thời một cách độc lập mà vẫn nằm trong cùng một không gian dữ liệu thống nhất dùng giao thức chuẩn NFS. Đây là cách tiếp cận thực dụng: thay vì xây dựng một "đế chế" lưu trữ khép kín với giao thức lạ, NetApp chọn bám vào NFS – ngôn ngữ mà phần lớn hạ tầng AI và các AI Factory đã hiểu rõ. Điều này giúp các nhà cung cấp hạ tầng AI giảm ma sát triển khai, rút ngắn thời gian đưa lưu trữ AI nhanh vào sản xuất.
Ý nghĩa của kiến trúc NetApp mới với cuộc đua hạ tầng AI
Việc NetApp công bố kiến trúc lưu trữ đạt thông lượng 100 TB/giây cho thấy cuộc chơi hạ tầng AI đang dịch chuyển từ "mua thêm GPU" sang "giải phóng GPU" bằng dữ liệu. Khi các AI Factory có thể duy trì luồng dữ liệu liên tục cho hàng triệu GPU, bài toán không còn nằm ở việc đổ thêm tiền cho compute, mà ở thiết kế kiến trúc lưu trữ đủ linh hoạt để tối ưu hóa GPU và tạo ra lợi nhuận bền vững. Kiến trúc NetApp mới, với cách tách metadata, hỗ trợ hệ thống tệp quy mô zettabyte và hiệu năng lưu trữ nhanh nhất thế giới hiện nay, là lời nhắc nhở rất thẳng thắn dành cho các nhà cung cấp hạ tầng AI: nếu coi lưu trữ chỉ là "kho để dữ liệu", hạ tầng sẽ sớm chạm trần. Nếu coi lưu trữ là nền tảng chiến lược, GPU sẽ trở thành tài sản sinh lợi thay vì chi phí bị lãng phí.