
Tại sao kiểm soát chi phí AI phải bắt đầu từ kiến trúc, không phải từ hóa đơn
Kiểm soát chi phí AI là việc thiết kế và vận hành hệ thống dùng mô hình ngôn ngữ lớn sao cho lượng token, kiến trúc hạ tầng và lựa chọn nhà cung cấp được xem như nguồn lực hữu hạn cần phân bổ có chủ đích, nhằm tránh cú sốc hóa đơn mà vẫn giữ được chất lượng đầu ra cho bài toán kinh doanh. Large language models là công cụ kỳ diệu cho doanh nghiệp cho đến khi chi phí bất ngờ phình to, tạo nên những cú hóa đơn AI gây choáng. Vấn đề không chỉ là hóa đơn cao mà còn là việc không biết tiền đang chảy vào đâu và đem lại giá trị gì cho business. Nếu để ứng dụng AI vận hành như hộp đen sinh token, kiểm soát chi phí LLM sẽ thất bại từ sớm. Muốn quản lý chi phí mô hình ngôn ngữ hiệu quả, bạn phải coi token là tài nguyên khan hiếm, được thiết kế trong kiến trúc từ ngày đầu.
Chiến lược 1 – Chọn mô hình vừa đủ, đừng dùng "búa đóng đinh" cho mọi việc
Sai lầm phổ biến nhất khi tối ưu hóa chi phí LLM là luôn mặc định dùng mô hình mạnh nhất cho mọi tác vụ, từ prototyping đến production. Các mô hình hàng đầu có khả năng xử lý bài toán phức tạp, tinh tế, nhưng đồng thời tiêu thụ compute và chi phí ở mức khổng lồ, thường là quá mức cần cho use case thực tế. Trong giai đoạn thử nghiệm, việc ưu tiên “chạy cho được” là dễ hiểu. Nhưng khi sang sản xuất, câu hỏi phải đổi thành: đâu là mô hình yếu nhất nhưng vẫn đủ đáp ứng yêu cầu? Kiểm soát chi phí AI hiệu quả nghĩa là thiết lập một lớp model routing: tác vụ phân loại đơn giản, trích xuất text hay nhận diện intent được gửi tới các mô hình tiện ích nhanh, giá rẻ; tác vụ khó mới dùng mô hình lớn. Bạn có thể thêm AI gateway để điều phối, fallback sang mô hình rẻ hoặc open-source, đồng thời tập trung telemetry để đặt ngân sách token cứng cho từng dịch vụ. Dù gateway cũng tạo thêm độ phức tạp và chi phí, khoản tiết kiệm từ việc chọn mô hình “vừa đủ tốt” thường vượt xa phần overhead đó.
Chiến lược 2 – Semantic caching: tiết kiệm cho những câu hỏi lặp lại, tránh dùng cho sáng tạo
Nếu không cache, bạn sẽ trả đủ giá token cho mọi phiên bản ngôn ngữ khác nhau của cùng một câu hỏi. Trong web truyền thống, cache dựa trên chuỗi truy vấn là chuyện đã giải xong. Nhưng với LLM, ngôn ngữ con người biến hóa: “Làm sao reset mật khẩu?” và “Tôi quên thông tin đăng nhập” là hai string khác nhau nhưng mang cùng intent. Nếu cache dựa trên khớp chính xác, tỷ lệ hit gần như bằng 0, nghĩa là không có tiết kiệm nào. Semantic caching thay cách tiếp cận: hệ thống dùng một mô hình embedding nhanh để biểu diễn ý nghĩa prompt, sau đó so khớp với các prompt đã trả lời trước đó. Khi độ tương đồng vượt ngưỡng tự đặt, bạn phục vụ lại câu trả lời đã cache, bỏ qua LLM, giảm chi phí suy luận xuống đúng 0 cho truy vấn đó và rút latency từ vài giây xuống vài mili-giây. Tuy nhiên, bạn đang đổi chi phí sinh đáp án lấy chi phí embedding và tìm kiếm vector. Quan trọng hơn, đặt ngưỡng tương đồng quá thấp sẽ khiến hệ thống trả lời chung chung cho câu hỏi tinh tế. Semantic caching gần như vô dụng với tác vụ sáng tạo mở, nhưng với RAG, chatbot hỗ trợ khách hàng, knowledge base nội bộ nơi người dùng hỏi đi hỏi lại cùng vài chục câu theo nghìn cách diễn đạt khác nhau, đây là đòn bẩy giảm chi phí mạnh nhất bạn có thể dùng.
Chiến lược 3 – Dùng prompt caching và hạn chế context: cho mô hình đọc ít hơn
Một phần lớn chi phí LLM nằm ở lượng token đầu vào bạn gửi đi mỗi lần gọi API. Prompt caching giải bài toán này bằng cách để chính engine AI giữ lại dữ liệu ngữ cảnh tĩnh cần cho nhiều câu hỏi liên tiếp. Thay vì mỗi lần truy vấn lại phải gửi toàn bộ tài liệu, kết quả RAG hay dữ liệu nền, bạn tải chúng vào cache của mô hình, sau đó chỉ gửi câu hỏi mới. Các token được cache thường được tính với mức giảm giá rất mạnh, từ 50% đến 90% so với token đầu vào thô. Đây là một câu nói đáng ghi nhớ: "Tokens cached this way get a massive discount (50% to 90%) compared to raw input tokens". Nhưng để tối ưu hóa chi phí LLM thật sự, bạn phải hiểu rõ cách nhà cung cấp triển khai cache. Ví dụ, có nơi bật prompt caching tự động nhưng yêu cầu ngưỡng tối thiểu token, và quan trọng hơn là đòi hỏi phần đầu prompt phải khớp byte-for-byte với bản đã cache; nếu bạn nhét biến động như timestamp hay user ID lên đầu, toàn bộ cache coi như vô hiệu hóa. Thông điệp: thiết kế prompt có cấu trúc ổn định ở phần đầu, đẩy yếu tố động xuống dưới, và luôn nhớ rằng "chỉ vì một mô hình có thể nuốt lượng token khổng lồ, không có nghĩa là nó nên đọc nhiều như thế".
Chiến lược 4 – Siết chặt câu trả lời: cắt bỏ lời hoa mỹ để cứu ngân sách
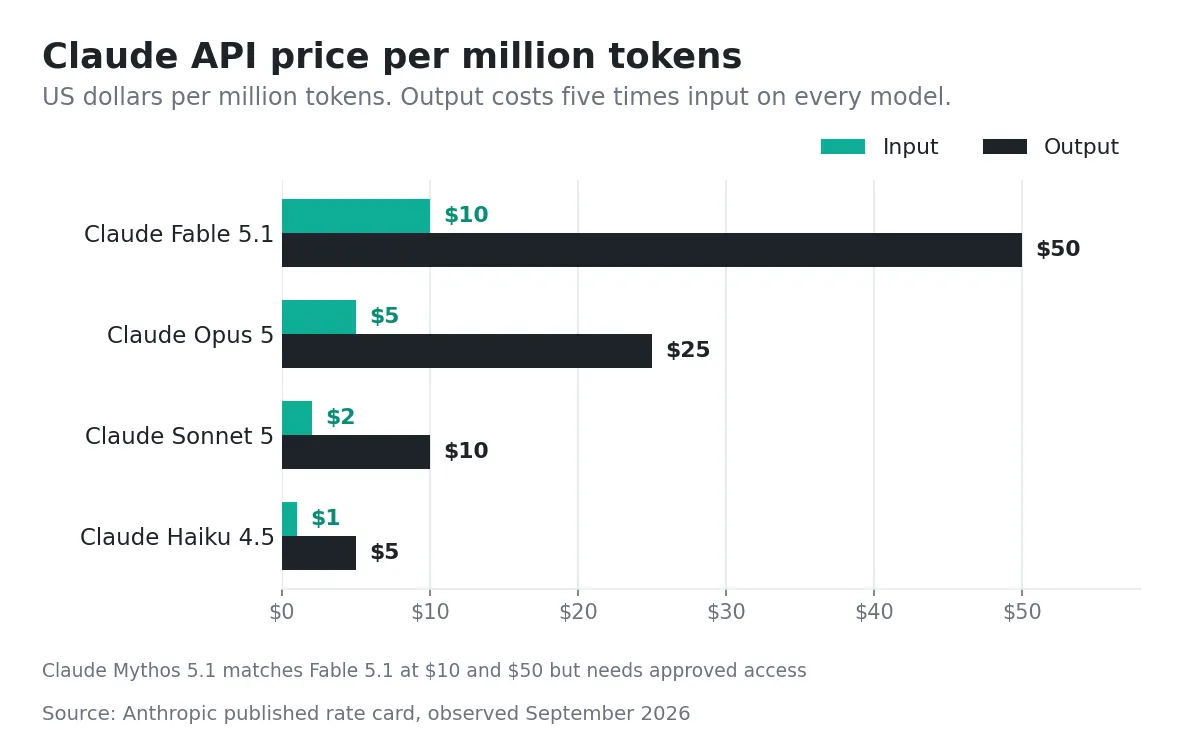
Trong giao diện chat cho người dùng cuối, câu trả lời lịch sự, diễn giải chi tiết có thể tạo cảm giác thân thiện. Nhưng trong kiến trúc API, đó là lỗ thủng ngân sách. Mặc định, LLM có xu hướng nói nhiều, mở đầu bằng “Chắc chắn rồi…” và kết thúc bằng lời mời hỏi thêm. Vấn đề là token đầu ra thường được tính giá cao gấp 3–5 lần token đầu vào. Mỗi câu chữ dư thừa nghĩa là bạn đang trả cho phần đắt nhất của dịch vụ để nhận về giá trị thấp. Quản lý chi phí mô hình ngôn ngữ đòi hỏi kỷ luật ở lớp API: đặt max_tokens như một cầu dao cứng để ngăn vòng lặp sinh nội dung kéo dài, chứ không phải công cụ cắt format, vì làm vậy thường dẫn đến JSON bị cắt cụt, không parse được. Đồng thời dùng stop sequence: nếu bạn chỉ cần câu SQL, hãy đặt stop ở ký tự đánh dấu kết thúc code block hoặc từ như “Explanation:” để buộc mô hình dừng ngay khi phần tính toán hoàn thành. Tóm lại, hãy yêu cầu output đúng cấu trúc và độ dài cần thiết; mọi “lời hoa” đều là token cháy túi.
Chiến lược 5 – Xây dựng AI infrastructure portability để tránh bị "khóa chân" khi giá tăng
Một rủi ro ít được nói thẳng trong kiểm soát chi phí AI là việc bị khóa chặt vào một nhà cung cấp, chỉ nhận ra vấn đề khi họ bắt đầu điều chỉnh mô hình giá để bù lỗ. Nhà cung cấp có động lực khiến việc rời đi trở nên đau đớn bằng cách tích hợp sâu, tính năng độc quyền. Bạn không thể loại bỏ hoàn toàn phụ thuộc cấu trúc, nhưng có thể giảm thiểu bằng thiết kế AI infrastructure portability. Nền tảng của sự linh hoạt là một abstraction layer: thay vì gọi trực tiếp Claude, GPT hay Gemini, ứng dụng nội bộ gọi tới một dịch vụ trung gian với format request do bạn tự định nghĩa. Lớp này dịch yêu cầu sang format của từng vendor phía sau. Khi cần đổi nhà cung cấp, bạn chủ yếu thay đổi cấu hình, không phải viết lại cả ứng dụng. Việc hoán đổi nền tảng sẽ không bao giờ là êm ái, nhưng luôn ít đau hơn việc bị kẹt với một vendor duy nhất khi họ quyết định tăng giá. Đó là lý do quản lý chi phí mô hình ngôn ngữ phải đi kèm chiến lược thoát, không chỉ chiến lược tối ưu hiện tại.