
Tối ưu hóa chi phí Claude: bắt đầu từ việc tách tác vụ lặp lại
Tối ưu hóa chi phí Claude là chiến lược phân loại và phân phối tác vụ giữa các mô hình AI có mức giá khác nhau, trong đó những tác vụ lặp lại, dễ dự đoán và thiên về xử lý nhập/xuất được chuyển sang mô hình chi phí thấp, còn các tác vụ cần suy luận sâu và rủi ro lỗi cao mới dùng mô hình cao cấp, nhằm đạt token tiêu thụ thấp mà vẫn giữ chất lượng kết quả ở mức chấp nhận được. Quan điểm quan trọng ở đây: đừng để Claude làm mọi thứ. Nếu bạn để một mô hình frontier gánh cả việc đọc file, quét mã, tạo những đoạn code lặp lại, bạn đang đốt token vào những việc không cần năng lực suy luận. Spotify cho thấy khi tách các tác vụ này khỏi Claude Code và giao cho mô hình chi phí thấp, lượng token tiêu thụ giảm trung bình 90%. Đây nên là mục tiêu cho bất kỳ nhóm kỹ sư muốn tối ưu hóa chi phí Claude nghiêm túc.
Bài học từ Spotify: tách I/O khỏi Claude để đạt token tiêu thụ thấp
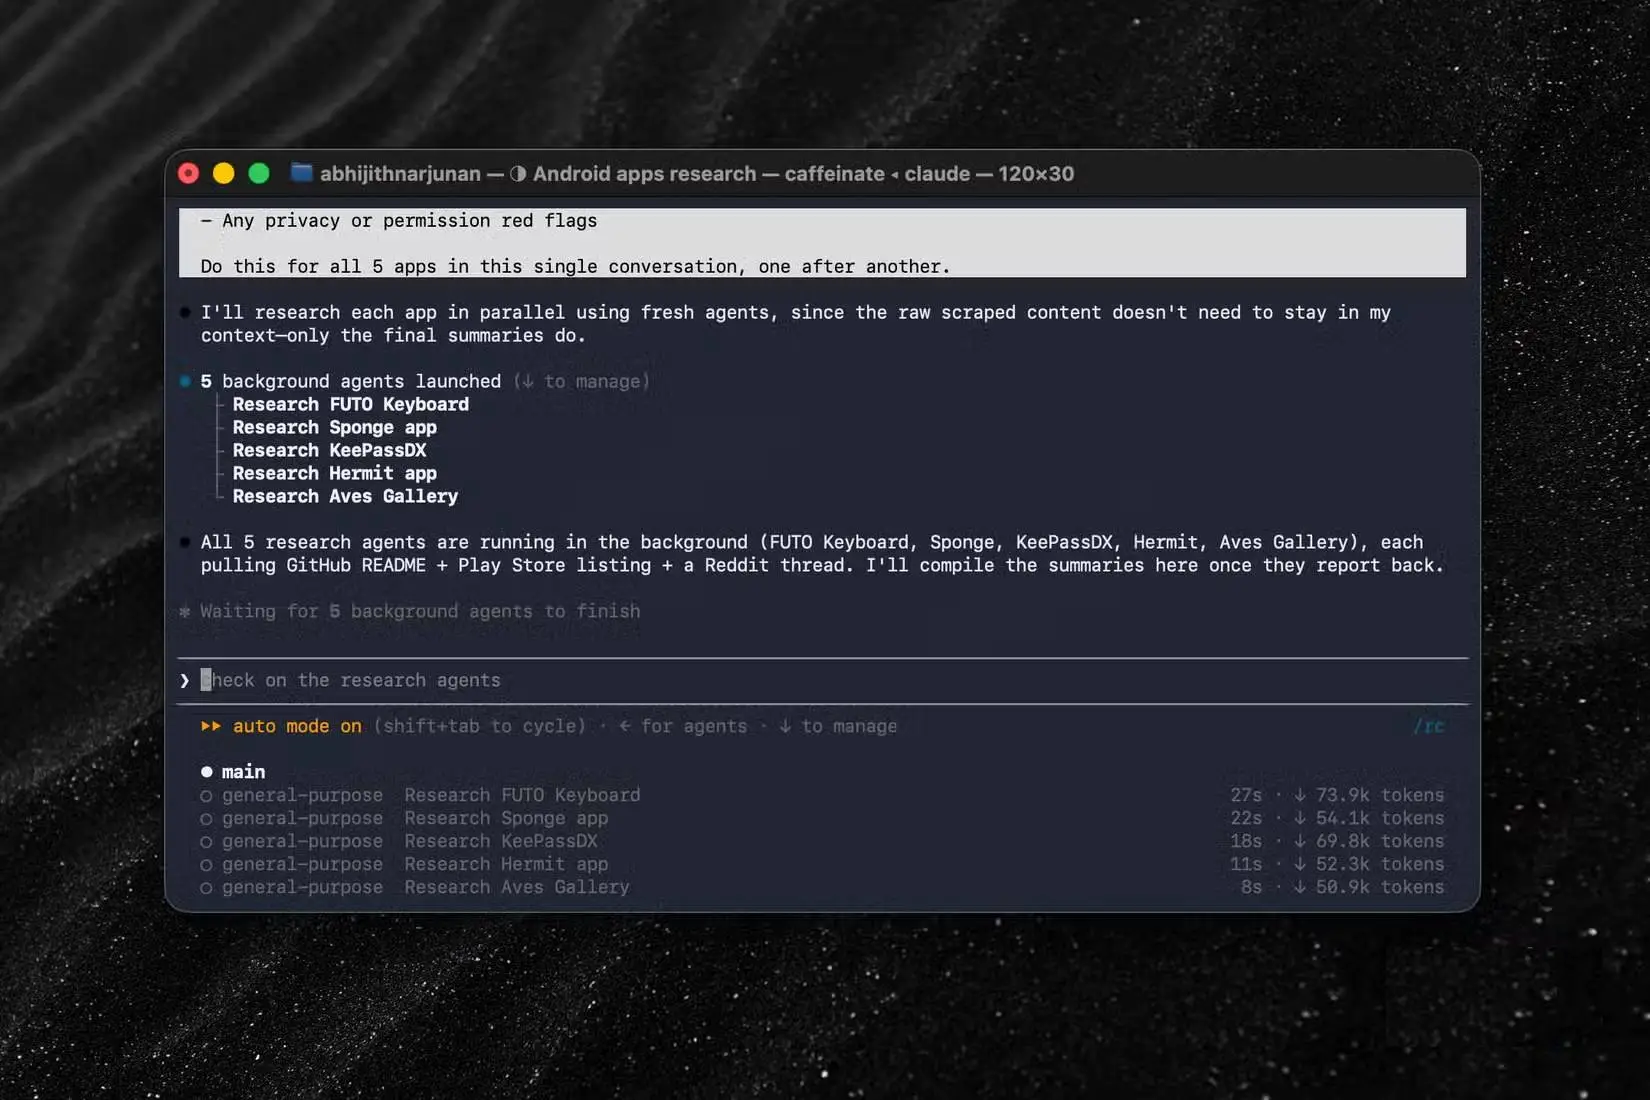
Spotify đã xây một cổng dành cho nhà phát triển để điều phối nhiều agent AiKA chạy trong môi trường runtime tạm thời, nơi lập trình viên chỉ cần chọn mô hình, chỉ dẫn và công cụ MCP cho từng mode, không phải tự quản lý hạ tầng hay API key. Trong thử nghiệm trên một monorepo Java, kỹ sư Dimitri Mazmanov tạo hai mode: “bulk reader” đọc nhiều tệp và “code writer” sinh các đoạn mã mang tính lặp lại, dễ dự đoán; cả hai dùng Google Gemini 2.5 Flash làm worker và có thể chuyển sang mô hình khác ngay trên cổng. Ý nghĩa thực tế: các agent này chủ yếu xử lý I/O, gần như không cần suy luận, nhưng nếu để Claude Code làm, chi phí token vẫn phình to. Khi tách phần I/O sang mô hình chi phí thấp hơn và để Claude xử lý phần suy luận cốt lõi, kết quả là lượng token Claude Code tiêu thụ giảm trung bình 90%. Đây là bằng chứng rõ ràng rằng tối ưu hóa chi phí Claude bắt đầu từ việc thiết kế lại luồng tác vụ, không phải từ việc cắt giảm chất lượng.
Phân loại tác vụ theo độ phức tạp: khi nào dùng mô hình chi phí thấp
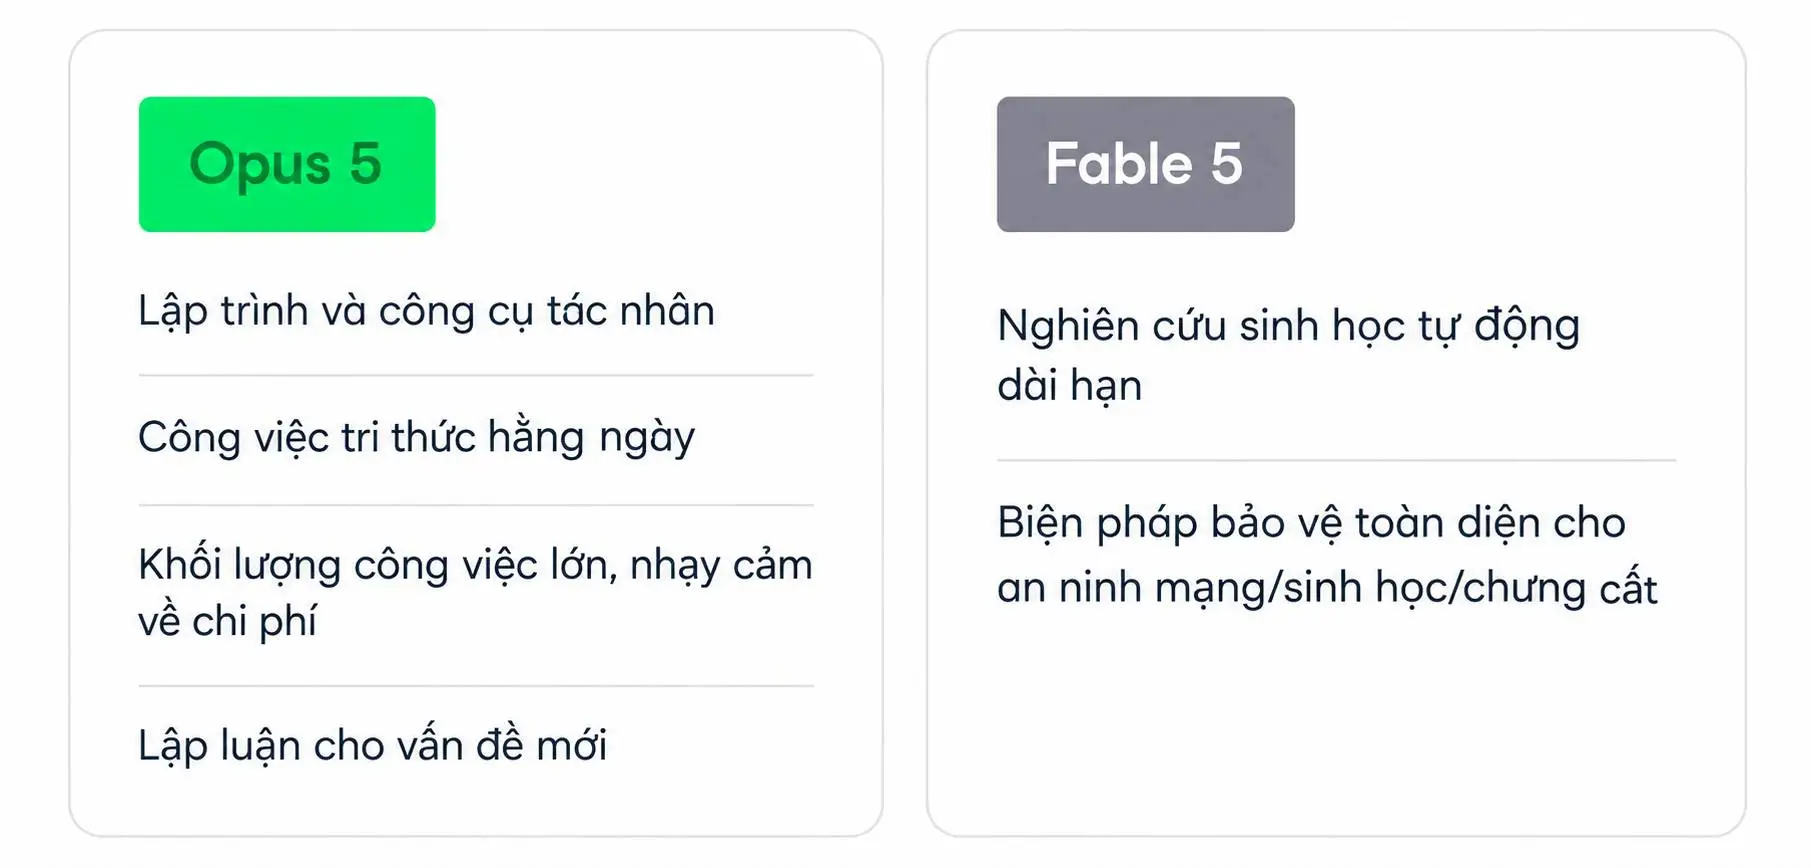
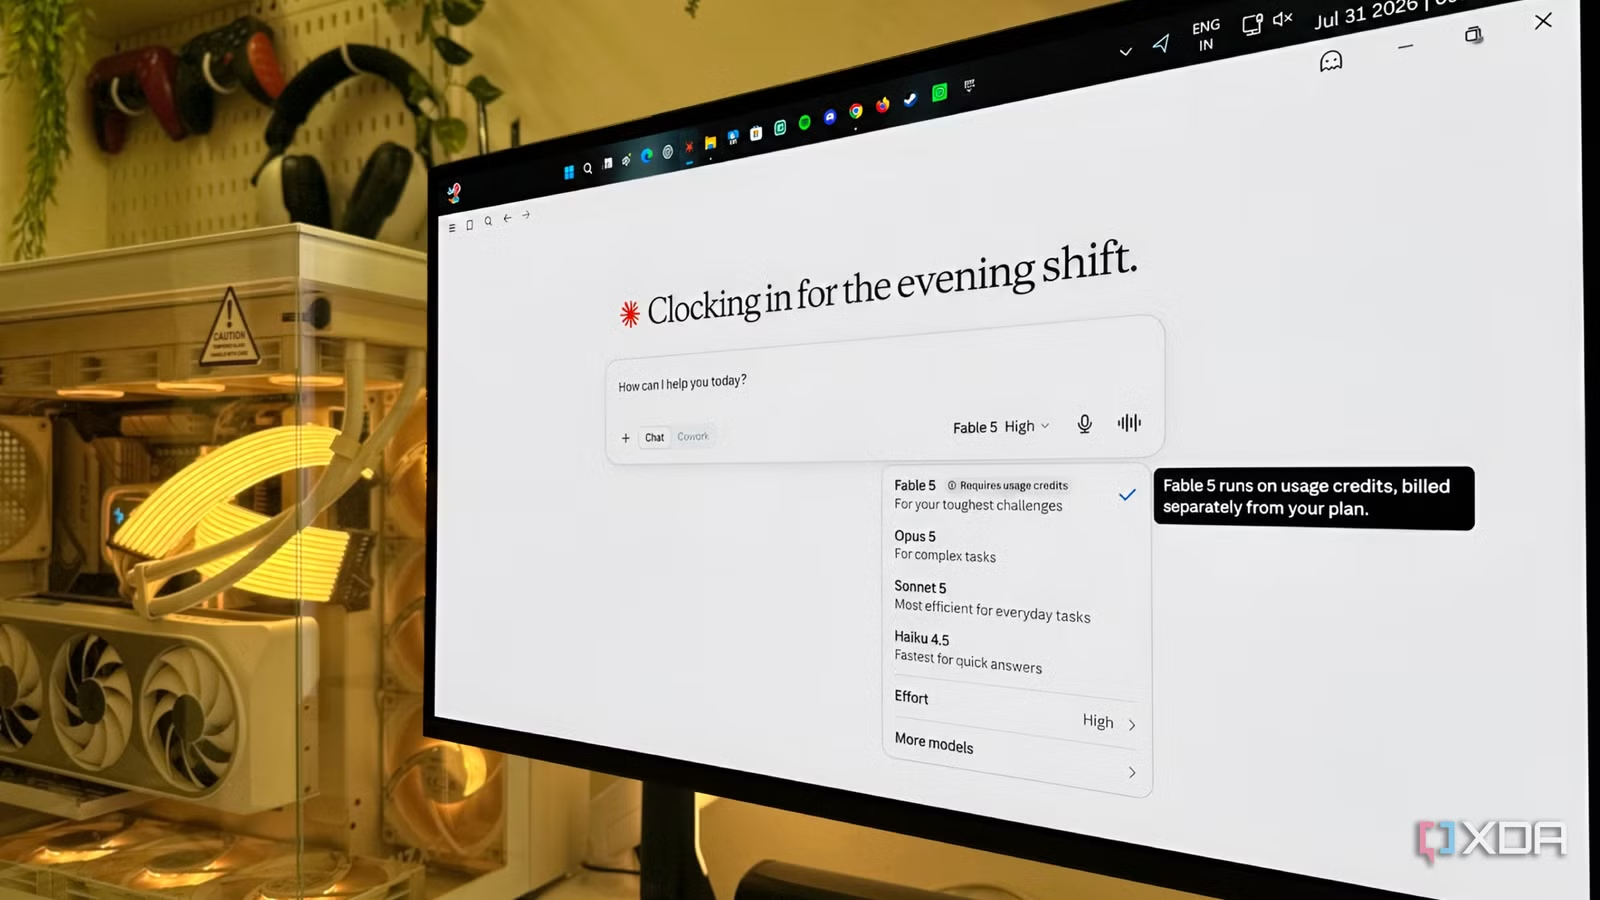
Muốn nhân rộng chiến lược của Spotify, bạn phải phân loại tác vụ theo độ phức tạp thay vì đẩy tất cả lên mô hình frontier. Với các công việc lặp lại, quy tắc rõ ràng như đọc file, trích xuất trường dữ liệu, phân loại hay tóm tắt tài liệu nằm trong giới hạn khoảng 200 nghìn token, việc bắt đầu bằng một mô hình chi phí thấp như Haiku cho khối lượng lớn xử lý đơn giản là hợp lý. Khi chất lượng của mô hình rẻ không đạt ngưỡng chấp nhận – ví dụ tóm tắt bỏ sót thông tin quan trọng hoặc phân loại sai nhiều – chỉ những yêu cầu đó mới được nâng lên Sonnet hoặc Opus. Tương tự, với coding agent: dùng Sonnet cho công việc thường ngày, để Opus xử lý các thay đổi phức tạp hoặc những yêu cầu hay thất bại ở mức thấp hơn. Spotify cũng lưu ý: mô hình worker không phù hợp cho gỡ lỗi, quyết định kiến trúc hay các tác vụ suy luận cốt lõi; nếu cố ép chúng làm, bạn sẽ trả giá bằng lỗi logic và chi phí sửa chữa.

Thiết lập tiêu chuẩn chất lượng và tránh hai sai lầm phổ biến
Tách tác vụ chỉ có ý nghĩa nếu bạn đặt tiêu chuẩn chất lượng riêng cho từng loại mô hình. Với tóm tắt và phân loại, bộ đánh giá phải gồm tài liệu dài, nhiều bảng, ranh giới phân loại mơ hồ và cả những trường hợp cần từ chối trả lời; sau đó đo tỷ lệ bỏ sót và độ chính xác trường để xem mô hình chi phí thấp có đạt yêu cầu không. Nếu thất bại, bạn mới cho phép escalat lên Sonnet hoặc Opus, và phải tính cả chi phí gọi lại lẫn độ trễ tăng trước khi kết luận chiến lược có đáng. Một sai lầm phổ biến là coi Mythos như tùy chọn cao cấp có thể dùng ngay bằng cách đổi ID; thực tế đây là mô hình chỉ được cung cấp cho nhóm người dùng được mời, nên với hầu hết tổ chức, nó phải được đánh dấu là “không sử dụng được” trong bảng quyết định. Sai lầm thứ hai là lạm dụng mô hình worker cho tác vụ suy luận cốt lõi như gỡ lỗi hay quyết định kiến trúc, điều mà Spotify khẳng định chúng không phù hợp. Nếu bạn bỏ qua hai điểm này, Claude cost optimization sẽ trở thành trò cắt giảm mù quáng và dễ phá hỏng sản phẩm.

Quy trình áp dụng: từng bước đưa chiến lược Spotify vào hệ thống của bạn
- Liệt kê toàn bộ tác vụ đang dùng Claude, chia thành nhóm I/O lặp lại (đọc file, tạo mã dễ đoán) và nhóm suy luận cốt lõi (gỡ lỗi, ra quyết định, phân tích phức tạp).
- Chọn một mô hình chi phí thấp làm worker cho nhóm I/O, ví dụ mô hình tốc độ cao, giới hạn ngữ cảnh phù hợp với khối lượng tài liệu bạn xử lý.
- Thiết lập hai mode tối thiểu, tương tự Spotify: mode đọc hàng loạt (“bulk reader”) cho việc đọc nhiều tệp, mode viết mã lặp lại (“code writer”) cho các đoạn code dễ dự đoán; cho phép đổi mô hình worker ngay trên cổng nội bộ.
- Đặt giới hạn thời gian cho mỗi lần gọi worker (Spotify sử dụng khoảng 30 giây) và kiểm thử với bộ dữ liệu thật, đo token tiêu thụ và độ chính xác để xác nhận lợi ích.
- Chỉ sau khi xác nhận mô hình chi phí thấp đạt tiêu chuẩn, mới triển khai rộng; còn các tác vụ thất bại lặp lại thì đưa lên Sonnet, Opus hoặc Fable và tiếp tục đánh giá. Mythos, nếu không có lời mời, phải bị loại khỏi lựa chọn.
Nếu bạn làm đủ các bước này với kỷ luật tốt, kết quả hợp lý là giảm mạnh chi phí token ở những tác vụ lặp lại, trong khi vẫn giữ chất lượng cho công việc suy luận cốt lõi. Spotify đã chứng minh mức giảm trung bình 90% token Claude Code là khả thi khi phần I/O được tách riêng và giao cho mô hình chi phí thấp hơn. Trong các kịch bản xử lý lặp lại 10.000 lần cùng một yêu cầu, chênh lệch chi phí giữa các mô hình cho thấy việc chọn sai lớp mô hình có thể khiến tổ chức tiêu tốn nguồn lực khổng lồ mà không đem lại thêm giá trị. Kết luận thực tế: tối ưu hóa chi phí Claude không phải là cắt bớt AI, mà là đặt đúng mô hình cho đúng loại tác vụ.