
AI tác tử không còn nhất thiết phải ở trên đám mây
Nemotron Bolt là dòng mô hình AI của NVIDIA được hậu huấn luyện để xử lý tác vụ như gọi công cụ, làm theo chỉ dẫn và tạo đầu ra có cấu trúc, với các bản phát hành hướng đến những mức phần cứng khác nhau. Điểm đáng chú ý không chỉ nằm ở thông số: một trải nghiệm thực tế cho thấy máy tính chơi game có GPU 16 GB vẫn có thể chạy Bolt như một tác tử cục bộ, nhận việc nhiều bước và hoàn thành với độ chính xác được đánh giá là hợp lý. Đây là thay đổi đáng kể đối với người dùng PC vốn quen xem AI cục bộ như một mô hình đơn lẻ cho từng công việc, còn tác tử biết lập kế hoạch, duyệt web và hành động thì thuộc về dịch vụ đám mây đắt đỏ. Tuy nhiên, cần phân biệt hai sản phẩm cùng tên: trải nghiệm trên GPU 16 GB trong bài thử là với Bolt 74B-A9B, còn bản E4B nhỏ hơn có hồ sơ phát hành riêng.
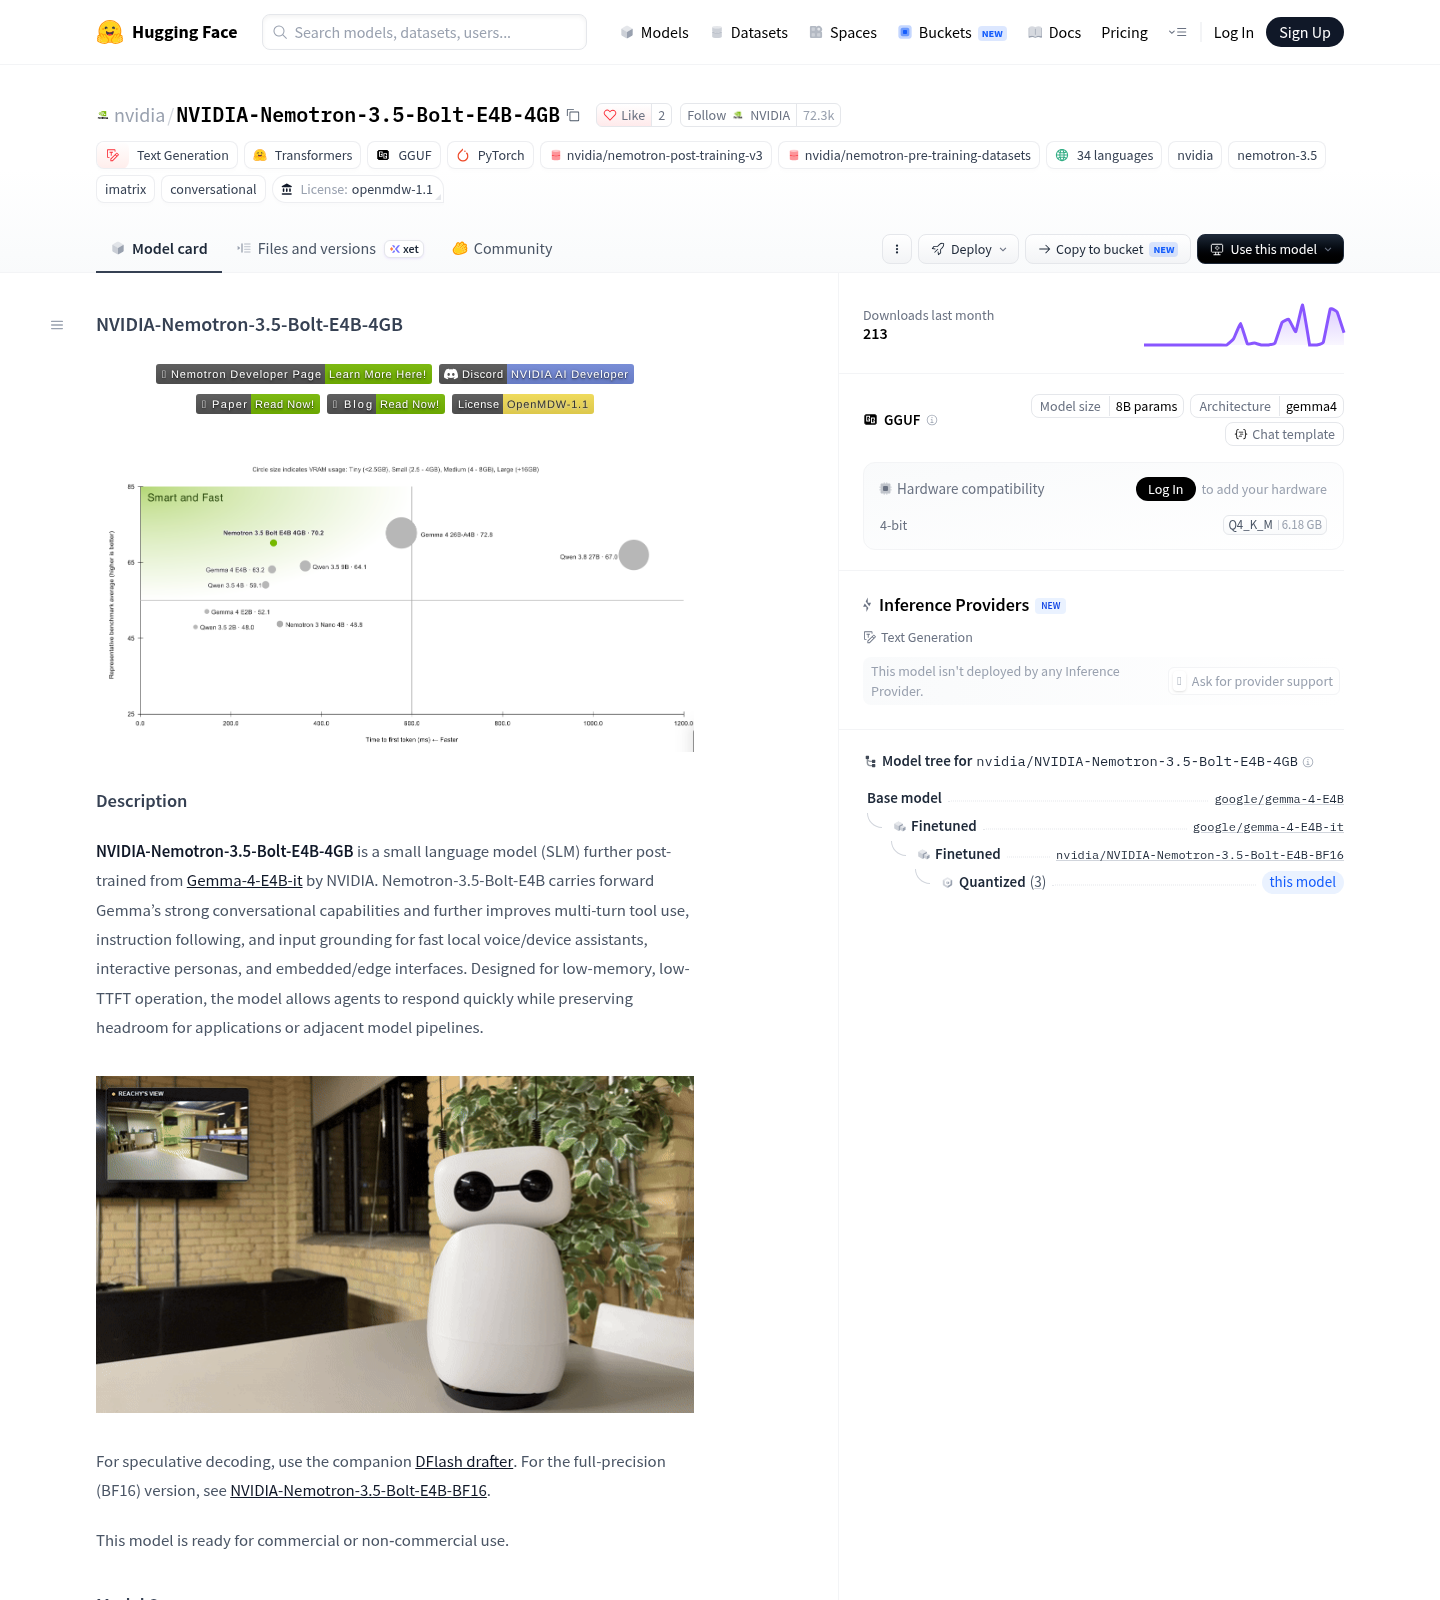
NVIDIA công bố trọng số Q4_K_M và BF16 của Nemotron 3.5 Bolt E4B trên kho lưu trữ Hugging Face ngày 23 tháng 10 năm 2026, đồng thời đăng thẻ mô hình, bài viết kỹ thuật và báo cáo kỹ thuật. Bản E4B được hậu huấn luyện từ Gemma-4-E4B-it; trong khi đó, Bolt 74B-A9B được giới thiệu là mô hình 74 tỷ tham số, có 9 tỷ tham số hoạt động và thiết kế hướng đến mức bộ nhớ 24 GB với trọng số 2 bit. Sự phân biệt này quan trọng: bằng chứng chạy trên GPU 16 GB không nên bị gán nhầm cho E4B, và con số 4 GB trong tên E4B cũng không phải kích thước tệp tải xuống.
GPU 16 GB có thể chạy tác tử, nhưng không bằng một cú nhấp chuột
Trong thử nghiệm với Bolt 74B-A9B, người dùng chạy mô hình trên GPU 16 GB cùng 32 GB RAM hệ thống và cấu hình llama.cpp phù hợp. Bản GGUF chính thức tải xuống gần 24 GB, vượt VRAM của card; bản llama.cpp cũ cũng không đọc được cách bố trí chuyên gia của mô hình, nên phải chuyển sang bản dựng có hỗ trợ Bolt. Tùy chọn --fit tự phân bổ phần chạy trên GPU và bộ nhớ hệ thống, đưa mức dùng VRAM lên 15,7 GB. Khi toàn bộ lớp chuyên gia nằm trên CPU, tốc độ đạt 19 token mỗi giây; cấu hình được tự điều chỉnh chạy ở 22–32 token mỗi giây, với xử lý lời nhắc 110 token mỗi giây.
Kết quả ấy đủ sức thuyết phục cho người thích vọc AI cục bộ: một máy chơi game có thể nhận yêu cầu nhiều bước thay vì chỉ trả lời câu hỏi đơn lẻ. Nhưng đây không phải lời hứa rằng mọi GPU 16 GB sẽ chạy nhanh như nhau. Bài thử còn cho thấy LiLiCorr, mô hình phụ dùng cho giải mã suy đoán, làm giảm tốc độ trên cấu hình này vì chiếm VRAM cần cho các lớp chuyên gia; tính năng đã bị tắt. Bài học thực tế là bộ nhớ hệ thống, phiên bản phần mềm và cách phân bổ tải đều quan trọng. Mô hình mở có thể giảm phụ thuộc vào đám mây, nhưng thiết lập vẫn cần kiến thức và thử nghiệm.
Tệp E4B 6,18 GB không đồng nghĩa cần đúng 6,18 GB VRAM
Bản Q4_K_M GGUF của E4B có dung lượng chính xác 6.180.446.208 byte, tương đương 6,18 GB theo hệ thập phân; bản BF16 lớn hơn, ở mức 15,88 GB. Kho lưu trữ không có tệp nào đúng 4 GB, cũng không có bản lượng tử hóa nhỏ hơn được liệt kê. Con số 4 GB là ngân sách bộ nhớ mục tiêu mà NVIDIA mô tả cho khối lượng công việc, không phải kích thước tải xuống. Cũng không thể suy ra VRAM cần thiết bằng cách nhìn dung lượng tệp: trong các phép đo do NVIDIA công bố, mức dùng VRAM của E4B thấp hơn kích thước GGUF, cho thấy runtime không giữ toàn bộ tệp thường trú trên GPU.
Các số đo đó phụ thuộc phần cứng và runtime, vì vậy 4 GB không phải thuộc tính cố định của bản tải xuống hay cam kết rằng mọi cấu hình đều chạy được với mức bộ nhớ ấy. Kiểm tra thẻ mô hình và kho lưu trữ xác nhận rõ các định dạng, kích thước và nguồn gốc Gemma 4, nhưng bằng chứng hiệu năng vẫn cần được đọc thận trọng. Chưa có đánh giá độc lập được nêu cho E4B; thẻ mô hình cũng lưu ý kết quả có thể khác số liệu do nhà cung cấp tự báo cáo, còn bộ so sánh do NVIDIA lựa chọn. Đây là giới hạn đáng kể của một bản phát hành mới: tài liệu kỹ thuật đầy đủ giúp người dùng bắt đầu, nhưng chưa thay thế được tái lập từ bên thứ ba.
Mô hình mở giúp người dùng PC tự thử, nhưng bằng chứng còn tiếp tục được bổ sung
Với người dùng GeForce, ý nghĩa lớn nhất của Nemotron Bolt là AI cục bộ không còn chỉ dành cho việc trò chuyện với một mô hình nhỏ. Trải nghiệm Bolt 74B-A9B cho thấy GPU 16 GB có thể tham gia chạy một tác tử thực hiện việc nhiều bước, dù phải dựa vào RAM hệ thống, phần mềm tương thích và cấu hình phù hợp. E4B lại đem đến lựa chọn tải xuống nhẹ hơn, nhưng không nên đồng nhất kích thước tệp với nhu cầu VRAM hay xem tên 4GB như một bảo đảm. Các giấy phép được nêu gồm OpenMDW-1.1 cho phần đóng góp của NVIDIA và Apache 2.0 cho thành phần Gemma 4; thẻ mô hình cho biết mô hình sẵn sàng dùng thương mại hoặc phi thương mại. Điều đó khiến bản phát hành đáng để người dùng PC khám phá, song vẫn cần đọc kỹ điều kiện và kiểm chứng hiệu năng trên máy của mình.
Những dữ liệu hiện có chưa khép lại câu chuyện. Hai đánh giá Brevity Bench và When2Call Multi-Turn được NVIDIA mô tả là nhằm xử lý khoảng trống của các chuẩn đánh giá hiện có, nhưng dự kiến công bố sau đó; đồng thời chưa có giá dịch vụ lưu trữ được công bố. Vì thế, kết luận hợp lý không phải là mọi người dùng đều có thể thay thế dịch vụ đám mây bằng một GPU phổ thông. Thay vào đó, Bolt cho thấy một cánh cửa đã mở: người có phần cứng phù hợp có thể thử mô hình mã nguồn mở và tác tử chạy tại chỗ, miễn là hiểu rõ giới hạn bộ nhớ, tốc độ và mức độ độc lập của các phép đo. Đó là bước tiến thực chất, nhưng chưa phải câu trả lời cuối cùng.