
Bản quyền AI: vấn đề không nằm ở bản thân thuật toán mà ở cách dùng tác phẩm gốc
Bản quyền AI là tập hợp các quy định pháp lý và chuẩn mực xã hội nhằm xác định ranh giới giữa quyền tác giả của con người và việc sử dụng tác phẩm có bảo hộ để huấn luyện mô hình trí tuệ nhân tạo, bao gồm điều kiện được coi là xâm phạm, phạm vi “sử dụng hợp lý”, và khả năng bảo hộ đối với nội dung do AI tạo ra. Những phán quyết gần đây của tòa án Mỹ cho thấy trọng tâm không còn nằm ở câu hỏi “AI có được học từ tác phẩm có bản quyền hay không”, mà ở cách thức lấy dữ liệu, mục tiêu huấn luyện mô hình và sản phẩm cuối cùng có cạnh tranh trực tiếp với tác phẩm gốc hay không. Nói cách khác, điều quyết định trách nhiệm pháp lý không phải là việc máy học, mà là ý đồ và hành vi của con người đứng sau hệ thống.
Một vụ việc điển hình là tranh chấp giữa các tác giả và công ty Anthropic liên quan đến việc dùng sách có bản quyền để huấn luyện mô hình ngôn ngữ. Trong vụ này, thẩm phán William Alsup của tòa án liên bang khu vực Bắc California đã chấp nhận quan điểm rằng việc dùng sách có bảo hộ để huấn luyện AI, trong một số điều kiện, có thể thuộc phạm vi “sử dụng hợp lý” vì mang tính biến đổi và không nhằm sao chép nguyên trạng tác phẩm. Đồng thời, tòa vẫn chỉ ra rằng cách thức thu thập dữ liệu – tải xuống hàng triệu bản từ thư viện “bóng tối” và lưu trữ dài hạn – là một hành vi tách biệt, có thể cấu thành xâm phạm bản quyền riêng biệt. Phán quyết này đặt ra thông điệp rõ ràng: bản quyền AI không miễn trừ doanh nghiệp khỏi trách nhiệm về nguồn dữ liệu huấn luyện mô hình, kể cả khi mục đích kỹ thuật nghe có vẻ chính đáng.
Tòa án Mỹ: phân rã trách nhiệm pháp lý theo từng khâu trong vòng đời AI
Điểm đáng chú ý trong cách tòa án Mỹ xử lý bản quyền AI là việc họ “bóc tách” trách nhiệm pháp lý ở từng khâu: thu thập dữ liệu, huấn luyện mô hình, triển khai dịch vụ và khai thác nội dung do AI tạo. Đối với huấn luyện mô hình, các thẩm phán áp dụng khung “sử dụng hợp lý” truyền thống: xem xét mục đích và bản chất việc dùng tác phẩm, loại hình tác phẩm, tỉ lệ và độ quan trọng phần nội dung được dùng, cũng như tác động tới thị trường của bản gốc. Nếu kết quả huấn luyện dẫn tới một dịch vụ cạnh tranh trực tiếp với nguồn dữ liệu, khả năng bị coi là vi phạm sẽ cao hơn; ngược lại, nếu không cạnh tranh và có tính biến đổi mạnh, cửa hợp pháp được mở rộng.
Cách tiếp cận này thể hiện rõ trong vụ kiện giữa Thomson Reuters và Ross Intelligence: tòa án đã bác bỏ lập luận “sử dụng hợp lý” khi Ross dùng dữ liệu pháp lý của đối thủ để xây dựng dịch vụ tra cứu cạnh tranh, vì mục đích khai thác thị trường rõ ràng. Ngược lại, chỉ riêng việc các tác giả lo ngại chatbot AI có thể ảnh hưởng thu nhập của họ chưa đủ để bác bỏ tính biến đổi của quá trình huấn luyện. Quan trọng hơn, tòa án Mỹ khẳng định AI không thể là tác giả; trong một vụ việc về đăng ký bản quyền cho tác phẩm do hệ thống tự động tạo ra, tòa phúc thẩm liên bang đã tuyên rằng chỉ những tác phẩm có sự tham gia sáng tạo của con người mới được bảo hộ, và tòa tối cao từ chối xem xét lại phán quyết này. Câu nói có thể trích dẫn là: “AI system itself cannot be an author under copyright law.”
Việt Nam: nội dung do AI tạo chỉ được bảo hộ khi con người giữ vai trò quyết định
Trong khi tòa án Mỹ đang xây dựng chuẩn mực thông qua án lệ, Việt Nam chọn cách đi thẳng vào văn bản luật: tác giả phải là con người. Luật Sở hữu trí tuệ quy định rõ đơn đăng ký sáng chế, kiểu dáng công nghiệp sẽ bị từ chối hoặc bị hủy hiệu lực nếu có cơ sở cho rằng “tác giả không phải là con người” hoặc không trực tiếp sáng tạo ra đối tượng. Các nghị định hướng dẫn tiếp tục nhấn mạnh rằng quyền đối với sáng chế, kiểu dáng, thiết kế bố trí được tạo bằng hệ thống AI chỉ được xác lập khi con người có “đóng góp đáng kể” vào quá trình sáng tạo. Đối với bản quyền tác giả, nội dung do AI tạo chỉ phát sinh quyền nếu con người vừa đóng góp đáng kể, mang tính quyết định, vừa chịu trách nhiệm về nội dung và tính hợp pháp của sản phẩm.
Điều đó có nghĩa: nếu một tác phẩm văn học, tác phẩm nghệ thuật, mã nguồn phần mềm hay giải pháp kỹ thuật được tạo ra hoàn toàn bởi hệ thống AI, không có sự can thiệp sáng tạo đáng kể của con người, thì sẽ không làm phát sinh quyền tác giả hay quyền liên quan. Đây là một quan điểm pháp lý mạnh, bảo vệ giá trị sáng tạo của lao động trí tuệ con người và tránh việc quyền bản quyền bị “loãng” bởi những thao tác nhập vài từ khóa. Tuy nhiên, tiêu chí “đóng góp đáng kể và mang tính quyết định” vẫn mang tính định tính và khó lượng hóa. Nếu không có bộ quy tắc thẩm định rõ ràng, nguy cơ tranh chấp kéo dài và cách hiểu tùy tiện trong thực tiễn là rất lớn. Theo phân tích tại một hội thảo chuyên đề về sở hữu trí tuệ trong kỷ nguyên AI, việc hoàn thiện khung đánh giá này là cấp thiết để bản quyền AI không trở thành vùng xám pháp lý.
Khoảng trống minh bạch dữ liệu và bài toán chiến lược cho startup AI Việt Nam
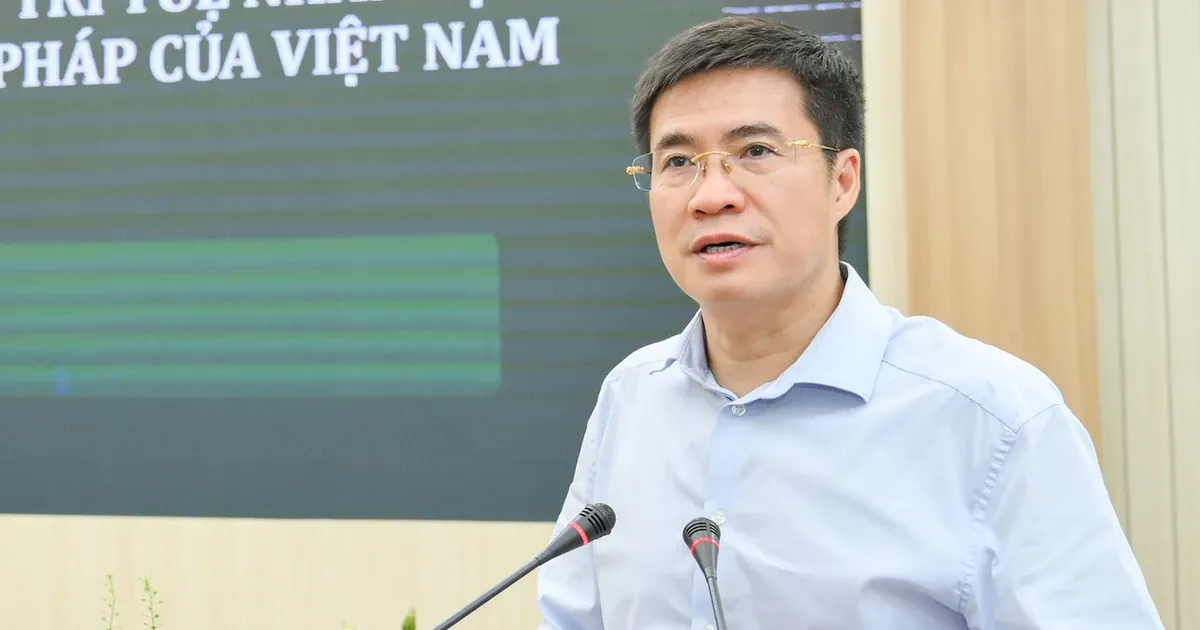
Một câu hỏi lớn được đặt ra ngay tại hội thảo về “bảo hộ quyền sở hữu trí tuệ trên môi trường số” là: sử dụng tác phẩm có bản quyền để huấn luyện mô hình AI mà không xin phép, không trả tiền có phải hành vi xâm phạm không? Ngay cả khi câu trả lời là “có”, chủ thể quyền khó có thể kiểm chứng tác phẩm của mình đã bị dùng hay chưa nếu nhà phát triển không công bố dữ liệu huấn luyện mô hình. Khung pháp lý hiện hành của Việt Nam dù đã khẳng định nguyên tắc con người là trung tâm, vẫn thiếu nghĩa vụ minh bạch dữ liệu huấn luyện và hạ tầng để vận hành các cơ chế như quyền bảo lưu hay nghĩa vụ trả tiền bản quyền trên thực tế.
Đối với startup và công ty công nghệ Việt Nam, bản quyền AI không còn là vấn đề “xa xôi” mà là rủi ro chiến lược. Nếu doanh nghiệp chọn huấn luyện mô hình trên dữ liệu thu thập không rõ nguồn gốc, họ đang phó mặc tương lai cho những phán quyết của tòa án giống như các vụ kiện tại Mỹ. Ngược lại, nếu chủ động thiết kế quy trình thu thập dữ liệu có ghi nhận nguồn, xây dựng cơ chế xin phép – chia sẻ lợi ích với chủ thể quyền, họ không chỉ giảm rủi ro pháp lý mà còn tạo lợi thế cạnh tranh khi thị trường toàn cầu dịch chuyển sang yêu cầu đạo đức dữ liệu cao hơn. Năng lực thích ứng mà Việt Nam thể hiện qua việc nhanh chóng ban hành ba đạo luật nền tảng về sở hữu trí tuệ sẽ chỉ trở thành lợi thế nếu cộng đồng doanh nghiệp coi bản quyền AI là một phần cốt lõi trong chiến lược sản phẩm chứ không phải thủ tục pháp lý phụ.
Kết luận: luật chưa bắt kịp AI, nhưng doanh nghiệp không thể chờ đợi
Dù khác nhau về kỹ thuật, cả hệ thống pháp luật Mỹ và Việt Nam đang gửi chung một thông điệp: trí tuệ nhân tạo không tự mình gánh bản quyền hay trách nhiệm pháp lý, chính con người và doanh nghiệp đứng sau mới là đối tượng phải trả lời trước tòa. Án lệ Mỹ cho thấy tòa sẽ mổ xẻ mục đích huấn luyện mô hình và tác động thị trường của sản phẩm; pháp luật Việt Nam khẳng định chỉ nội dung do AI tạo có sự đóng góp đáng kể và quyết định của con người mới được bảo hộ. Trong bối cảnh Quốc hội Việt Nam tiếp tục được kỳ vọng hoàn thiện khung pháp lý và tăng cường hiệu quả thực thi, các công ty công nghệ không thể chờ luật đi trước. Bản quyền AI, huấn luyện mô hình và trách nhiệm pháp lý phải được xem là trụ cột thiết kế sản phẩm ngay từ ngày đầu – nếu không, cái giá phải trả sẽ không chỉ là tiền, mà là niềm tin, thị trường và cơ hội phát triển lâu dài.