
Từ mô hình AI nhẹ đến kiến trúc video: câu hỏi không còn là “mạnh hơn” mà là “chạy ở đâu”
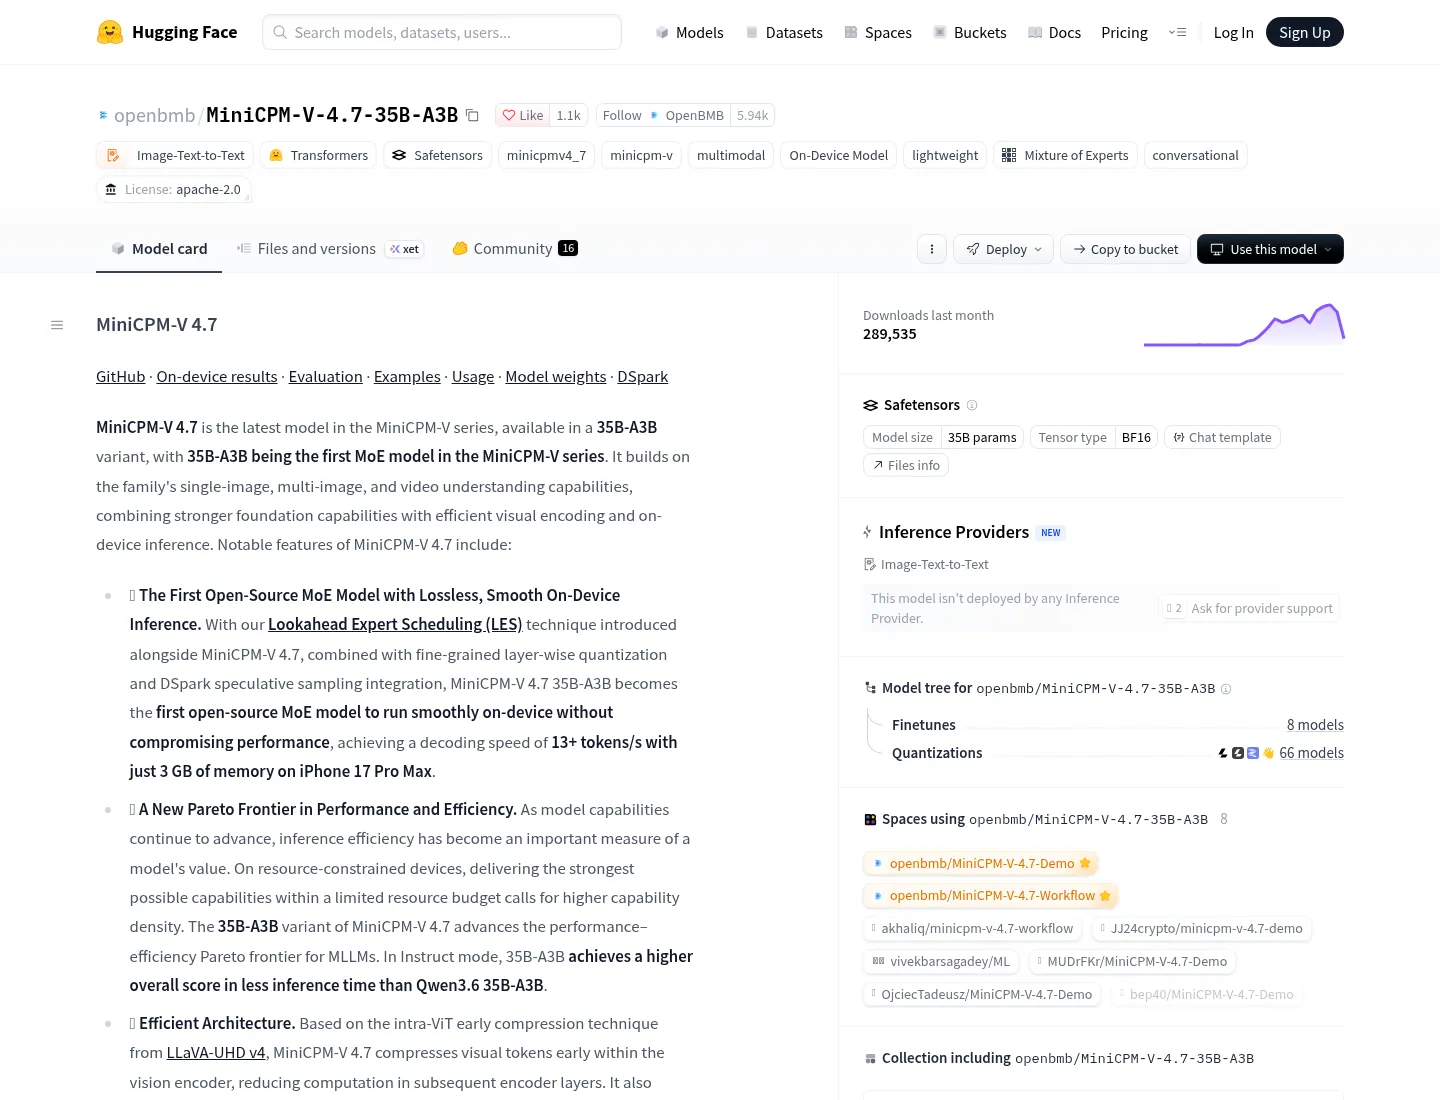
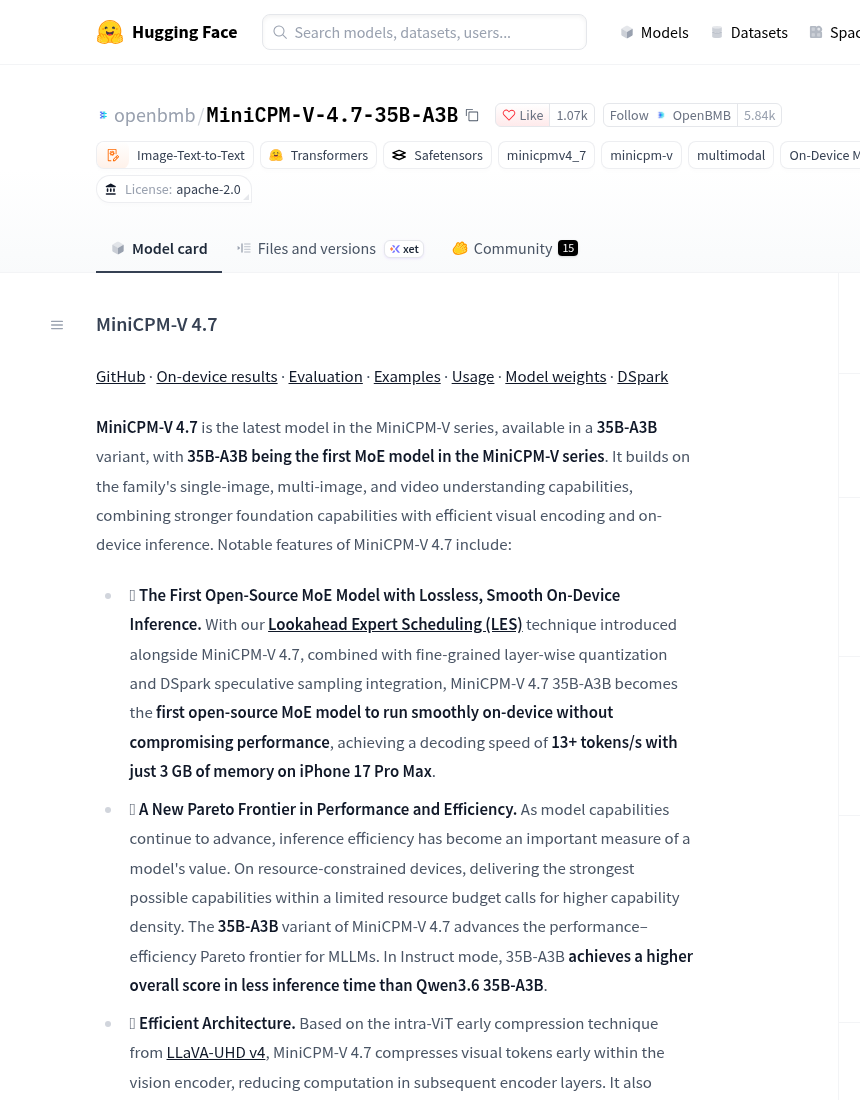
So sánh MiniCPM-V 4.7 và Qwen3.8-Omni-Flash trong xử lý video điện thoại là so sánh hai triết lý triển khai mô hình AI nhẹ: một bên đặt toàn bộ suy luận lên thiết bị với khoảng 3 GB bộ nhớ thường trú, ưu tiên độ trễ thấp và quyền riêng tư; bên kia gom văn bản, hình ảnh, âm thanh và video vào một cửa sổ 1 triệu token qua API cloud, ưu tiên băng thông phân tích khối lượng lớn và ngữ cảnh kéo dài hàng giờ. MiniCPM-V 4.7 35B-A3B là mô hình thị giác-ngôn ngữ dạng mixture-of-experts thưa, tổng 35,2 tỷ tham số, mỗi token kích hoạt khoảng 3 tỷ tham số, nhận văn bản, ảnh đơn, bộ nhiều ảnh và video, trả lời bằng văn bản, chạy trực tiếp trên iOS, Android, HarmonyOS hoặc GPU cạnh bàn với giấy phép Apache-2.0. Qwen3.8-Omni-Flash là mô hình toàn mô thức qua API, hỗ trợ ngữ cảnh 1 triệu token, đầu vào văn bản, hình ảnh, âm thanh, video (kể cả âm thanh không gian nhiều kênh), đầu ra chỉ văn bản, tối ưu cho các tác vụ dài tới một giờ audio hoặc audio+video liên tục trong một lần gọi. Điểm mấu chốt: bạn không chọn “mô hình tốt hơn”, bạn chọn nơi phép tính diễn ra. Nếu nhóm của bạn đang quay, cắt, chú thích video mỗi ngày, quyết định kiến trúc gần như được định trước bởi việc bạn muốn tính toán nằm trong túi người dùng hay trong trung tâm dữ liệu.
| Thông số | MiniCPM-V 4.7 35B-A3B | Qwen3.8-Omni-Flash |
|---|---|---|
| Kiểu mô hình | Mixture-of-experts thị giác-ngôn ngữ thưa, 35,2B tham số, ~3B tham số hoạt động mỗi token | Mô hình toàn mô thức qua API, hỗ trợ văn bản, hình ảnh, âm thanh, video |
| Vị trí chạy | AI trên thiết bị: điện thoại iOS/Android/HarmonyOS, hoặc GPU cạnh bàn | Chỉ chạy trên hạ tầng cloud, truy cập qua API của nhà cung cấp |
| Ngữ cảnh tối đa | Bị giới hạn bởi bộ nhớ thiết bị và ngân sách sampling, xử lý từng lượt gợi ý | Cửa sổ 1.000.000 token, đầu vào ~991K, đầu ra tối đa 131K, ngân sách suy luận 262K |
| Đa mô thức | Nhận văn bản, ảnh đơn, nhiều ảnh, video; xuất văn bản | Nhận văn bản, ảnh, âm thanh, video (kể cả âm thanh không gian); xuất văn bản |
| Chi phí | Chi phí phần cứng và điện; tải về GGUF Q4_K_M ~21,2 GB, bộ nhớ thường trú ~3 GB trên điện thoại | Chi phí theo token qua API, không công bố bằng VND trong nguồn; tối ưu cho khối lượng lớn |
| Thông lượng công bố | Khoảng 13+ token/s trên iPhone 17 Pro Max với ~3 GB bộ nhớ; tối đa 20,51 token/s trên iPhone 18 Pro Max với các tối ưu trên thiết bị | Thông lượng phụ thuộc hạ tầng cloud; nguồn nhấn mạnh khả năng xử lý một giờ audio/video trong một lần gọi |
MiniCPM-V 4.7: AI trên thiết bị cho xử lý video điện thoại, nhưng không phải máy nghiền một giờ video
Nếu bạn tin rằng phần lớn công việc thị giác nên diễn ra ngay nơi camera đặt — trên điện thoại thay vì trên server — MiniCPM-V 4.7 là tuyên ngôn kỹ thuật rõ ràng. Mô hình này giữ khoảng 3 tỷ tham số thường trú và stream phần còn lại của các expert khi bộ định tuyến yêu cầu, dùng Lookahead Expert Scheduling để nạp trước expert có khả năng cần và chồng lấn việc nạp với tính toán đang chạy. Đó là cách một mô hình 35B có thể hành xử như mô hình AI nhẹ trong khoảng 3 GB bộ nhớ trên thiết bị. Nhà phát triển công bố thông lượng 13+ token/s trên iPhone 17 Pro Max với ~3 GB bộ nhớ, và bảng đo riêng cho iPhone 18 Pro Max cho thấy mức 20,51 token/s khi bật đủ Lookahead Expert Scheduling, độ chính xác hỗn hợp và draft head DSpark. Câu quote đáng nhớ ở đây là: "Từ 3,38 lên 20,51 tok/s là mức tăng 6 lần trên cùng một loại thiết bị, đạt được bằng cách xếp chồng ba kỹ thuật thay vì nhờ một chip lớn hơn." Nhưng chúng ta phải thẳng thắn: OpenBMB không hề công bố con số 100 tok/s cho MiniCPM-V 4.7, và bất kỳ ai lập kế hoạch như thể con số đó là thật sẽ vỡ kế hoạch. Một giờ video lấy mẫu mỗi giây một khung tương đương 3.600 ảnh; với 13–20 token/s trên điện thoại, đó không phải một lần gọi duy nhất mà là quy trình phân lô, lấy mẫu, xử lý dần và tóm tắt, tiêu tốn hàng giờ thời gian thực trên phần cứng bạn đã có. MiniCPM-V 4.7 tỏa sáng ở các lượt xem ngắn, kiểm tra nhanh, lọc sơ bộ trên thiết bị; nó không được sinh ra để nuốt trọn hàng giờ nội dung trong một hơi.
Qwen3.8-Omni-Flash: API cloud triệu token cho ca video dài, nhưng là chi phí theo token chứ không miễn phí
Ở phía đối diện là Qwen3.8-Omni-Flash, mô hình toàn mô thức được thiết kế xoay quanh cửa sổ 1 triệu token và khái niệm "một lần gọi xử lý một giờ audio/video". Nó cho phép đầu vào văn bản, hình ảnh, âm thanh, video — kể cả âm thanh stereo và bốn kênh không gian — với đầu ra chỉ là văn bản, và được cung cấp duy nhất qua API cloud. Kiến trúc này không quan tâm đến việc mô hình có vừa trong 3 GB hay không; nó quan tâm đến việc bạn có thể gửi cả cuộc họp, buổi đào tạo hoặc bản ghi livestream dài một giờ trong một yêu cầu. Dữ liệu công bố cho thấy Qwen3.8-Omni-Flash cải thiện trung bình hơn 26% so với thế hệ Qwen3.5-Omni-Plus trên khoảng ba mươi bộ đánh giá, với bước nhảy lớn nhất trên WildClawBench-MM (đạt 71,0, tăng 36,5 điểm) và trên bài toán tách người nói AliMeeting, nơi tỷ lệ lỗi giảm từ 88,11 xuống 3,35 và cpWER từ 89,61 xuống 17,18. Mô hình còn có chế độ Agentic Understanding: nó tự chọn khung hình cần xem thay vì xử lý mọi khung, và trên OmniVideoBench, chế độ này nâng độ chính xác từ 63,4 lên 67,8 đồng thời giảm số token mỗi truy vấn từ 145.736 xuống 79.117, tức giảm 45,7%. Điều cần cảnh giác: tất cả những con số này đến từ chính nhà cung cấp và chưa được bên thứ ba độc lập tái lập. Bạn đang mua vào một lời hứa hiệu năng cloud cho khối lượng lớn, nhưng vẫn phải tự kiểm chứng trên dữ liệu của mình trước khi xây cả hệ thống quanh nó.
Chi phí, quyền riêng tư và sự thật về benchmark: chọn bên nào cho kịch bản video của bạn?
Khi nói về chi phí, cả hai mô hình đều không miễn phí — nhưng chúng "tính bằng hai loại tiền khác nhau". MiniCPM-V 4.7 tính bằng phần cứng, dung lượng đĩa (tải GGUF Q4_K_M khoảng 21,2 GB) và thời gian suy luận trên thiết bị với ~3 GB bộ nhớ thường trú; mỗi lần gọi không phát sinh phí API, nhưng bạn trả bằng pin, nhiệt và độ trễ. Qwen3.8-Omni-Flash tính bằng token qua API; nguồn không cung cấp giá bằng VND, nên điều duy nhất ta có thể nói là nó được định vị như giải pháp chi phí thấp cho khối lượng audio/video dài, với lợi thế là xử lý một giờ nội dung trong một lần gọi trong cửa sổ 1 triệu token. Điểm phân chia thực sự không nằm ở độ chính xác mà ở mức dùng và quyền riêng tư. Nếu khung hình không được phép rời khỏi phòng khám, nếu bạn cần AI trên thiết bị để chạy offline, hoặc nếu chi phí theo lần gọi là thứ phá vỡ đơn vị kinh tế của sản phẩm, bạn gần như buộc phải chọn MiniCPM-V 4.7 cho lớp xử lý đầu tiên. Ngược lại, nếu bạn có hàng trăm giờ nội dung mỗi tháng, việc trích xuất chúng về điện thoại là bài toán mua sắm phần cứng và lịch trình, trong khi gửi hàng trăm cuộc gọi một giờ lên API lại là một dòng chi phí đơn. Cả hai mô hình chia sẻ một điểm yếu: chúng chưa xuất hiện trên bất kỳ bảng xếp hạng đa mô thức được kiểm toán độc lập nào, và MiniCPM-V 4.7 chỉ có vài biểu đồ đánh giá không kèm bảng số chi tiết, trong khi toàn bộ số liệu của Qwen3.8-Omni-Flash đều do nhà cung cấp tự báo cáo. Trong bối cảnh đó, mọi benchmark hào nhoáng — như tweet về 100 tok/s trên điện thoại — phải được xem là giả định cho đến khi có phép đo độc lập nêu rõ thiết bị, cách lượng tử hóa và ứng dụng, kể cả việc con số 20,51 tok/s có đứng vững dưới đồng hồ bấm giây của người khác hay không.
Kết luận: đừng chọn một, hãy vạch ranh giới giữa điện thoại và cloud
Nếu phải rút gọn thành một lời khuyên, tôi sẽ nói: hãy thiết kế kiến trúc quanh ranh giới giữa những khung hình được phép rời thiết bị và những khung hình không được phép. MiniCPM-V 4.7 là lớp lọc trên điện thoại, Qwen3.8-Omni-Flash là lớp phân tích sâu trên cloud. Khi bạn chấp nhận điều này, câu hỏi không còn là "mô hình nào thắng" mà là "mô hình nào xử lý phần nào của dòng video". Dưới đây là cách tôi sẽ ra quyết định trong đời thực:
- Mua MiniCPM-V 4.7 (AI trên thiết bị) nếu bạn cần xử lý video điện thoại tại chỗ, nhiều lượt xem ngắn, quyền riêng tư cao, hoặc phải chạy offline; bỏ qua nếu khối lượng của bạn chủ yếu là phiên dài một giờ và bạn không có giới hạn dữ liệu rời thiết bị.
- Mua Qwen3.8-Omni-Flash (API cloud) nếu bạn thường xuyên phân tích cuộc họp, lớp học, livestream dài, đầu vào lẫn văn bản, slide, âm thanh, video trong một lần; bỏ qua nếu bạn không muốn phụ thuộc vào hạ tầng cloud hoặc không chấp nhận chi phí theo token.
- Dùng cả hai nếu bạn có một tầng điện thoại để lọc 90% trường hợp thường nhật và một tầng API để xử lý các ca dài tới một giờ; chấp nhận việc phải duy trì hai bộ prompt, hai chiến lược sampling và một ranh giới rõ ràng về khung hình nào được phép vượt qua.
Trong kỷ nguyên mô hình AI nhẹ và đa mô thức, chiến thắng không thuộc về mô hình nhanh nhất trên giấy, mà thuộc về đội ngũ biết đặt đúng mô hình vào đúng chỗ trong pipeline video của mình.