
Từ mô hình siêu lớn đến mô hình AI nhỏ gọn: cuộc đổi hướng tất yếu
Mô hình AI nhỏ gọn với trọng số mở là các hệ thống suy luận có số tham số vừa phải nhưng được thiết kế để chỉ kích hoạt một phần tham số khi xử lý, cho phép chạy trực tiếp trên thiết bị biên và di động, giảm chi phí tính toán, đồng thời cho phép nhà phát triển tải về, tinh chỉnh và triển khai linh hoạt mà không phụ thuộc hoàn toàn vào hạ tầng đám mây. Sự xuất hiện của Beam với 501 tỉ tham số cho thấy đỉnh cao của cuộc đua mô hình siêu lớn, nhưng cũng phơi bày mặt trái: cần tới 6.144 GPU cho tiền huấn luyện và 10.500 GPU cho học tăng cường, một quy mô mà phần lớn doanh nghiệp không thể chạm tới. Trong khi đó, LFM2.5-24B-A2B chỉ có 24B tham số, kích hoạt khoảng 2B, nhưng được tối ưu cho tác tử AI chạy trên thiết bị biên. Cuộc đối đầu này không còn là ai lớn hơn, mà là ai hiệu quả hơn. Nếu Beam chứng minh rằng mô hình khổng lồ có thể suy luận mạnh, thì LFM2.5-24B lại đặt câu hỏi: liệu chúng ta có thực sự cần 500B tham số cho đa số tác vụ hàng ngày?
LFM2.5-24B-A2B: mô hình trọng số mở được thiết kế cho tác tử AI trên thiết bị
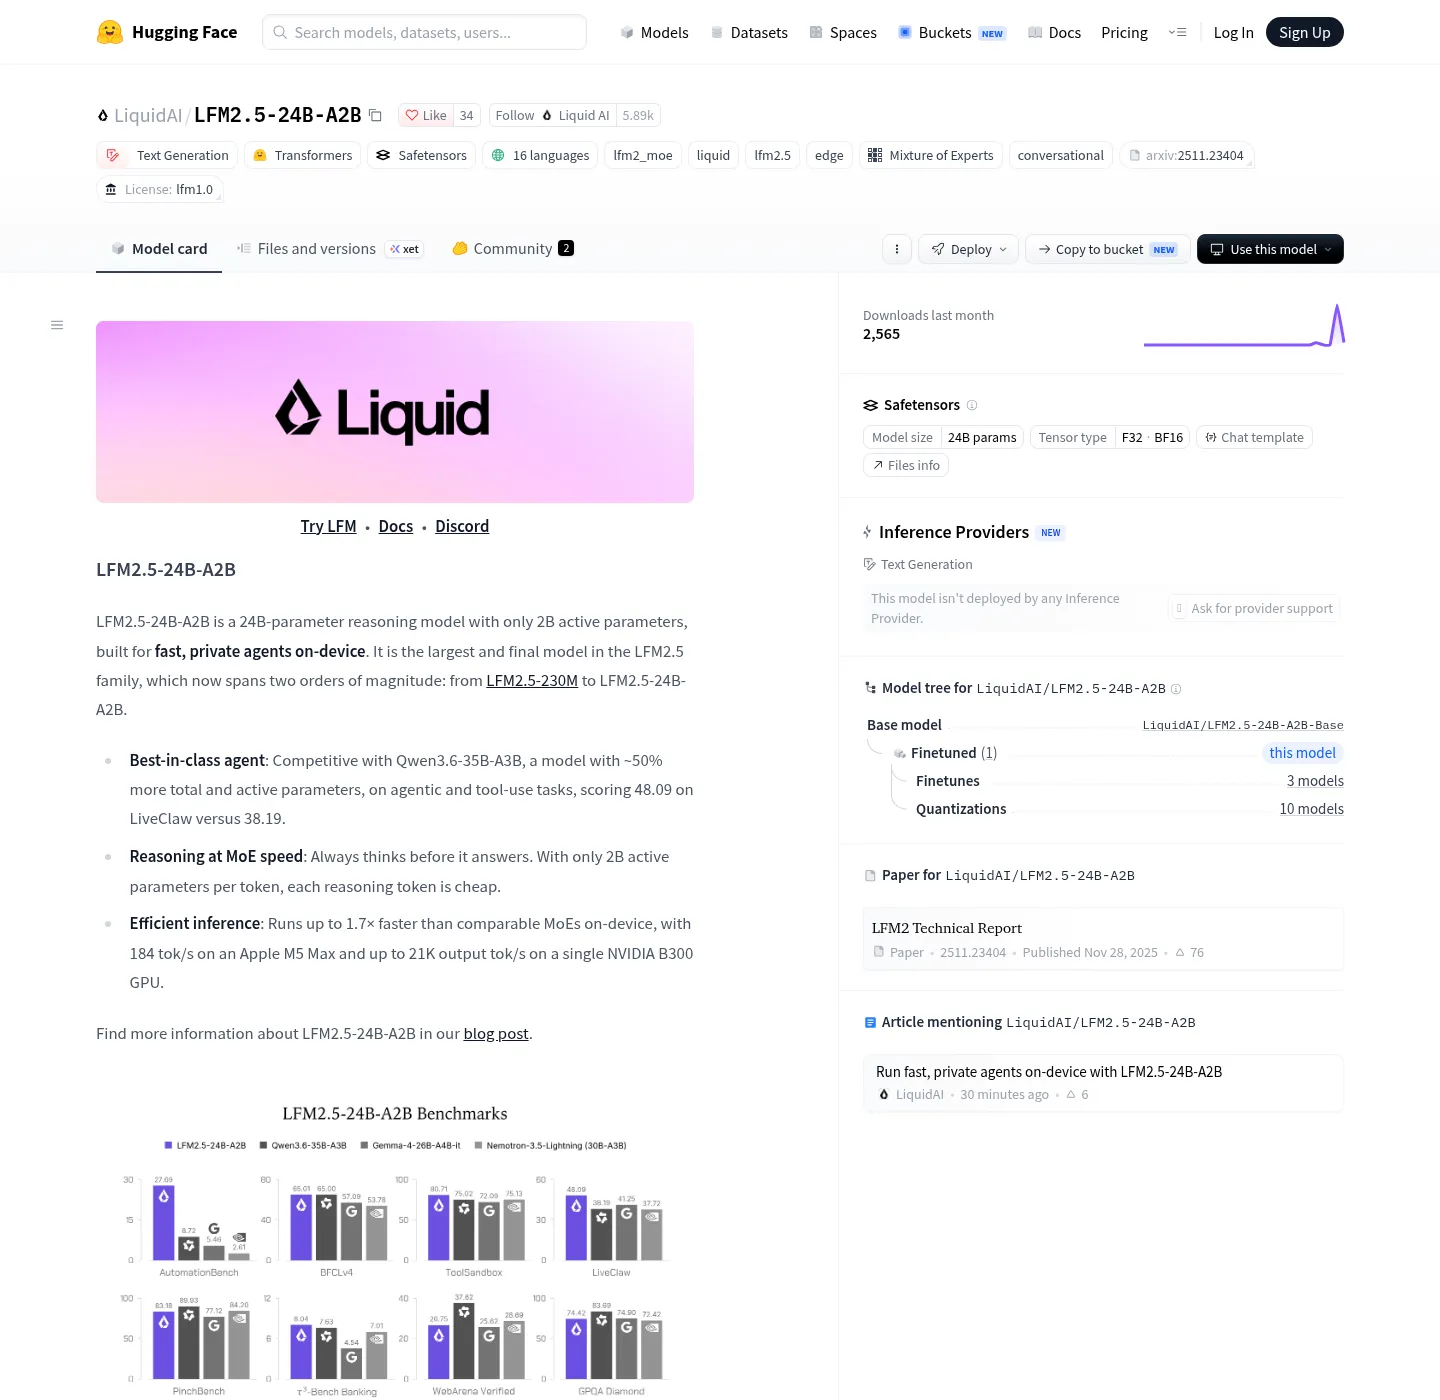
Ngày 13 tháng 10 năm 2026, Liquid AI phát hành LFM2.5-24B-A2B, một mô hình suy luận có trọng số mở với 24B tham số, trong đó 2B tham số được kích hoạt, được xây dựng cho các tác tử chạy trên thiết bị. Đây là mẫu lớn nhất và cuối cùng trong dòng LFM2.5, trải dài từ 230M đến 24B tham số, cho thấy chiến lược rõ ràng: thay vì phình to vô hạn, họ chốt ở một kích thước "đủ dùng" cho thiết bị biên. Kiến trúc của LFM2.5-24B-A2B giữ nguyên 40 lớp, gồm 30 khối tích chập ngắn có cổng kép và 10 khối chú ý truy vấn nhóm, cùng 64 chuyên gia cho mỗi khối hỗn hợp chuyên gia với cơ chế định tuyến top-4. Mô hình có 24.0B tham số, 2.45B tham số được kích hoạt, ngân sách huấn luyện 36 nghìn tỷ token, từ vựng 128.000 token và cửa sổ ngữ cảnh 131.072 token. Việc công khai trọng số biến LFM2.5-24B thành một nền tảng mở: nhà phát triển có thể tải về, tinh chỉnh cho miền dữ liệu riêng, tích hợp vào các bộ khung tác tử như Hermes Agent, OpenClaw, Pi hay OpenCode mà không bị khóa trong hệ sinh thái của một nhà cung cấp duy nhất.
Hiệu quả tính toán: vì sao 24B tham số đang thắng thế trước 500B+
Beam với 501 tỉ tham số là ví dụ điển hình cho mô hình siêu lớn: dùng kiến trúc Mixture-of-Experts để chỉ kích hoạt khoảng 23 tỉ tham số mỗi lần suy luận, giảm lượng tính toán so với việc huy động toàn bộ 501 tỉ tham số. Tuy vậy, việc phải huy động hàng nghìn GPU cho tiền huấn luyện và học tăng cường cho thấy chi phí tính toán vẫn ở mức khổng lồ, phù hợp với vài công ty hạ tầng hơn là số đông nhà phát triển. Ngược lại, LFM2.5-24B-A2B chọn điểm cân bằng: 24B tham số, 2.45B tham số kích hoạt, nhưng được tối ưu để chạy nhanh trên thiết bị biên. Theo công bố, mô hình đạt tốc độ giải mã 184 token/giây trên Apple M5 Max và 114 token/giây trên AMD Ryzen AI Max+ 395, nhanh hơn tới 1,7 lần so với mô hình hỗn hợp chuyên gia tốt nhất tiếp theo, đồng thời chỉ dùng 15 GB bộ nhớ trên M5 Max. Đây là câu trả lời rõ ràng cho câu hỏi hiệu quả: thay vì đổ tài nguyên vào một mô hình 500B tham số, các đội sản phẩm có thể chọn một mô hình AI nhỏ gọn như LFM2.5-24B, vừa đủ mạnh để suy luận, vừa đủ nhẹ để chạy cục bộ.
| Thông số | Beam (MoE siêu lớn) | LFM2.5-24B-A2B (nhỏ gọn) |
|---|---|---|
| Tổng tham số | 501B | 24B |
| Tham số kích hoạt mỗi lần | ≈23B | 2.45B |
| Định hướng triển khai | Cụm GPU quy mô lớn | Thiết bị biên, di động |
Thiết bị biên và tác tử AI: nơi mô hình nhỏ gọn phát huy sức mạnh
Điểm đáng chú ý nhất của LFM2.5-24B-A2B không phải là kích thước, mà là mục tiêu: "được xây dựng cho các tác tử chạy trên thiết bị". Trong bối cảnh người dùng muốn trợ lý cá nhân, công cụ lập trình, hệ thống tự động hóa chạy ngay trên laptop, điện thoại hay thiết bị IoT, mô hình AI nhỏ gọn với trọng số mở là mảnh ghép còn thiếu. Nó cho phép tạo ra các tác tử AI có thể lên kế hoạch, gọi công cụ, tương tác nhiều bước mà không cần kết nối đám mây liên tục. LFM2.5-24B-A2B được huấn luyện hậu kỳ qua năm giai đoạn, bao gồm tinh chỉnh có giám sát, chuyên biệt hóa giáo viên, chưng cất theo chính sách hiện hành trên nhiều miền cho cả tác vụ có và không dùng tác tử, cùng học tăng cường cho tác tử chạy bên trong các bộ khung như OpenClaw, Hermes Agent, Pi và OpenCode. Theo công bố, mô hình dẫn đầu hoặc ngang bằng ở nhiều bài kiểm tra về sử dụng công cụ và tác tử, đồng thời đứng đầu ở ba bài kiểm tra làm theo chỉ dẫn. Điều này cho thấy một thực tế: nếu bạn muốn xây dựng tác tử AI thực sự hữu ích trên thiết bị biên, mô hình nhỏ gọn nhưng được huấn luyện sâu về suy luận và gọi công cụ sẽ hiệu quả hơn một mô hình khổng lồ nhưng chỉ chạy được trên đám mây.
Trọng số mở AI: quyền tự chủ cho nhà phát triển và người dùng
Cả Beam và LFM2.5-24B-A2B đều là mô hình có trọng số mở, cho phép nhà phát triển tải về, triển khai hoặc tiếp tục tinh chỉnh theo nhu cầu. Nhưng chính mô hình AI nhỏ gọn mới làm cho khái niệm trọng số mở trở nên thực tế: khi mô hình có thể chạy trên thiết bị biên với 15 GB bộ nhớ và tốc độ giải mã cao, việc công khai trọng số không chỉ là cử chỉ "mở", mà là trao quyền tự chủ cho cộng đồng. LFM2.5-24B-A2B hỗ trợ llama.cpp, MLX, vLLM, SGLang và ONNX ngay từ ngày đầu, với điểm kiểm tra ở các định dạng native, FP8, GGUF, ONNX và MLX-4bit. Có thể triển khai mô hình cục bộ thông qua bất kỳ backend nào tương thích với OpenAI và kết nối với các bộ khung tác tử như Hermes Agent, OpenClaw và Pi. Liquid AI khuyến nghị kết hợp mô hình với công cụ truy xuất thông tin hoặc tìm kiếm web cho các tác vụ đòi hỏi nhiều kiến thức, tận dụng thế mạnh gọi công cụ của mô hình. Hướng đi này rất rõ: thay vì xây một "siêu trí tuệ" đóng, họ xây một nền tảng mở để cộng đồng ghép thêm công cụ, dữ liệu, khung tác tử và tạo ra hệ sinh thái tác tử AI phong phú trên thiết bị biên.