
DeepSeek-V4.1-Flash: Định nghĩa mới về mô hình ngôn ngữ hiệu quả
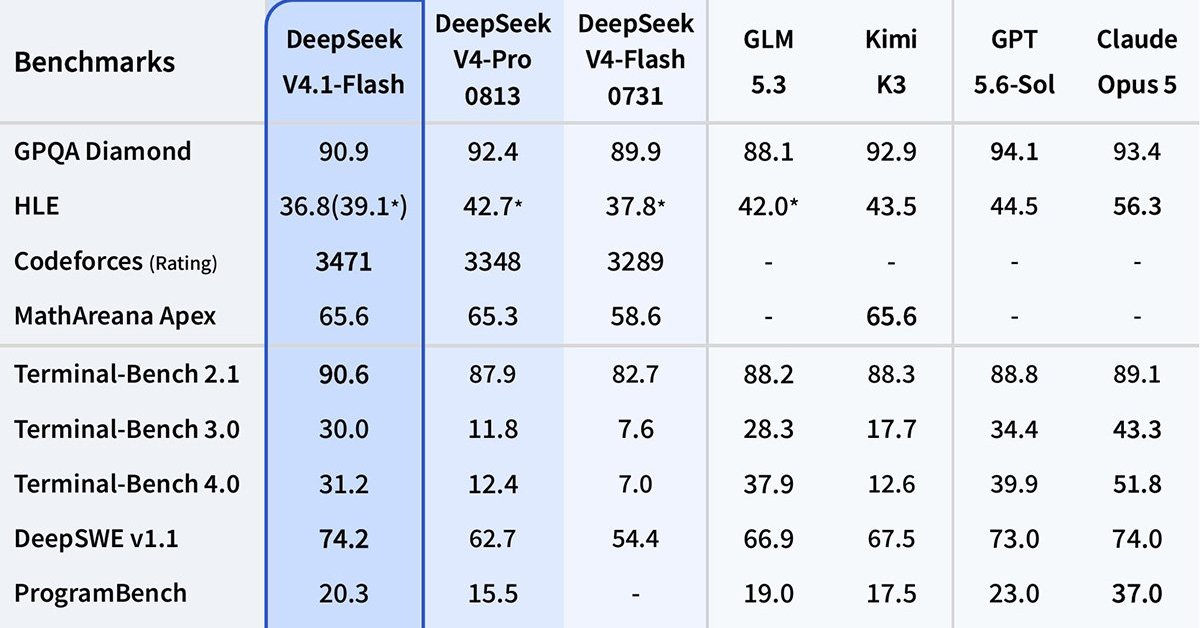
DeepSeek-V4.1-Flash là một mô hình ngôn ngữ hiệu quả thuộc thế hệ LLM tối ưu, sử dụng kiến trúc Mixture of Experts cùng các cải tiến về bộ nhớ và huấn luyện để cung cấp chất lượng tương đương hoặc vượt nhiều mô hình hàng đầu hiện nay mà không cần tăng tài nguyên GPU theo tỷ lệ, hướng tới AI tiêu thụ ít tài nguyên nhưng vẫn xử lý được ngữ cảnh rất dài và nhiều người dùng đồng thời. Điểm đáng nói không phải là DeepSeek tung ra thêm một mô hình “to hơn”, mà là họ đang thách thức trực tiếp tư duy càng nhiều GPU càng tốt. Ngày 10/9, công ty công bố DeepSeek-V4.1-Flash như một bản cập nhật của dòng Flash tối ưu chi phí và độ trễ, nhưng thực tế đây là một bước nhảy kiến trúc lớn hơn hẳn một bản nâng nhỏ. Họ tuyên bố mô hình mới thông minh hơn, nhanh hơn và hiệu quả hơn, đạt hoặc vượt hiệu năng của DeepSeek-V4-Pro, GPT-5.6 Sol và Claude Opus 5 trong nhiều bài đo. Nếu điều này đúng về lâu dài, cuộc đua LLM sẽ buộc phải tính lại bài toán hiệu quả thay vì khoe kích thước tham số.
Kiến trúc LLM tối ưu: MoE, KV cache và n-gram chơi cùng một đội
Thay vì đẩy hết tham số vào một mạng thần kinh khổng lồ rồi bắt GPU gồng lên, DeepSeek-V4.1-Flash chọn con đường kiến trúc LLM tối ưu. Mô hình dùng Mixture of Experts (MoE), nghĩa là bên trong có nhiều “chuyên gia” xử lý khác nhau, mỗi lượt suy luận chỉ kích hoạt một phần nhỏ, giúp tăng hiệu suất mà không tăng chi phí tính toán tuyến tính theo tổng tham số. Theo một nguồn tin, đây là mô hình MoE với hàng trăm tỷ tham số, nhưng lại được thiết kế để không bắt buộc phải nhân đôi, nhân ba số GPU khi triển khai. Trọng tâm của mô hình là cách xử lý bộ nhớ trạng thái – KV cache. DeepSeek đã chỉnh lại cơ chế attention và đưa vào một bộ mã hóa–giải mã nhân quả (causal encoder-decoder, CED), giúp tăng tốc xử lý prompt đồng thời cắt lượng KV cache xuống chỉ còn khoảng 13–25% so với phiên bản V4 Flash trước đó. Một câu nói đáng trích là: “Bản V4.1 có thể phục vụ nhiều hơn từ bốn đến tám lần người dùng trong cùng một dung lượng KV cache.” Đây là cú đấm thẳng vào luận điểm lớn hơn là tốt hơn nếu tổng chi phí triển khai không còn tăng theo.

N-gram như bộ nhớ điều kiện: tách trí nhớ khỏi tính toán để AI tiêu thụ ít tài nguyên
Điểm sáng táo bạo nhất của DeepSeek-V4.1-Flash là cách họ coi bộ nhớ của mô hình như một kho tra cứu, thay vì phần tham số phải “quét” hết trong mỗi bước suy luận. Trong tổng số hàng trăm tỷ tham số, một phần lớn là tham số n-gram – những nhóm token được lưu như một module “bộ nhớ có điều kiện”. Ý tưởng là tách phần nhớ ra khỏi phần tính: mô hình vẫn dùng khoảng vài tỷ tham số “hoạt động” để suy luận, còn bộ nhớ n-gram thì giống như một bách khoa toàn thư cực kỳ cụ thể, được tra cứu qua bảng tra cứu rẻ tiền theo dạng lookup. Vì các trọng số n-gram là bảng tra cứu, chúng không cần được đọc toàn bộ từ GPU trong mỗi bước sinh token, chỉ cần vài chục thao tác lookup. Kết quả: mô hình tăng lượng thông tin có thể dùng mà không tăng tương ứng áp lực băng thông bộ nhớ. Quan trọng hơn, phần n-gram này có thể để ở RAM hệ thống hoặc thậm chí là ổ lưu trữ nhanh, không nhất thiết nằm trong bộ nhớ GPU đắt đỏ. Một phân tích cho thấy nhờ offload n-gram, dung lượng GPU tối thiểu cho mô hình ở định dạng thấp có thể giảm hàng trăm GB so với việc giữ toàn bộ tham số trên GPU. Đây chính là cốt lõi của xu hướng AI tiêu thụ ít tài nguyên: trí nhớ ngày càng lớn nhưng không ép hạ tầng phải phình theo cùng tốc độ.
Tác động thực tế: giá API, khả năng mở rộng và người dùng phổ thông được lợi
Câu hỏi quan trọng luôn là: người dùng được gì ngoài vài slide kiến trúc ấn tượng. DeepSeek đã đưa ra một tín hiệu rõ ràng khi đảo ngược quyết định tăng giá API trước đó. Sau lần tăng giá vào ngày 13/8, công ty công bố áp dụng mức giá thấp hơn ngay khi ra mắt DeepSeek-V4.1-Flash, nhờ chi phí nhập dữ liệu tốt hơn và giảm KV cache. Dù các nguồn không ghi theo đơn vị tiền tệ nội địa, điểm mấu chốt là bản mô hình này khiến họ đủ tự tin để nói về “chi phí thấp hơn mà vẫn vượt mô hình flagship”. Bên cạnh chi phí, khả năng phục vụ nhiều người dùng hơn trên cùng hạ tầng là lợi ích trực tiếp. Do KV cache của V4.1 chỉ bằng 13–25% so với thế hệ Flash trước, mô hình có thể xử lý đồng thời từ gấp bốn đến gấp tám số phiên người dùng trong cùng dung lượng bộ nhớ dành cho KV. Điều này không chỉ giúp nhà phát triển giảm áp lực mở rộng cụm GPU, mà còn mở ra khả năng cung cấp phiên bản mạnh cho khách hàng nhỏ lẻ, startup và nhà nghiên cứu vốn không có ngân sách hạ tầng khổng lồ.
Vượt khỏi trung tâm dữ liệu: hướng tới thiết bị biên và ứng dụng di động
Tư duy tách bộ nhớ khỏi tính toán của DeepSeek-V4.1-Flash ăn khớp với xu hướng đưa LLM xuống thiết bị biên. Cách họ dùng tham số n-gram có nhiều điểm giống công nghệ Per-Layer Embedding (PLE) do một nhóm khác phát triển nhằm giúp mô hình đủ thông minh để chạy hữu ích trên thiết bị có băng thông, bộ nhớ và sức mạnh tính toán hạn chế như điện thoại thông minh. Khi các trọng số ít nhạy với băng thông được offload ra bộ nhớ chậm hơn mà vẫn giữ chất lượng, việc mang một phần năng lực LLM xuống mobile trở nên thực tế hơn nhiều. Thông điệp ngầm ở đây rất rõ: tương lai của AI không thể chỉ là các cụm GPU khổng lồ trong trung tâm dữ liệu. Nếu kiến trúc LLM tối ưu kiểu DeepSeek-V4.1-Flash trở thành chuẩn mực, chúng ta sẽ thấy các mô hình hàng trăm tỷ tham số được “bẻ nhỏ” thông minh, đưa lên smartphone, thiết bị IoT, thậm chí các hệ thống chạy gần người dùng ở biên mạng. Khi đó, “mô hình ngôn ngữ hiệu quả” không còn là khẩu hiệu marketing, mà là nền tảng bắt buộc để AI đi vào đời sống hàng ngày.