
DeepSeek V4.1 Flash: định nghĩa lại thế nào là mô hình ngôn ngữ hiệu quả
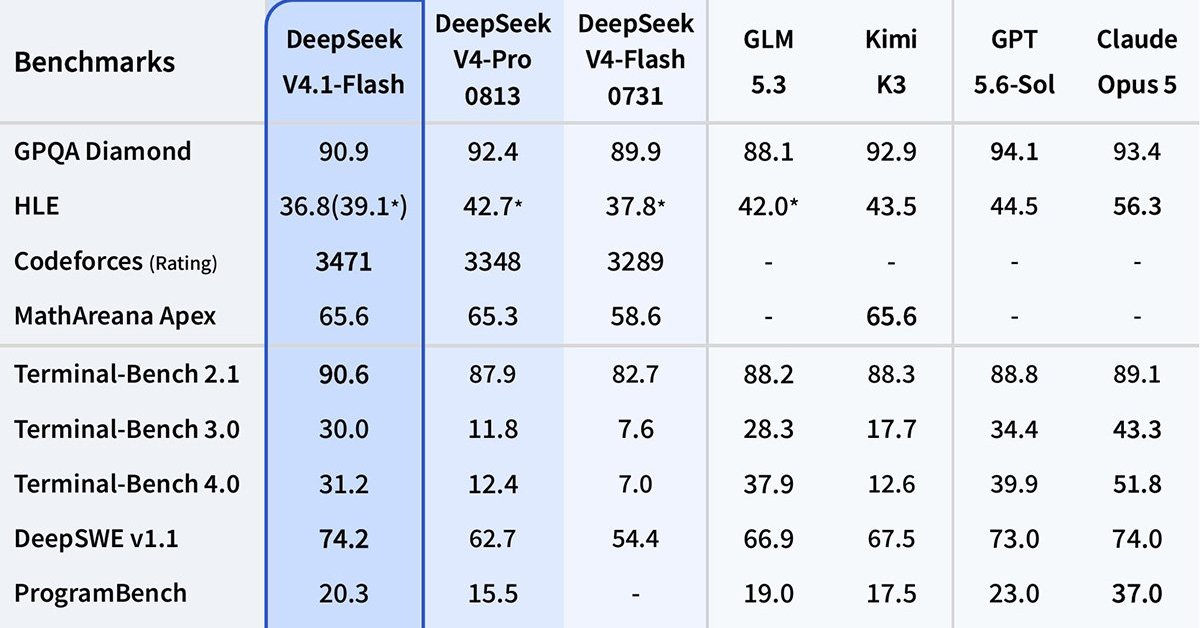
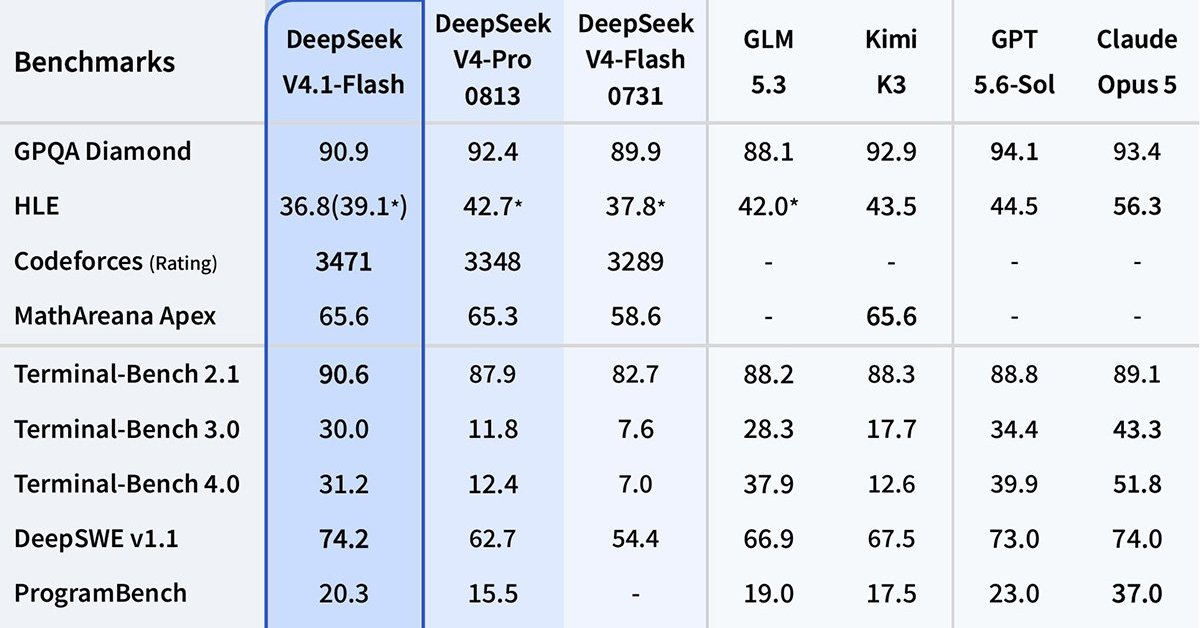
DeepSeek V4.1 Flash là một mô hình ngôn ngữ hiệu quả được thiết kế để đạt chất lượng ngang tầm các flagship như GPT-5.6 Sol và Claude Opus 5 nhưng đòi hỏi ít tài nguyên tính toán hơn, nhờ kiến trúc LLM tối ưu kết hợp Mixture of Experts và cơ chế bộ nhớ điều kiện, giúp doanh nghiệp triển khai mô hình AI với chi phí thấp hơn mà vẫn giữ được khả năng xử lý khối lượng người dùng lớn và ngữ cảnh dài. Điểm cốt lõi ở đây không phải là “một mô hình nữa” trong cuộc đua LLM, mà là một triết lý triển khai mới: thông minh hơn bằng cách tiêu thụ ít tài nguyên hơn. Ngày 10/9, DeepSeek – công ty AI đến từ Trung Quốc – công bố DeepSeek-V4.1-Flash như bản cập nhật kiến trúc cho dòng Flash, đồng thời tuyên bố nó vượt một phần hiệu năng của DeepSeek-V4-Pro, GPT-5.6 Sol và Claude Opus 5 nhờ kiến trúc mới và phương pháp huấn luyện tối ưu. Bản cập nhật này không chỉ gia tăng số tham số, mà còn đặt ra câu hỏi khó cho toàn bộ ngành: liệu chúng ta có cần thêm GPU để có thêm trí tuệ máy?
Kiến trúc LLM tối ưu: MoE khổng lồ nhưng vẫn “nhẹ” bộ nhớ
DeepSeek V4.1 Flash đi ngược lại trực giác quen thuộc: mô hình càng lớn thì càng nặng nề khi triển khai. Với 552 tỷ tham số trong kiến trúc Mixture of Experts (MoE), mỗi “chuyên gia” chỉ được kích hoạt tùy theo nội dung đầu vào, giảm đáng kể khối lượng tính toán phải thực hiện trên mỗi lượt suy luận. Theo báo cáo kỹ thuật, số tham số tổng thể của bản phát hành mới thậm chí lên tới khoảng 763 tỷ, hơn 2,5 lần so với bản V4 Flash tiền nhiệm, nhưng nhu cầu bộ nhớ lại không phình to theo tỉ lệ đó. "Despite its ginormous parameter count, DeepSeek V4.1 Flash’s memory requirements aren’t nearly as high as you’d expect for a model of its size." Lý do nằm ở việc tối ưu cơ chế attention, giới thiệu encoder-decoder nhân quả (CED) và tái thiết kế cách mô hình xử lý KV cache – phần bộ nhớ dùng để lưu trạng thái qua nhiều bước suy luận. KV cache mới chỉ cần khoảng 13–25% dung lượng so với V4 Flash, cho phép hỗ trợ nhiều người dùng hơn trên cùng hạ tầng.
N-gram như bộ nhớ điều kiện: thêm trí tuệ mà không cần thêm GPU
Khối đổi mới táo bạo nhất của DeepSeek V4.1 Flash nằm ở cách mô hình tách rời bộ nhớ khỏi tính toán bằng hàng trăm tỷ tham số N-gram. Trong tổng số tham số, có khoảng 196 tỷ tham số N-gram hoạt động như một “conditional memory module”, cho phép mô hình tra cứu nhanh những mẩu kiến thức ẩn khi xử lý câu hỏi thay vì phải tính toán lại toàn bộ mỗi lần. Khác với tham số đang hoạt động của mô hình tự hồi quy, các trọng số N-gram được tổ chức như những bảng tra cứu khổng lồ. Chúng không cần được đọc toàn bộ từ bộ nhớ GPU cho mỗi token sinh ra, mà chỉ cần vài chục phép tra cứu bảng trên mỗi token. Hệ quả là phần tham số này có thể đặt ở RAM hệ thống hoặc thậm chí là mảng lưu trữ tốc độ cao, giảm áp lực lên GPU. Trong thực tế, nếu tất cả trọng số ở độ chính xác FP8 phải nằm trên GPU thì mô hình sẽ cần khoảng 763 GB bộ nhớ; nhờ offload N-gram sang bộ nhớ rẻ hơn, nhu cầu GPU tối thiểu giảm xuống khoảng 567 GB. Đây chính là điểm cho thấy mô hình có thể chạy hiệu quả hơn mà không cần bổ sung thêm GPU đắt đỏ, mở đường cho AI chi phí thấp ở quy mô lớn.
Hiệu quả triển khai mô hình AI: từ KV cache đến chiến lược giá
Nếu nhìn từ góc độ doanh nghiệp, đột phá quan trọng nhất của DeepSeek V4.1 Flash là cách nó thay đổi bài toán triển khai mô hình AI trong môi trường tải cao. KV cache – vốn rất phàm ăn bộ nhớ khi có nhiều phiên chat song song – nay được tối ưu để giảm xuống chỉ còn 13–25% so với yêu cầu của V4 Flash, nghĩa là cùng một dung lượng KV cache có thể phục vụ gấp 4 đến 8 lần số người dùng. Khi số phiên tăng mà không phải thêm GPU, tổng chi phí hạ tầng giảm mạnh dù mô hình ngày càng thông minh. Thú vị ở chỗ, DeepSeek từng tăng giá API vào ngày 13/8, nhưng khi V4.1 Flash xuất hiện, họ đảo chiều và thông báo giảm phí từ chính ngày ra mắt mô hình. Thay vì đánh vào khách hàng bằng giá cao, họ tận dụng kiến trúc LLM tối ưu để biến hiệu quả tính toán thành lợi thế thương mại: AI chi phí thấp nhưng vẫn có chất lượng cạnh tranh với GPT-5.6 Sol và Claude Opus 5. Đây là một thông điệp mạnh: doanh nghiệp không nhất thiết phải trả mức flagship để nhận chất lượng flagship.
Ý nghĩa chiến lược: DeepSeek buộc cả thị trường phải tính lại
Với DeepSeek V4.1 Flash, câu chuyện không dừng ở benchmark hay giá API, mà là sự dịch chuyển tư duy trong cả ngành. Khi một mô hình có thể mở rộng tới hàng trăm tỷ tham số, hỗ trợ nhiều người dùng hơn nhờ KV cache tối ưu, đồng thời offload phần lớn trọng số ít nhạy cảm về băng thông ra khỏi GPU, thì chiến lược xây LLM “càng to càng tốt” trên cụm GPU khổng lồ bắt đầu lộ rõ hạn chế. DeepSeek chứng minh một hướng đi khác: dùng kiến trúc MoE, bộ nhớ điều kiện N-gram và thiết kế attention mới để tạo mô hình ngôn ngữ hiệu quả, thay vì chỉ đổ thêm phần cứng. Điều này đặt áp lực lên các nhà phát triển LLM khác, kể cả những tên tuổi đi đầu trong việc thí nghiệm các kỹ thuật tương tự như Per-Layer Embedding. Doanh nghiệp đang xây chiến lược AI sẽ phải tự hỏi: mình nên chạy theo những mô hình “to nhưng đắt” hay chọn những mô hình biết tiết kiệm tài nguyên, cho phép triển khai mô hình AI sâu rộng hơn trên hạ tầng hiện có? Câu trả lời ngày càng nghiêng về phía những kiến trúc LLM tối ưu kiểu DeepSeek V4.1 Flash.