
16B trên đúng một TV box, và con số 5,1 tok/s
Điều mình muốn làm rõ trước tiên: đây không phải lời khẳng định rằng model 16 tỷ tham số sẽ chạy được trên mọi TV box còn 1 GB RAM. README của smolmaxxing nêu một cấu hình cụ thể: Xiaomi TV Box S (3rd Gen), chip Amlogic S7D với 4 lõi Cortex-A55, RAM 1,9 GB nhưng khoảng 1 GB khả dụng, chạy Android 14 và không cần root.
Trên chiếc box đó, dự án báo Ling-mini-2.0 16B đạt 5,1 token/giây. Đây là số đo do dự án công bố, không phải benchmark độc lập; README không ghi đầy đủ thiết lập đo hay độ dài ngữ cảnh cho con số này. Dự án cũng nêu Qwen3.5-2B đạt 7,7 token/giây, nhưng thiếu điều kiện đo chi tiết nên mình không xem hai kết quả là phép so sánh ngang hàng.
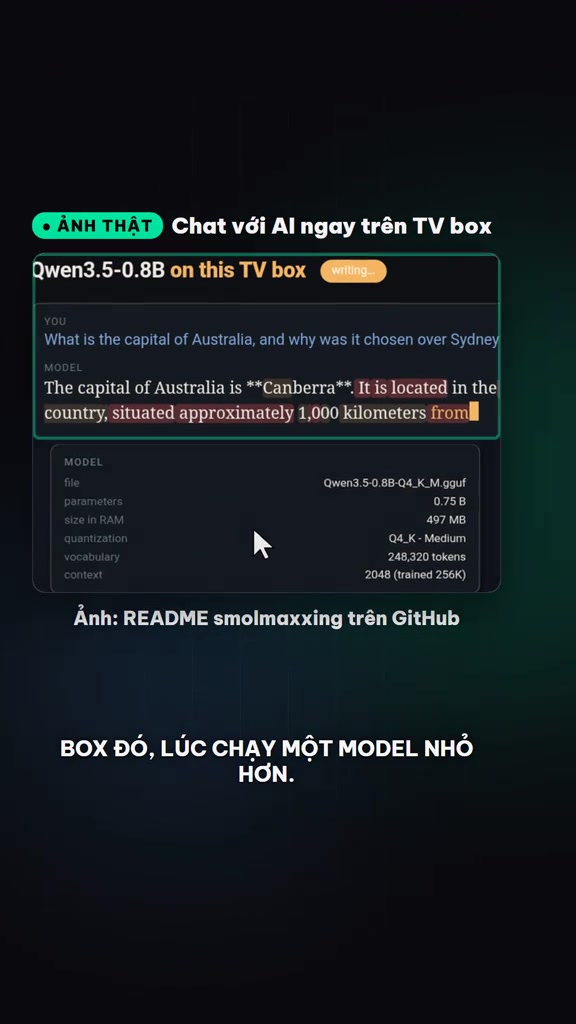
Lưu ý ảnh giao diện này hiển thị Qwen3.5-0.8B, không phải Ling-mini-2.0 16B. Còn 5,1 tok/s cũng không có nghĩa là AI gõ ra năm từ tiếng Việt mỗi giây: token không tương đương một-một với từ, và tốc độ đó chưa cho biết thời gian chờ câu trả lời đầu tiên hay trải nghiệm với ngữ cảnh dài.
RAM ít vẫn chạy được nhờ cách nạp model
Ling-mini-2.0 thuộc nhóm MoE: thay vì tính toán đồng thời toàn bộ các khối chuyên gia cho mỗi token, bộ định tuyến chọn một phần để xử lý. smolmaxxing dựa trên cơ chế này để giữ một phần trọng số trong RAM, còn các phần khác được đọc từ bộ nhớ lưu trữ khi cần; những chuyên gia được dùng thường xuyên có thể được giữ lại, và phần tiếp theo được nạp trước. Nói nôm na, RAM là bàn làm việc, còn bộ nhớ trong là kho hồ sơ—không cần bê cả kho lên bàn.
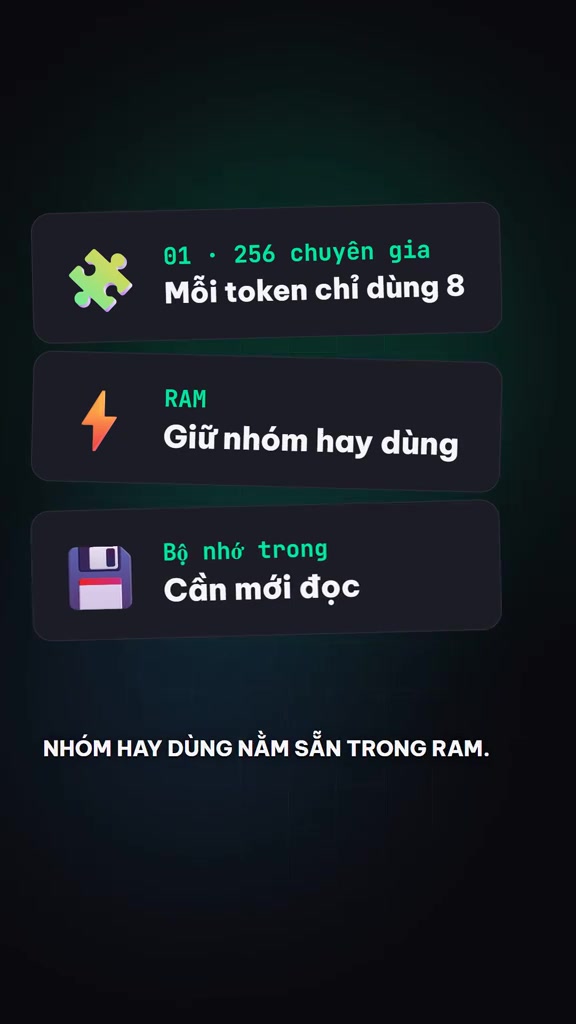
Đừng lấy các con số 256 và 8 trong sơ đồ làm cấu hình đã xác nhận của Ling-mini-2.0: README công bố model 16B nhưng không nêu tổng số chuyên gia, số chuyên gia hoạt động mỗi token, kích thước file hay dạng lượng tử hóa của model này. Vì vậy, “16B chạy với khoảng 1 GB RAM” không có nghĩa toàn bộ trọng số 16B được nạp vào RAM cùng lúc.
Tài liệu kỹ thuật của dự án mô tả thêm cách đọc chuyên gia từ flash, giữ cache và nạp trước. Cách làm này đổi một phần sự đơn giản lấy khả năng tận dụng phần cứng yếu: dung lượng lưu trữ, tốc độ đọc và tối ưu cho chip đều quan trọng, chứ không chỉ nhìn vào RAM.
Đổi lại, đây không phải ứng dụng cài là dùng
TV box cần bản llama.cpp đã được dự án vá; các model TV box có phần head bị cắt không chạy được bằng llama.cpp nguyên bản. Dự án còn có chế độ headless để dọn bộ nhớ: tài liệu ghi chế độ này dừng launcher và dịch vụ Google, đưa RAM trống từ khoảng 1.000 MB lên khoảng 1.300 MB. Với mình, đó là dấu hiệu đây vẫn là một thử nghiệm kỹ thuật, không phải trải nghiệm trợ lý AI tích hợp mượt vào giao diện TV thường ngày.
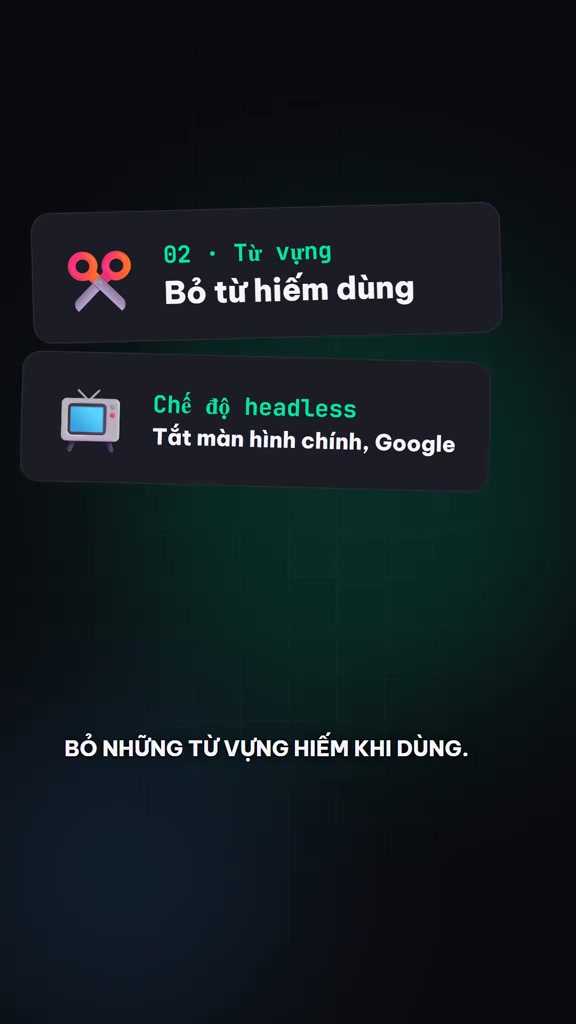
Một đánh đổi khác là rút gọn vocabulary của model. Tài liệu dự án nói cách cắt LM head này giữ token dựa trên tiếng Anh, mã nguồn và 7 ngôn ngữ khác, tiết kiệm khoảng 0,2–0,5 GB nhưng có thể bỏ sót khoảng 1% token tiếng Anh. Tài liệu mình kiểm tra không nêu tên 7 ngôn ngữ đó, nên mình sẽ không mặc định tiếng Việt được hỗ trợ đầy đủ; cần thử trực tiếp với câu hỏi, dấu và nội dung tiếng Việt trước khi dùng thật.
Kernel riêng cho phần cứng cũng là một phần của câu chuyện. Con số đẹp trên chiếc Xiaomi cụ thể không tự động áp dụng cho box Android khác, kể cả khi dung lượng RAM trông tương tự.
Nếu tự thử, mình sẽ bắt đầu nhỏ
Mình sẽ không mua thiết bị chỉ vì headline “16B, 1 GB RAM”. Nếu đã có đúng phần cứng hoặc thích mày mò, thứ tự hợp lý hơn là:
- Đọc hướng dẫn đúng model box và kiểm tra dung lượng lưu trữ, phiên bản hệ điều hành cùng cách khôi phục thiết bị trước khi thay phần mềm.
- Thử model nhỏ trước, rồi kiểm tra tác vụ tiếng Việt thực tế: hỏi đáp ngắn, yêu cầu có dấu, và một prompt dài hơn.
- Đo riêng thời gian chờ token đầu tiên và tốc độ sinh tiếp theo; đừng chỉ nhìn một con số tok/s.
- Kiểm tra phạm vi hoạt động của chế độ headless, giấy phép của model và cách thiết bị xử lý dữ liệu trước khi đưa thông tin nhạy cảm vào.
AI local trên TV box có một điểm đáng giá: suy luận tại chỗ có thể giảm việc phải gửi từng prompt lên dịch vụ đám mây. Nhưng chạy cục bộ không tự động bảo đảm mọi phần mềm nền đều riêng tư. Với mình, thành tựu ở đây không phải “TV box biến thành máy AI mạnh”, mà là một demo thú vị về việc dùng kiến trúc MoE, đọc dữ liệu theo nhu cầu và kernel tùy biến để vượt giới hạn RAM—đổi lại bằng tốc độ, độ tiện dụng và độ phủ ngôn ngữ cần kiểm tra kỹ.