
Raptor là gì và vì sao giới AI phải để mắt tới
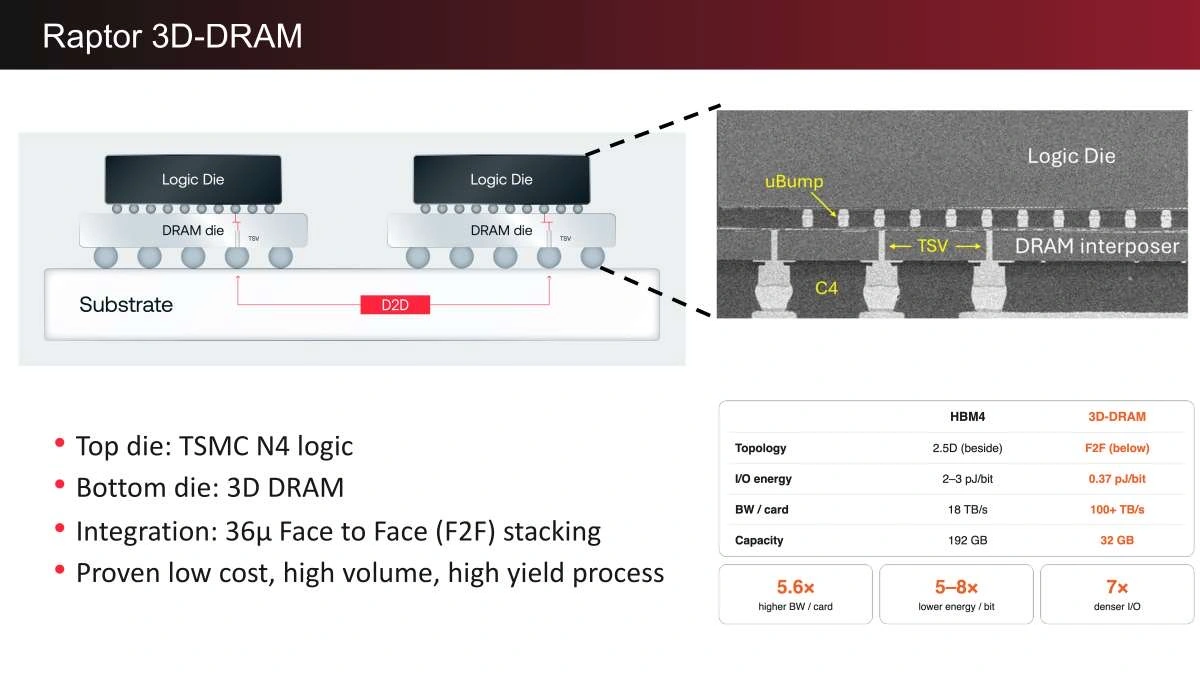
d-Matrix Raptor là một 3D DRAM accelerator mới dành cho generative inference AI, trong đó die tính toán TSMC 4nm được xếp chồng trực tiếp và kết nối face-to-face với die DRAM tùy biến bằng pitch 36 micron để tạo ra băng thông bộ nhớ 100 TB/s cho mỗi card, nhằm giải quyết đồng thời cả bài toán dung lượng và băng thông ở giai đoạn suy luận của các mô hình ngôn ngữ lớn. Raptor không chỉ là một con chip mới, mà là tuyên bố rằng thời kỳ xếp HBM cạnh GPU qua interposer đã chạm trần cho AI generative. d-Matrix trình bày Raptor tại hội nghị Hot Chips, và gọi đây là 3D DRAM accelerator đầu tiên cho generative inference. Điều đó cho thấy họ muốn chiếm vị trí tiên phong ở lớp hạ tầng suy luận, chứ không cạnh tranh trực diện trên đường đua huấn luyện GPU truyền thống.
Nỗi đau KV cache và vì sao HBM không còn đủ
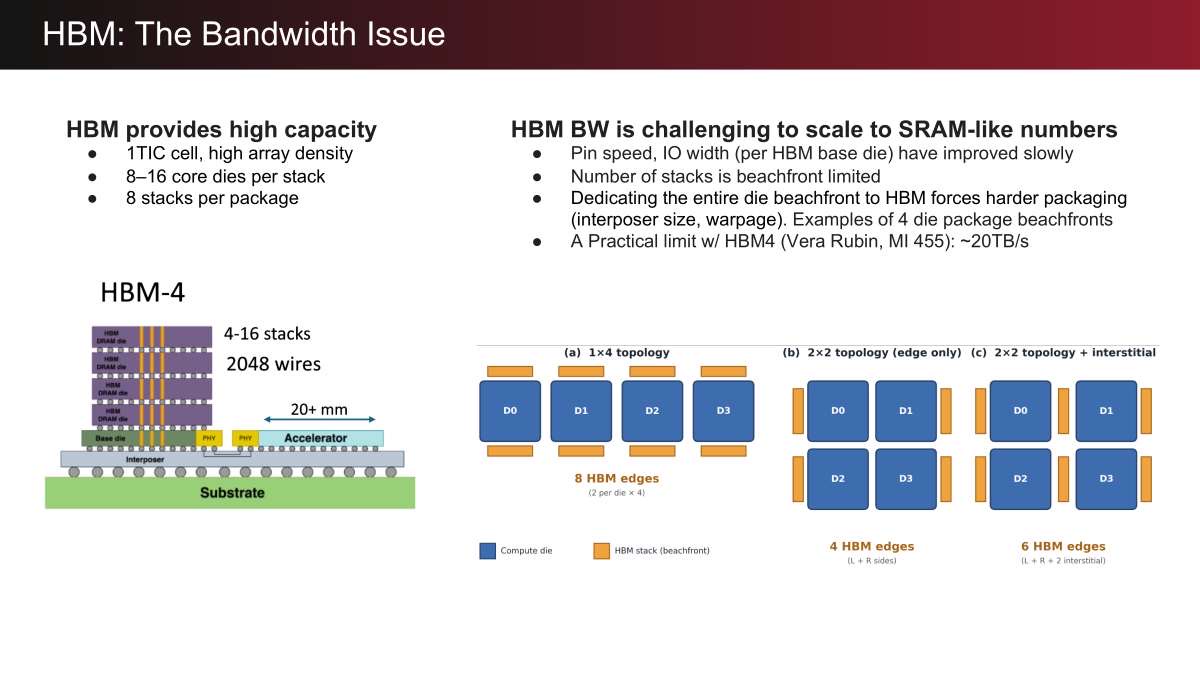
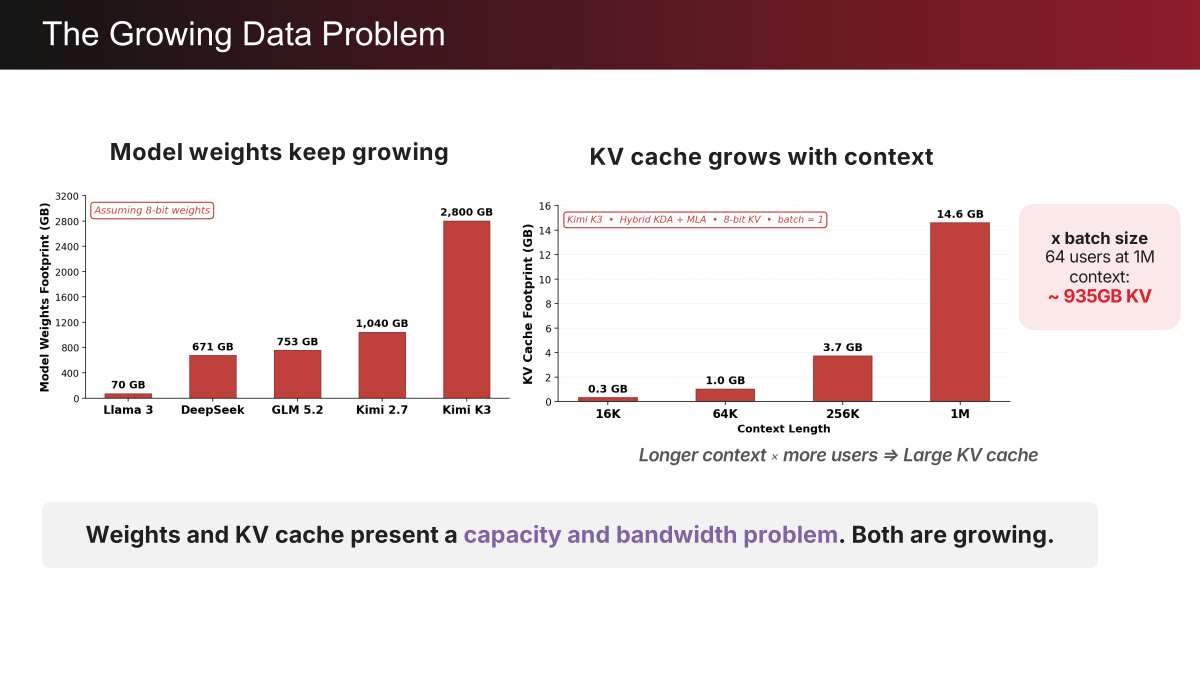
Điểm xuất phát của Raptor là một thực tế khó chịu: trọng số mô hình và KV cache đang phình to đến mức kiến trúc bộ nhớ hiện tại không theo kịp. Với 64 người dùng, mỗi người dùng ngữ cảnh 1 triệu token, KV cache có thể ngốn khoảng 935 GB – chưa kể bản thân trọng số mô hình. Bài toán này vừa là dung lượng, vừa là băng thông, và cả hai đều tăng cùng lúc. SRAM cho băng thông rất cao với độ trễ nanosecond, nhưng ở quy mô card Corsair, d-Matrix mới đạt khoảng 300 TB/s cho chỉ 4 GB bộ nhớ, lại tiêu tốn nhiều điện vì cell 6T lớn và rò rỉ. Ngược lại, HBM giải quyết tốt phần dung lượng nhưng bị giới hạn băng thông bởi số stack trên package và tốc độ I/O, với trần thực tế khoảng 20 TB/s cho hệ HBM4 đang được dùng trong các GPU cao cấp. Trong bối cảnh chỉ ba hãng sản xuất DRAM tiên tiến và dây chuyền HBM4 gần như kín chỗ đến hết 2026, tiếp tục ép HBM là hướng đi bế tắc.
Kiến trúc 3D DRAM: xếp chồng logic lên DRAM để giành lại băng thông
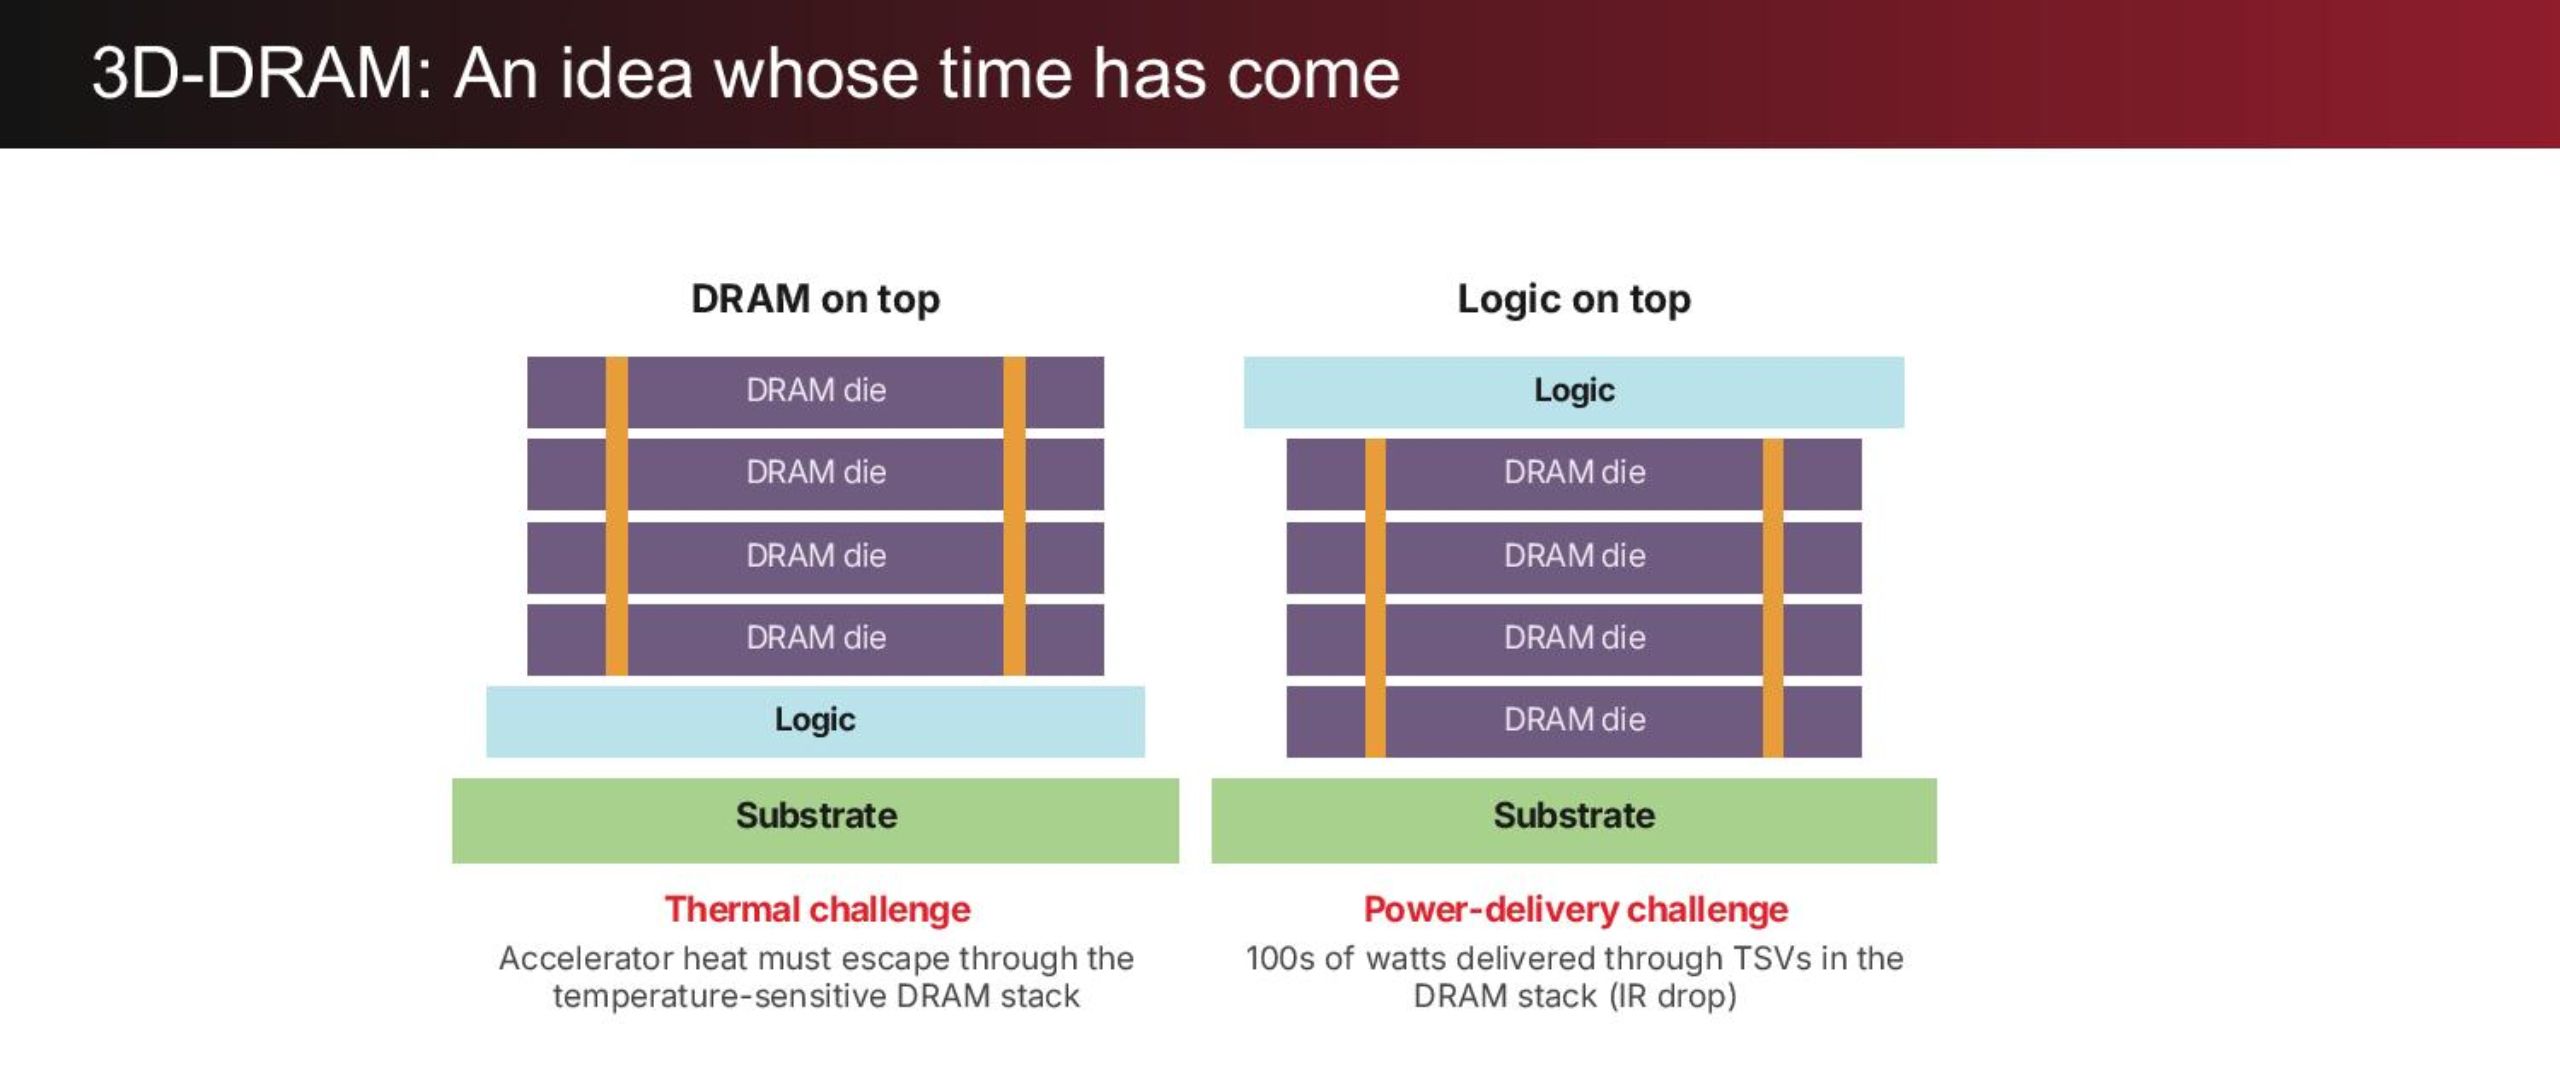
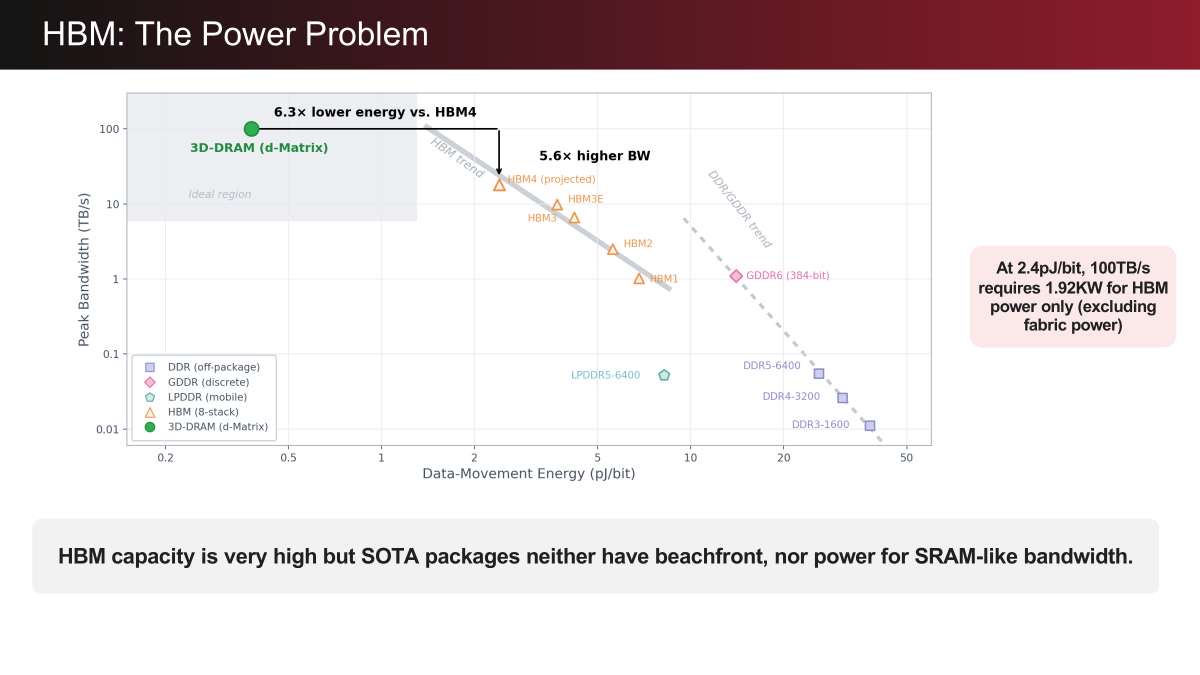
Động thái táo bạo của d-Matrix là xếp trực tiếp die tính toán lên trên die DRAM, biến chính DRAM thành interposer và rút ngắn đường đi dữ liệu xuống quy mô millimet. Kết nối vertical 3D IO này có chi phí năng lượng khoảng 0,3–0,4 pJ/bit, thấp hơn gần 10 lần so với HBM – nơi việc đưa dữ liệu vào base die HBM4 tiêu tốn khoảng 2,4 pJ/bit. Theo bài báo ISCA đi kèm, băng thông trên mỗi card của thiết kế này cao hơn khoảng 4,7 lần so với thiết kế dựa trên HBM. Một câu nói đáng trích là: "Đối với cùng một mức công suất, bạn có thể đẩy băng thông lên" – và Raptor đã đẩy lên tới 100 TB/s từ 32 GB DRAM trên mỗi card. Đây không chỉ là con số đẹp để trình chiếu; nó là bằng chứng rằng khi bỏ đi PHY phức tạp và đường interposer dài, ta có thể bước lên nấc thang năng lượng mới giữa SRAM trên-die và HBM 2,5D.
Generative inference: nơi băng thông thắng hiệu suất suy luận
Diễn giải của d-Matrix về bài toán LLM khá thuyết phục: giai đoạn prefill xử lý nhiều token song song nên bị giới hạn bởi năng lực tính toán, trong khi decode tạo ra từng token một và hầu như luôn bị giới hạn bởi băng thông bộ nhớ. Với attention có GQA cao hay speculative decoding, phần tính toán có thể trở thành nút cổ chai; còn với MoE, bộ nhớ vẫn chi phối dù batch không lớn. Thực tế, thời gian "treo" của người dùng chủ yếu nằm ở giai đoạn decode, nơi KV cache và trọng số được truy cập dày đặc. Vì thế, nếu Raptor tăng băng thông bộ nhớ ở decode, hiệu năng suy luận tổng thể của generative inference AI sẽ được cải thiện rõ rệt. ISCA ước tính Raptor đạt khoảng 4,7 lần throughput trên mỗi card so với thiết kế HBM, nghĩa là cùng một rack có thể phục vụ mô hình biên như Kimi K3 với ngữ cảnh 1 triệu token cho nhiều người dùng hơn, trễ thấp hơn, trong khi vẫn giữ dung lượng trong một rack Raptor 72 card.
Ý nghĩa lâu dài và lộ trình chưa hoàn chỉnh của Raptor
Điểm hấp dẫn nhất của Raptor không phải là con số 100 TB/s, mà là cách nó đặt lại câu hỏi: AI accelerator nên được thiết kế xoay quanh bộ nhớ, chứ không phải ghép thêm bộ nhớ vào một GPU có sẵn. Việc đồng thiết kế geometry bank DRAM, cơ chế refresh, cây mux bank dự phòng và cột ECC với die tính toán cho thấy một hướng đi memory-compute integration triệt để hơn bất kỳ HBM stack thương mại nào hiện nay. d-Matrix công khai rằng Raptor là 3D DRAM accelerator đầu tiên cho generative inference và dự kiến ra mắt vào năm 2027, dù chưa có ngày cụ thể hay thông tin về sản lượng và giá. Khi được hỏi về khả năng xếp chồng nhiều lớp logic, CTO Sudeep Bhoja thừa nhận lộ trình vẫn đang hoàn thiện và ngay cả stack 1-Hi hiện tại đã đủ khó về mặt nhiệt. Tuy vậy, nếu Raptor đạt được những gì silicon sớm và mô phỏng dự báo, thì cuộc chơi suy luận AI ở quy mô data center có thể rời trần HBM và bước sang kỷ nguyên accelerator xoay quanh 3D DRAM với băng thông dọc khổng lồ.