
MRAM kết nối CXL là gì và tại sao lại là bước ngoặt cho bộ nhớ AI lưu trữ?
MRAM kết nối CXL là sự kết hợp giữa bộ nhớ MRAM bền vững và giao thức liên kết bộ nhớ CXL, tạo thành một tầng bộ nhớ bền vững mới nằm giữa DRAM và NAND nhằm giảm mạnh độ trễ lưu trữ cho khối lượng công việc AI nhạy cảm. Đây không phải là một ổ SSD thu nhỏ, mà là một không gian bộ nhớ được CPU truy cập với ngữ nghĩa bộ nhớ, tương tự DRAM nhưng có khả năng lưu giữ dữ liệu không cần điện. Trong hệ thống AI, nơi GPU thường phải chờ I/O, một tầng bộ nhớ như vậy không còn là “tùy chọn thú vị” mà trở thành đòn bẩy bắt buộc nếu doanh nghiệp muốn tận dụng tối đa phần cứng đắt đỏ.
Về bản chất, MRAM (Magneto-Resistive RAM) là công nghệ bộ nhớ bán dẫn không mất dữ liệu, truy cập theo byte, sử dụng dòng điện phân cực spin để đổi hướng từ hóa của ô nhớ, từ đó đổi giá trị bit. MRAM lưu bit trong “magnetic tunnel junctions” thay vì mức điện tích, vừa mang tính bền vững như NAND, vừa đạt tốc độ truy cập tầm DRAM và độ bền ghi rất cao, điều mà NAND không có. Khi ghép MRAM với bộ điều khiển CXL, nhà sản xuất tạo ra một “pool” bộ nhớ bền vững truy cập qua CXL.mem, hành xử như bộ nhớ chứ không như thiết bị lưu trữ khối. Đây chính là sự khác biệt cốt lõi so với SSD NVMe: hệ điều hành và ứng dụng không phải “đi đường vòng” qua stack lưu trữ để đọc/ghi dữ liệu.
CXL-MRAM: Giảm độ trễ lưu trữ và giải tắc nghẽn cho GPU trong hệ thống AI
Điểm đáng nói nhất của MRAM kết nối CXL là khả năng tạo một tầng bộ nhớ bền vững giữa DRAM và NAND, từ đó giảm đáng kể độ trễ lưu trữ giảm cho hệ thống AI. Trong demo, Everspin dùng các mô-đun DDR4 MRAM kết hợp bộ điều khiển CXL để tạo một pool bộ nhớ bền vững, truy cập được với CXL.mem semantics, cho phép MRAM đóng vai trò tầng lưu trữ mới nằm giữa DRAM và flash. Steffen Hellmold nhấn mạnh rằng CXL-MRAM có thể cung cấp độ trễ thấp hơn hơn 100 lần so với SSD NVMe NAND, nghĩa là GPU không còn phải ngồi chờ hàng trăm micro giây cho mỗi lượt I/O.
Tắc nghẽn lưu trữ có thể kéo hiệu suất hệ thống xuống dưới 50%, khiến GPU đắt tiền bị bỏ không trong khi chờ thao tác I/O. Khi bộ nhớ bền vững được truy cập bằng ngữ nghĩa bộ nhớ thay vì giao thức lưu trữ, các tác vụ như checkpointing, key-value cache và scratchpad cho AI được tăng tốc đáng kể. Nói thực tế hơn: KV cache của mô hình ngôn ngữ lớn, nhật ký huấn luyện hay dữ liệu tạm của inferencing có thể đặt trên tầng MRAM kết nối CXL, cho tốc độ đọc cao hơn so với lưu trên SSD ngoài, kể cả khi SSD đó nối qua RDMA với phần mềm KV cache. Đặc biệt, dữ liệu vẫn tồn tại khi mất điện, không cần pin hay super-cap, giúp giản lược đáng kể độ phức tạp hệ thống.
Everspin mở rộng bộ nhớ máy chủ x86 qua CXL mà không “đập đi xây lại” kiến trúc
Everspin đã chứng minh rằng có thể mở rộng bộ nhớ máy chủ x86 bằng MRAM kết nối CXL mà không cần thay đổi kiến trúc hiện tại. Trong một hệ thống demo, họ dùng máy chủ Supermicro AS-1116CS-TN với CPU AMD EPYC 9355 kết hợp card FPGA AMD Alveo U250 chứa bộ điều khiển CXL 3.2 của Wolley, gắn với bốn mô-đun DDR4 MRAM 1 GB để tạo vùng nhớ bền vững 4 GB liên tục. Hệ thống này vượt qua các bài test MemTester và Google Stress App, cho thấy đã sẵn sàng để khách hàng chạy khối lượng công việc thực tế.
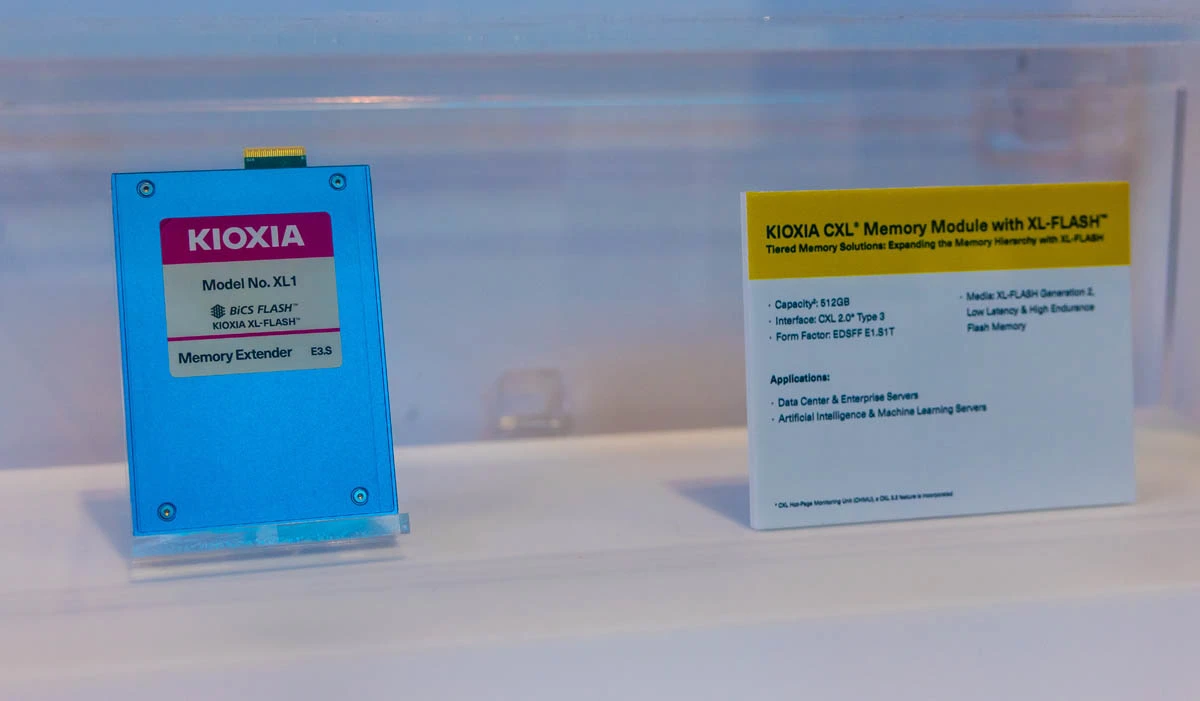
CXL (Computer eXpress Link) vốn là công nghệ mở rộng DRAM bằng cách liên kết bộ nhớ ngoài qua bus PCIe, cho phép CPU truy cập bộ nhớ chung trên các thiết bị accelerator với giao thức đồng bộ cache. Thay vì xem MRAM như “ổ SSD đặc biệt”, Everspin và Wolley chứng minh nó có thể được đưa vào môi trường này với ngữ nghĩa bộ nhớ. Theo một nhà phân tích tại Objective Analysis, demo CXL của Everspin là minh chứng cho ý tưởng lâu nay về việc dùng CXL làm chuẩn kết nối bộ nhớ mới. Điều quan trọng cho doanh nghiệp là họ có thể thêm tầng bộ nhớ bền vững vào máy chủ x86 hiện có qua slot PCIe mà không phải thay bo mạch chủ, không cần DRAM đặc thù hay kiến trúc mới.
IBM FlashCore Modules: Bằng chứng thực tế cho lợi ích bộ nhớ bền vững MRAM
Nếu MRAM kết nối CXL là tầm nhìn cho tương lai gần của bộ nhớ AI lưu trữ, thì FlashCore Modules IBM thế hệ 5 là minh chứng thực tế rằng MRAM đã sẵn sàng chạy trong trung tâm dữ liệu. FlashCore Modules là các SSD độc quyền của IBM; thế hệ thứ 5 là SSD tính toán với phần cứng nén, khử trùng lặp, die striping và phát hiện tấn công mạng tích hợp. Dòng FCM5 dùng NAND QLC với vùng ghi vào dạng SLC, cung cấp nhiều mức dung lượng thô khác nhau, từ 6,6 TB đến 105,6 TB, và dung lượng hiệu dụng nén tối đa tới 316,8 TB. Trong kiến trúc này, IBM đã tích hợp MRAM của Everspin thay cho tụ điện siêu dung để bảo vệ dữ liệu khi mất điện.
MRAM trong FCM5 được dùng như bộ đệm ghi hoặc cache cho dữ liệu nhỏ, cũng như vùng lưu metadata nhất quán. Vì MRAM không mất dữ liệu khi mất điện, các ổ này không cần super-cap để đẩy metadata ra NAND khi có sự cố nguồn; metadata được giữ trực tiếp trong MRAM và tồn tại qua mọi lần mất điện. Không gian vật lý vốn dành cho super-cap được giải phóng cho chip NAND, tăng dung lượng hữu dụng. IBM đã dùng vài trăm MB MRAM của Everspin trong các FCM như một cache ghi và bộ nhớ nhật ký không mất dữ liệu trong nhiều năm, chứng minh rằng bộ nhớ bền vững này không chỉ là ý tưởng phòng lab mà đã chín cho môi trường sản xuất.
Ý nghĩa chiến lược: từ độ trễ lưu trữ giảm đến tính bền vững dữ liệu cho AI
Câu hỏi không còn là “MRAM có thay thế DRAM hay NAND không?” mà là “doanh nghiệp sẽ chèn MRAM vào đâu trong kiến trúc bộ nhớ AI để tối đa hiệu quả chi phí?”. Everspin không muốn MRAM trở thành bản sao của NAND; họ xem nó là lớp cache bền vững hiệu năng cao, khi kết hợp với SSD flash sẽ tạo thành một tổ hợp bộ nhớ-lưu trữ rất nhanh. MRAM cung cấp tốc độ truy cập tầm DRAM, độ bền cực cao và không mất dữ liệu, trong khi CXL mang đến con đường chuẩn hóa để gắn bộ nhớ này vào máy chủ hiện có. Khi CXL-MRAM đem lại độ trễ thấp hơn 100 lần so với SSD NVMe, độ trễ lưu trữ giảm trực tiếp chuyển hóa thành GPU bận rộn hơn và chi phí vận hành cho mỗi tác vụ AI thấp hơn.
Từ góc nhìn kiến trúc, MRAM kết nối CXL tạo ra một “vành đai an toàn” mới: dữ liệu quan trọng như checkpoint mô hình, KV cache, nhật ký giao dịch có thể nằm trên một tầng bộ nhớ bền vững có tốc độ gần DRAM, thay vì trên SSD hoặc DRAM có pin. So với các giải pháp DRAM kèm pin hoặc super-cap, MRAM mang tính bền vững dữ liệu cao hơn vì không phụ thuộc vào thành phần hóa học, giảm lo ngại về tuổi thọ pin và bảo trì. So với NAND, MRAM có tốc độ truy cập theo nanosecond và độ bền ghi vượt trội, trong khi SSD vẫn phải gánh thêm độ trễ từ giao thức lưu trữ. Doanh nghiệp muốn dẫn đầu trong AI nên xem MRAM kết nối CXL không phải là “đồ chơi mới”, mà là tầng hạ tầng bắt buộc nếu muốn cân bằng giữa hiệu năng, tính bền vững dữ liệu và khả năng mở rộng trong thập kỷ tới.