
AI cục bộ laptop là gì và vì sao đây là bước ngoặt
AI cục bộ laptop là cách chạy mô hình trí tuệ nhân tạo trực tiếp trên thiết bị của bạn, xử lý văn bản, hình ảnh hay dịch thuật ngay trên máy thay vì gửi dữ liệu lên máy chủ đám mây, từ đó giảm độ trễ, tăng quyền kiểm soát dữ liệu và tránh phụ thuộc kết nối mạng. Khi nói về AI cục bộ, điều quan trọng không phải là “chạy được hay không”, mà là câu hỏi: nó có đủ nhanh và đáng tin để thay thế API đám mây trong đời sống hàng ngày hay chưa. Từ góc nhìn cá nhân, câu trả lời bắt đầu nghiêng rõ về phía “có”. Vitalik Buterin đánh giá AI trên laptop đang tiến tới “bước ngoặt thực tế” khi các mô hình cục bộ trên Strix Halo của ông đã xử lý được một “phần lớn” công việc thường ngày.
Quyền riêng tư AI: lợi thế cục bộ mà đám mây khó cạnh tranh
Nếu bạn quan tâm tới bảo vệ quyền riêng tư AI, mô hình cục bộ là lựa chọn hợp lý hơn là gửi mọi câu hỏi và tài liệu lên đám mây. Khi dịch thuật on-device, văn bản không bao giờ rời khỏi thiết bị của người dùng, không có máy chủ trung gian, không thêm thỏa thuận xử lý dữ liệu, không chuyển dữ liệu xuyên biên giới và người dùng hiểu rõ hơn dữ liệu của mình được xử lý thế nào. Đây không phải chi tiết pháp lý khô khan mà là khác biệt thực tế: email nội bộ, ghi chú tài chính, thậm chí gợi ý giao dịch tiền mã hóa có thể được phân tích mà không ai ngoài bạn thấy được ngữ cảnh đầy đủ. Ngay cả trong ví tiền mã hóa, nơi AI chưa được quyền điều khiển tài sản, suy luận cục bộ vẫn giúp cải thiện riêng tư, trong khi quyền chuyển tiền được giữ sau các cơ chế kiểm soát riêng biệt và có thể cưỡng chế.
Speculative decoding: bí quyết để AI cục bộ nhanh như API đám mây
Nhiều người từng thử AI cục bộ laptop rồi bỏ cuộc vì tốc độ suy luận quá chậm, nhất là với mô hình lớn trên máy phổ thông. Tuy nhiên, tốc độ không còn là án tử nếu bạn chấp nhận một chút kỹ thuật. Speculative decoding là ví dụ rõ nhất: thay vì để mô hình lớn tự sinh từng token, bạn ghép nó với một mô hình nhỏ hơn làm “bản nháp”. Mô hình nháp dự đoán nhanh một cụm token phía trước, mô hình lớn kiểm tra trong một lượt, chấp nhận những token đúng và chỉnh khi cần. Cách này bỏ đi việc sinh từng token tự hồi quy, giúp mô hình chấp nhận nhiều token một lần, giảm độ trễ và tăng thông lượng mà không làm giảm chất lượng kết quả cuối. Người dùng đã báo cáo rằng sau khi bật speculative decoding với mô hình nháp phù hợp, họ còn thích dùng AI cục bộ hơn API đám mây vì cảm giác phản hồi gần như tức thì.
Mô hình ngôn ngữ nhỏ gọn và dịch thuật on-device: hiệu năng trong giới hạn laptop
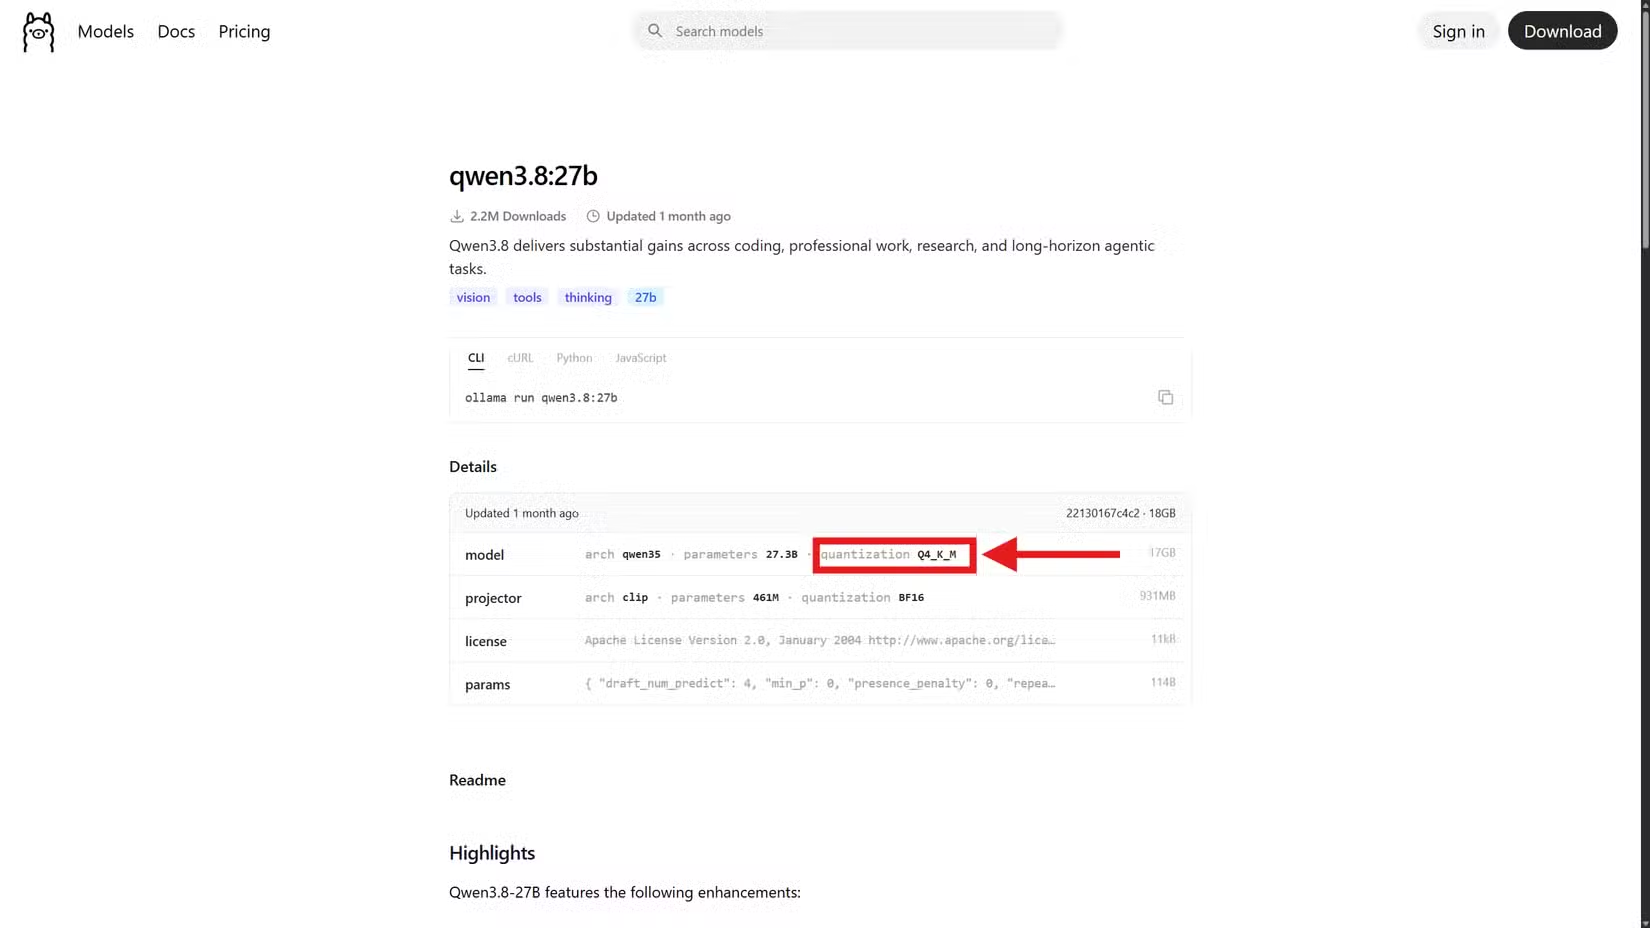
Một hiểu lầm phổ biến là phải cần GPU khủng mới chạy được AI cục bộ laptop. Thực tế, xu hướng mô hình ngôn ngữ nhỏ gọn đang phá vỡ giả định đó. Qwen 3.8 Flash và cải tiến trong llama.cpp giúp mô hình cục bộ xử lý “phần lớn” công việc trên chiếc Strix Halo mà không cần hạ tầng máy chủ chuyên dụng, sử dụng suy luận văn bản và hình ảnh thông qua các bản GGUF đã lượng tử hóa. Ở mảng dịch thuật on-device, nhóm nghiên cứu của Tether phát triển TranslatePsy-EuroNano: mỗi mô hình dịch đa ngôn ngữ hỗ trợ chín ngôn ngữ châu Âu từ một bộ triển khai đa ngôn ngữ, thay vì hàng chục mô hình song ngữ riêng biệt. Bộ triển khai này nhỏ 17,6 lần so với hệ thống dịch tương đương, chỉ chiếm 36MB đến 89MB tùy phiên bản nhưng vẫn giữ chất lượng dịch tương đương. Kết quả là ứng dụng di động, nền tảng giáo dục hay phần mềm nghiên cứu có thể cung cấp dịch thuật đa ngôn ngữ on-device mà không gây tải nặng lên bộ nhớ và CPU của thiết bị, đồng thời giảm độ trễ vì ít mô hình hơn và phản hồi nhanh hơn.
Hiệu năng không chỉ là tokens per second: người dùng cần xem gì trước khi tải mô hình
Tokens per second là con số mà nhiều người chăm chăm nhìn khi thử AI cục bộ, nhưng đó nên là chỉ số cuối cùng trong danh sách kiểm tra của bạn. Một người dùng kinh nghiệm đã phải xây dựng “checklist số liệu” sau khi nhiều lần tải mô hình lớn rồi phát hiện chúng chạy chậm, tràn khỏi VRAM và đổ sang RAM hệ thống. Theo anh ta, chỉ mất vài phút xem trước bốn con số là có thể tiết kiệm rất nhiều băng thông cho người mới bước vào thế giới suy luận cục bộ. Ngay cả khi bạn chạy trên CPU laptop, cách nghĩ này vẫn đúng: hãy xem kích thước trọng số, kiểu lượng tử hóa, nhu cầu bộ nhớ cho ngữ cảnh (KV cache) và thông số cấu hình suy luận, rồi mới so sánh tokens per second. Vitalik Buterin chia sẻ một bảng benchmark trên laptop với tốc độ xử lý đầu vào từ 109,82 đến 373,22 tokens mỗi giây và tốc độ sinh đầu ra từ 18,42 đến 33,37 tokens mỗi giây. Những con số này cho thấy AI cục bộ có thể đáp ứng tốt nếu cấu hình hợp lý, nhưng bạn cần đánh giá trước thay vì tải về một cách mù mờ.