
Shadow AI doanh nghiệp: IT bóng tối phiên bản AI và vì sao nguy hiểm
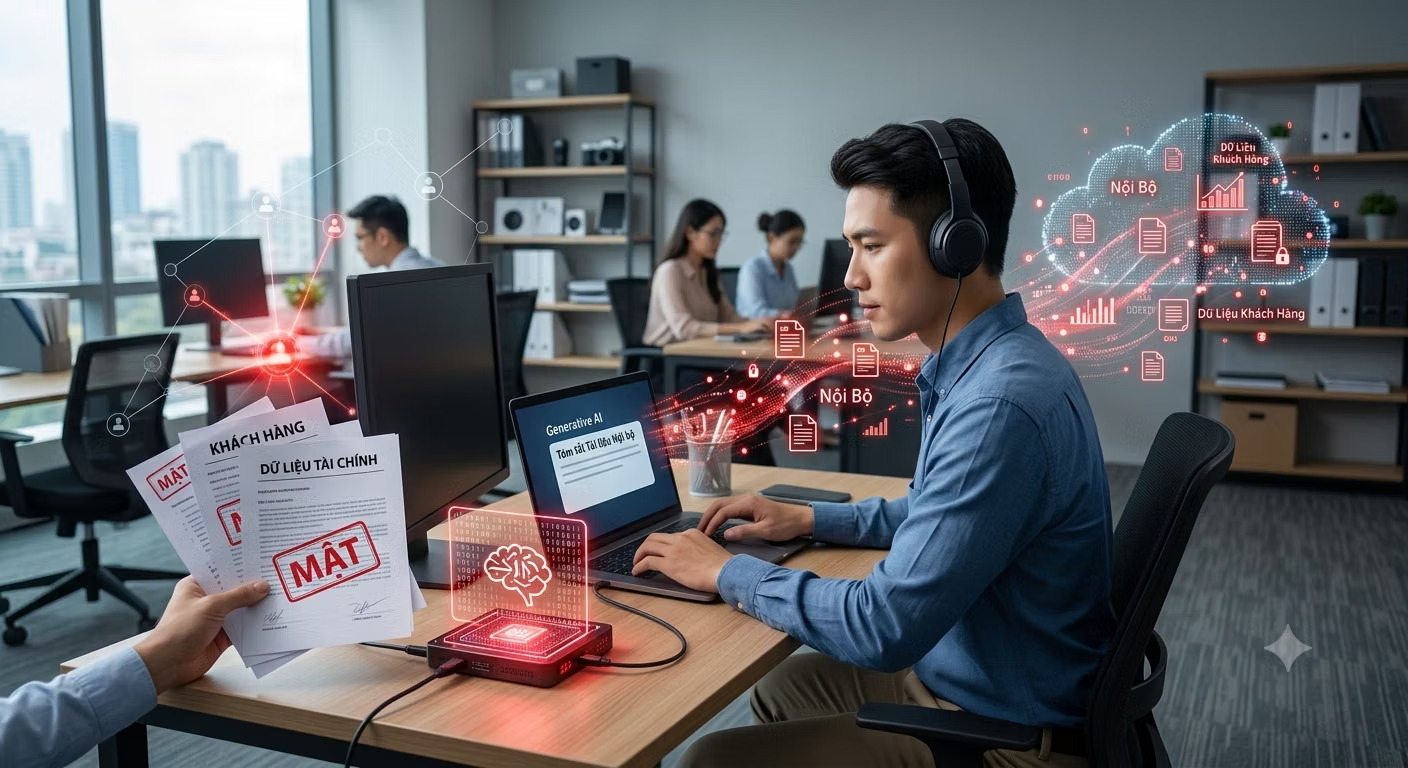
Shadow AI doanh nghiệp là tình trạng nhân viên âm thầm sử dụng các công cụ trí tuệ nhân tạo bên ngoài, không được phê duyệt và không chịu giám sát của bộ phận CNTT, khiến dữ liệu nội bộ bị đẩy ra ngoài biên giới kiểm soát của tổ chức và mở ra một lớp rủi ro bảo mật hoàn toàn mới.
Khác với tấn công từ bên ngoài, Shadow AI bắt nguồn ngay từ bên trong doanh nghiệp, do chính nhân viên tạo ra khi dùng ChatGPT, Claude, DeepSeek hay các ứng dụng AI tạo sinh cho công việc hàng ngày mà không xin phép. Về mặt hiệu suất, họ có thể tóm tắt hợp đồng, phân tích bảng tính, rà soát mã nguồn… nhanh hơn thấy rõ. Nhưng đổi lại, dữ liệu nhạy cảm bị gửi vào những hệ thống mà doanh nghiệp không biết nó đi đâu, xử lý ra sao và đang được bảo vệ bằng cơ chế nào. Đó là “lỗ hổng tự nguyện”: doanh nghiệp chủ động giao tài sản quý nhất – dữ liệu – cho một bên thứ ba vô hình mà không hề ký bất kỳ điều khoản kiểm soát nào.
Theo một báo cáo về đe dọa đám mây và AI, số người dùng trợ lý AI như ChatGPT và Gemini trong doanh nghiệp tăng gấp 3 lần, số lượng prompt tăng 6 lần và trung bình mỗi tổ chức ghi nhận khoảng 223 vụ vi phạm chính sách dữ liệu liên quan đến AI mỗi tháng. Con số này nói lên một điều: nếu ban lãnh đạo vẫn coi Shadow AI là chuyện nhỏ lẻ, doanh nghiệp đang tự chấp nhận rủi ro dữ liệu AI ở quy mô công nghiệp.
Rủi ro dữ liệu AI: Không chỉ là câu lệnh, mà là bí mật sống còn
Vấn đề lớn nhất của Shadow AI doanh nghiệp không phải là nhân viên có dùng AI hay không, mà là họ đang đưa loại dữ liệu nào vào đó và doanh nghiệp mất kiểm soát ở mức độ nào. Khi tài liệu được nạp vào các dịch vụ AI chưa được phê duyệt, tổ chức mất khả năng kiểm soát việc dữ liệu được gửi đi đâu, xử lý thế nào và được bảo vệ bằng biện pháp gì.
Các số liệu cho thấy rủi ro dữ liệu AI đã vượt khỏi ngưỡng “thí điểm”. Trong các vụ vi phạm bị phát hiện, mã nguồn chiếm tới 42%, dữ liệu thuộc diện quản lý chiếm 32% và tài sản trí tuệ chiếm 16%. Đây đều là những loại bí mật kinh doanh mà một khi rò rỉ, doanh nghiệp có thể mất lợi thế cạnh tranh, mất tuân thủ pháp lý hoặc đối mặt kiện tụng. Tệ hơn, khoảng 50% tổ chức được khảo sát vẫn chưa có chính sách bảo vệ dữ liệu có khả năng thực thi đối với ứng dụng AI tạo sinh.
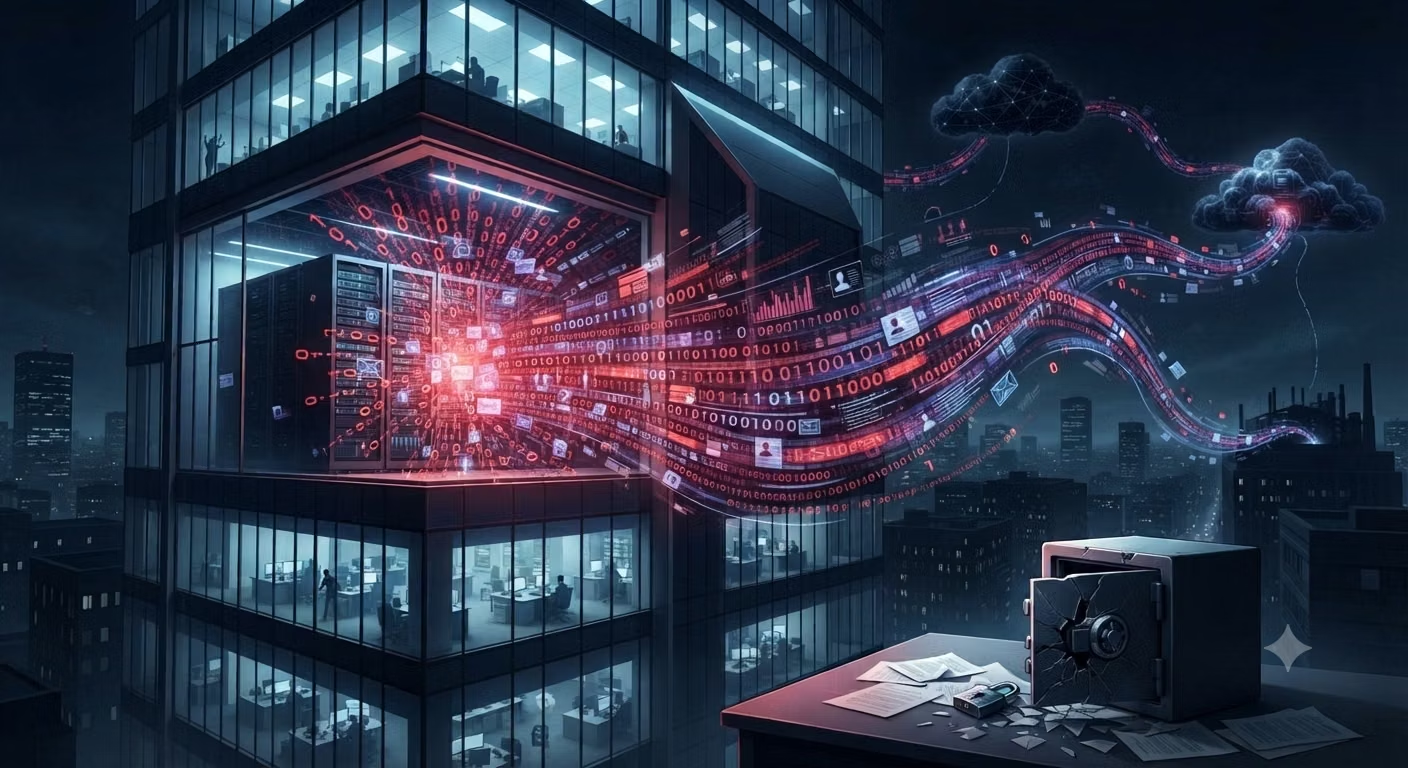
Điểm đáng sợ là nhiều lãnh đạo vẫn tưởng rằng rủi ro chỉ nằm trong nội dung prompt người dùng gửi lên. Thực tế, khi các hệ thống AI bắt đầu kết nối vào cơ sở dữ liệu, kho tài liệu, hệ thống khách hàng và API nội bộ, dòng dữ liệu không còn là một chiều nữa. Dữ liệu nhạy cảm có thể được AI xử lý rồi trả ngược vào hệ thống khác hoặc đẩy sang một dịch vụ ngoài mà không ai giám sát. Khi đó, doanh nghiệp không chỉ mất dữ liệu, mà còn mất dấu vết quyền truy cập – hậu quả khó kiểm soát hơn nhiều so với một lần gửi nhầm file.
Từ Shadow AI đến Shadow Agents: Khi AI không chỉ đọc mà còn hành động
Nếu Shadow AI đã nguy hiểm, thì bước chuyển sang AI agent không được kiểm soát – những “Shadow Agents” – còn đáng lo hơn. Một AI agent có thể được kết nối với cơ sở dữ liệu, CRM, kho tài liệu, phần mềm kế toán hoặc API nội bộ; khi được cấp quyền, nó không chỉ đọc dữ liệu mà còn gọi dịch vụ, tạo hồ sơ, cập nhật thông tin hay thực hiện quy trình. Câu hỏi bảo mật vì thế không còn là “AI thấy gì?” mà phải là “AI được phép làm gì với những gì nó thấy?”.
Các bộ phận tài chính, nhân sự, bán hàng… đều có thể tự xây dựng agent của riêng mình; nhân viên tạo agent cá nhân; nhà cung cấp âm thầm nhúng agent vào sản phẩm sẵn có. Nhân rộng lên toàn tổ chức, CIO không còn đối diện với vài chục bot, mà là hàng trăm, hàng nghìn thực thể phần mềm có khả năng chạm tới hệ thống và thực hiện hành động. Khi đó, rủi ro không chỉ là lộ dữ liệu mà là chuỗi hành động không được giám sát: ai đã xây mỗi agent, nó đang làm gì, đụng tới những hệ thống nào, có quyền gì và ai chịu trách nhiệm sở hữu.
Việc giữ con người “trong vòng lặp” cho mọi hành động của hàng nghìn agent là bất khả thi về mặt nguồn lực. Cách tiếp cận thực tế hơn là kiểm soát AI agent dựa trên rủi ro: một agent cập nhật hồ sơ nội bộ không thể bị đối xử giống một agent có quyền phê duyệt giao dịch tài chính hoặc thay đổi dữ liệu quan trọng. Nếu doanh nghiệp không sớm nhận diện và kiểm soát lớp Shadow Agents này, chương trình quản trị AI sẽ chỉ là giả định rằng “ai đó đang trông chừng”.
AI Gateway bảo mật: “Một cửa” để giám sát và kiểm soát AI agent
Để thoát khỏi tình trạng mỗi bộ phận tự dùng công cụ AI riêng, doanh nghiệp cần một kiến trúc “một cửa” – AI Gateway bảo mật – làm lớp cổng trung tâm cho mọi tương tác giữa người dùng, hệ thống nội bộ và các dịch vụ AI bên ngoài. Vai trò của lớp cổng này không phải là cấm đoán, mà là hợp thức hóa và giám sát: ai dùng công cụ gì, dữ liệu nào được gửi đi, kết quả đi về đâu, agent nào được phép chạm vào hệ thống nào.
Các giải pháp như DLP, CASB hoặc AI gateway/proxy có thể hỗ trợ phát hiện và ngăn chặn việc chuyển dữ liệu nhạy cảm tới dịch vụ không được phép. Nếu triển khai đúng, AI Gateway bảo mật trở thành bộ phận “hải quan dữ liệu”: mọi dòng dữ liệu ra/vào môi trường AI đều được soi chiếu chính sách, gắn nhãn và ghi log. Nhờ đó, doanh nghiệp có thể định nghĩa và thực thi chính sách khác nhau cho từng loại dữ liệu, từng nhóm người dùng, từng loại AI agent – thay vì phó mặc cho ý thức cá nhân.
Quan trọng hơn, AI Gateway là nền tảng để thực sự kiểm soát AI agent. Khi mọi agent buộc phải đi qua một cổng chung, CIO có thể lập danh mục: ai tạo ra từng agent, nó có nhiệm vụ gì, truy cập hệ thống nào, có quyền gì và đang thuộc trách nhiệm của ai. Đây là điều kiện tối thiểu để thoát khỏi trạng thái Shadow AI doanh nghiệp, tiến tới một mô hình quản trị nơi AI được dùng nhiều hơn, nhưng dữ liệu và quyền truy cập lại minh bạch hơn so với thời “không AI”.
Thiết kế chuẩn kiểm soát: tiêu chuẩn đầu ra, điểm duyệt và quyền dừng
Xây cổng là chưa đủ; doanh nghiệp cần bộ “nội quy vận hành” rõ ràng cho từng AI agent. Mỗi agent phải được thiết kế kèm theo tiêu chuẩn đầu ra, các điểm duyệt và cơ chế “kéo phanh khẩn cấp” – nếu không, AI Gateway chỉ nhìn thấy lưu lượng, chứ không biết khi nào cần can thiệp. Nguyên tắc “ít quyền nhất” cần được áp dụng cho cả tài khoản con người, token và tác tử AI: mỗi tác tử chỉ được cấp đúng phần dữ liệu, trong đúng khoảng thời gian và với đúng loại hành động cần thiết để hoàn thành nhiệm vụ.
Theo một mô hình được đề xuất, mức độ can thiệp của con người nên dựa trên các yếu tố: giá trị tiền tệ của hành động, độ nhạy cảm của dữ liệu, mức độ tự tin của agent, mức độ phơi bày pháp lý và việc agent có hoạt động ngoài tham số dự kiến hay không. Từ đó có thể thiết kế các điểm kiểm tra: phê duyệt trước khi thực thi, can thiệp giữa nhiệm vụ, đánh giá sau khi thực thi và lấy mẫu định kỳ để rà soát chất lượng.
Những hành động có mức độ ảnh hưởng cao – như thay đổi dữ liệu quan trọng, phê duyệt giao dịch, tác động tới tài chính – bắt buộc phải có cơ chế phê duyệt bởi con người, không để AI tự động thực hiện hoàn toàn. Đồng thời, mọi agent cần có “quyền dừng”: khả năng bị tạm khóa hoặc thu hồi quyền truy cập ngay khi phát hiện bất thường. Kết luận quan trọng là: doanh nghiệp không nên hỏi “AI có an toàn không”, mà phải hỏi “AI đang được phép truy cập dữ liệu nào, với quyền hạn nào, trong bao lâu và được phép làm gì với dữ liệu đó?”.