
Kết luận nhanh: chọn theo việc mô hình cần làm
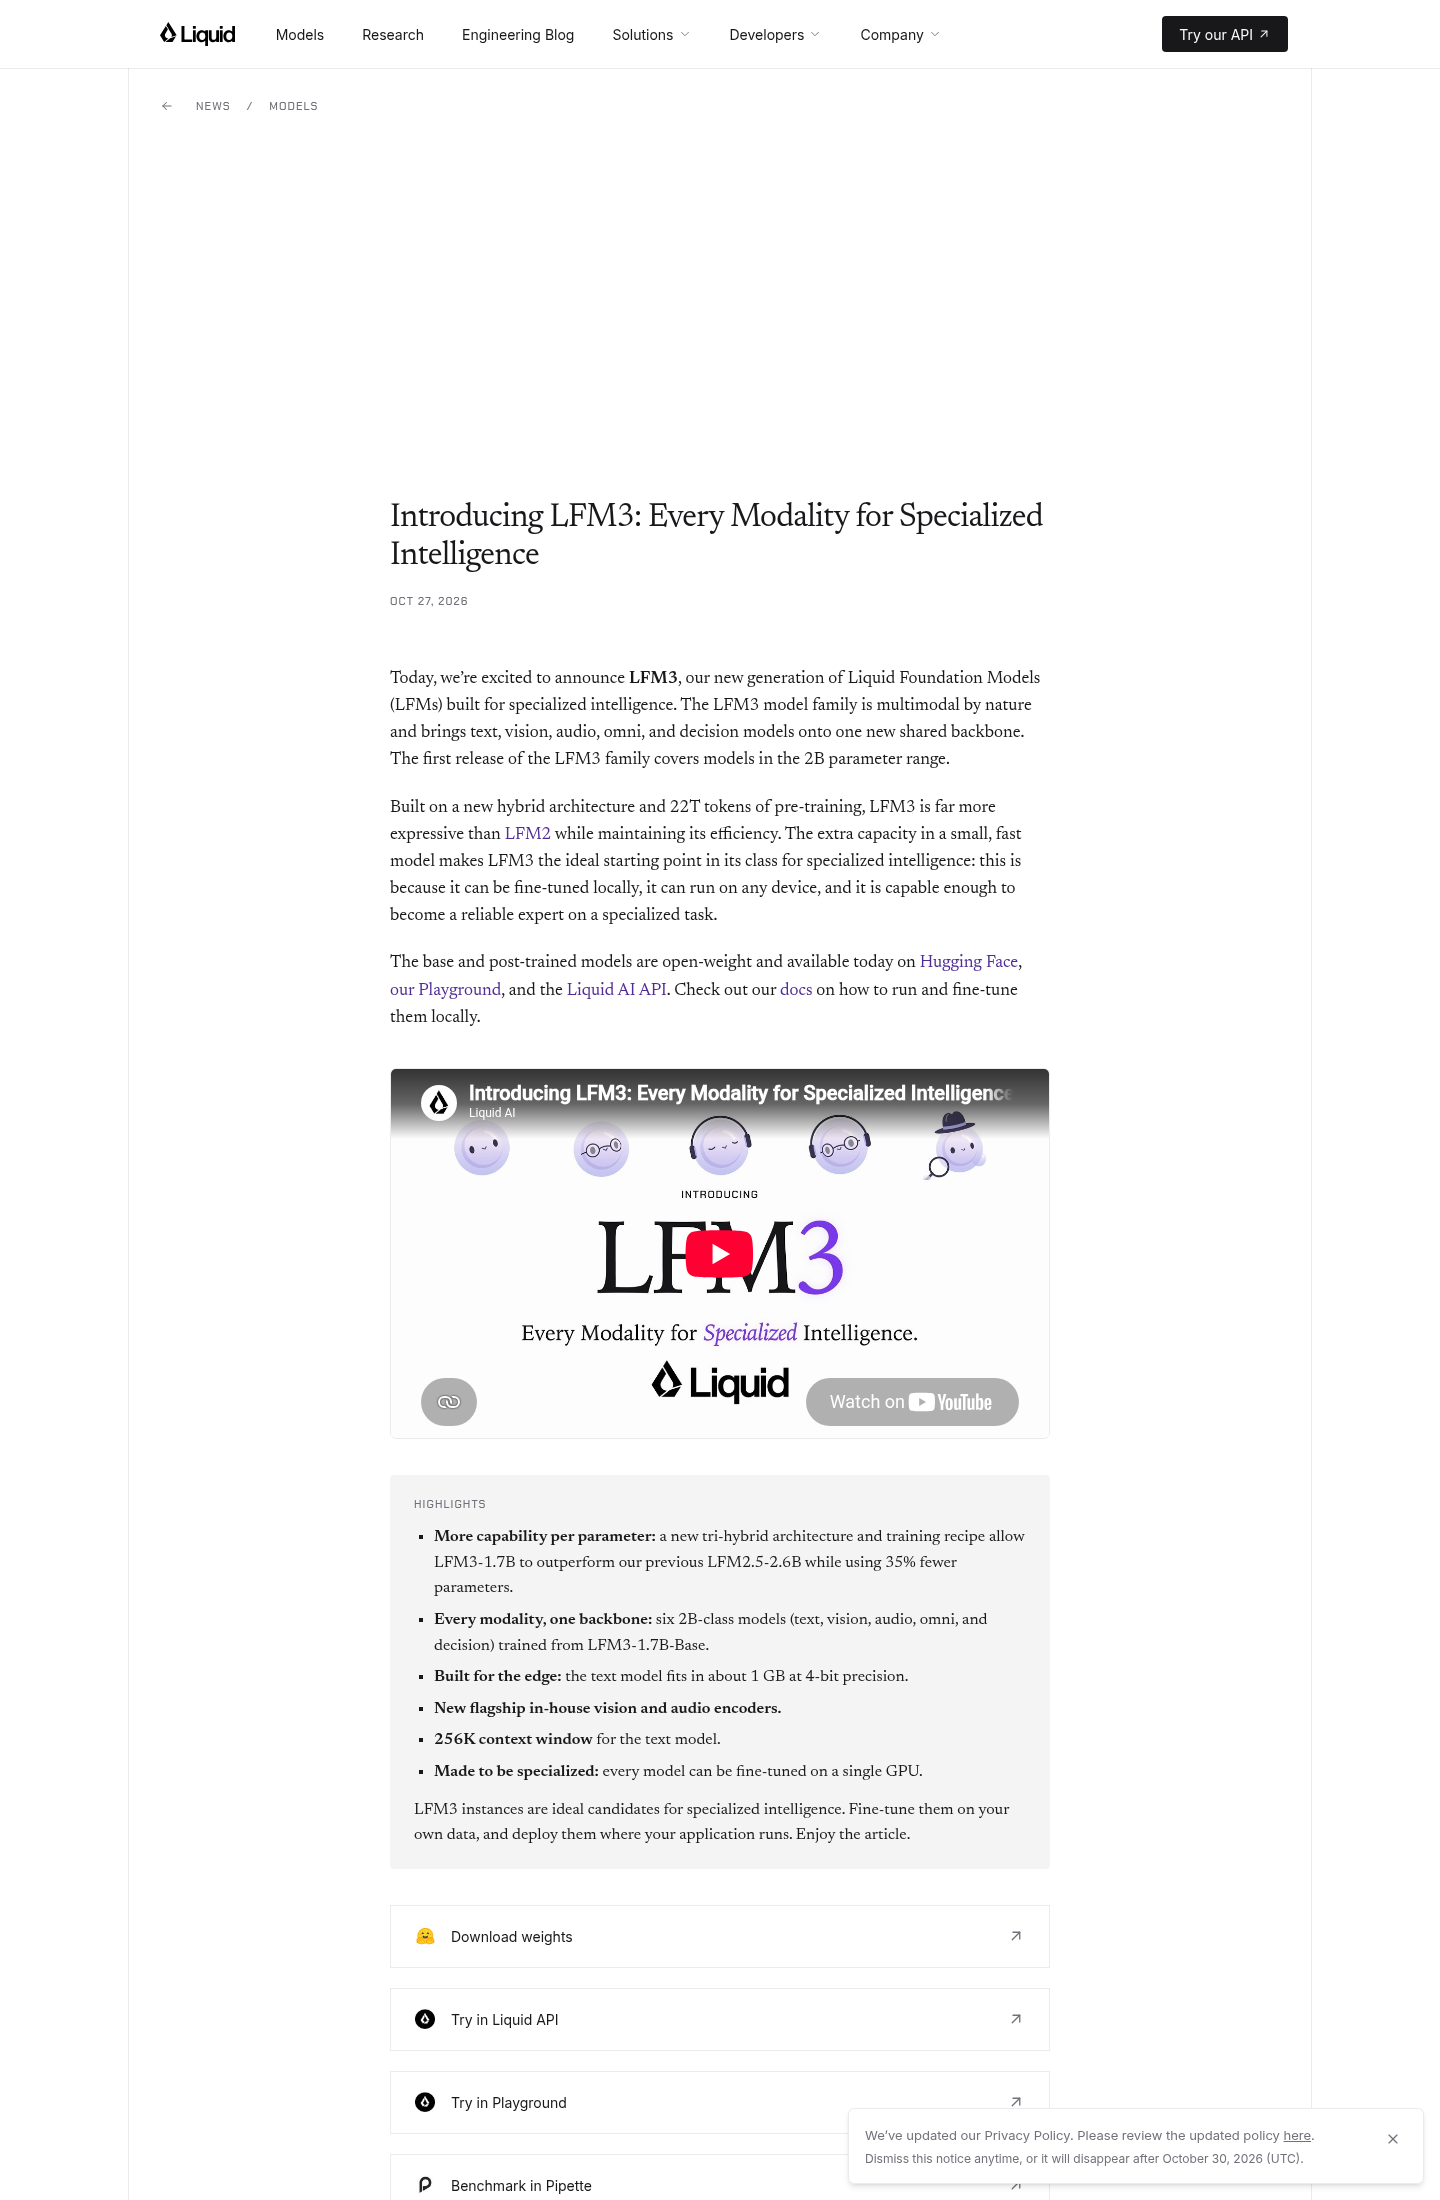
Mô hình AI nhỏ đa phương thức là mô hình gọn có thể xử lý một hoặc nhiều dạng dữ liệu như văn bản, hình ảnh, âm thanh và video, với đánh đổi giữa năng lực chuyên biệt, kích thước và số tác vụ đảm nhiệm. Nếu ưu tiên đọc ảnh, tài liệu và ngữ cảnh dài, MiniCPM-V 4.7 1B là lựa chọn thuyết phục nhất trong nhóm này. Nếu cần một mô hình nghe và trả lời bằng giọng nói, LFM3-Omni-2B có lợi thế chức năng, nhưng điểm nhìn thấp hơn LFM2.5-VL-3B ở bốn trong năm benchmark thị giác chung. Còn nếu thị giác là mục tiêu chính và bạn muốn kết quả tốt hơn LFM3 ở phần lớn phép thử được đối chiếu, LFM2.5-VL-3B hợp lý hơn. Những điểm số này giúp chọn mô hình cho tác vụ cụ thể, không phải bảng xếp hạng đầy đủ năng lực đa phương thức.
Nhìn riêng các benchmark thị giác được hai thẻ mô hình cùng công bố, MiniCPM-V 4.7 1B vượt LFM3-Omni-2B: lần lượt đạt 86,1 so với 80,6 trên OCRBench, 69,5 so với 55,67 trên MMStar, 56,9 so với 42,44 trên MMMU và 74,3 so với 62,5 trên MathVista. Đây là lợi thế rõ rệt cho đọc chữ, biểu đồ và câu hỏi hình ảnh. Tuy nhiên, LFM3-Omni không chỉ là mô hình nhìn: nó còn nhận âm thanh và tạo giọng nói. Vì vậy, nên chọn theo đầu ra và quy trình thực tế, thay vì xem điểm thị giác là thước đo duy nhất.
Thông số cốt lõi và điểm benchmark
Bảng dưới đặt ba mô hình cạnh nhau để thấy rõ khác biệt về quy mô, đầu vào và mục tiêu. Số liệu benchmark của MiniCPM-V và LFM3-Omni được báo cáo trên bốn phép thử chung; LFM2.5-VL và LFM3-Omni có năm phép thử chung. Các cặp điểm trong bảng giữ nguyên thứ tự đó để tránh trộn thành một bảng xếp hạng không cùng bộ đánh giá.
| Thông số | MiniCPM-V 4.7 1B | LFM3-Omni-2B | LFM2.5-VL-3B |
|---|---|---|---|
| Tham số | Khoảng 1,3–1,55 tỷ dense | 2,17 tỷ dense | Khoảng 3,1 tỷ, gồm bộ mã hóa thị giác 400 triệu |
| Đầu vào | Văn bản, hình ảnh, nhiều ảnh và video | Văn bản, hình ảnh, video và âm thanh 16 kHz | Văn bản, hình ảnh và video |
| Đầu ra | Văn bản | Văn bản và giọng nói 24 kHz | Văn bản |
| Ngữ cảnh | 262.144 token | 32.768 token | 32.768 token |
| Xử lý hình ảnh | Nén token thị giác 4× hoặc 16× | Tối đa 2.048 token thị giác mỗi ảnh | Mảnh 512 pixel ở độ phân giải gốc, có đường dẫn hình thu nhỏ |
| Giấy phép | Apache-2.0 | LFM Open License v1.0 | LFM Open License v1.0 |
| Benchmark thị giác | So với LFM3: OCRBench 86,1–80,6; MMStar 69,5–55,67; MMMU 56,9–42,44; MathVista 74,3–62,5 | So với LFM2.5: RealWorldQA 66,68–73,1; MMStar 55,67–63,3; MMBench 73,68–81,0; RefCOCO 73,55–87,9; DocVQA 92,47–91,1 | So với LFM3: RealWorldQA 73,1–66,68; MMStar 63,3–55,67; MMBench 81,0–73,68; RefCOCO 87,9–73,55; DocVQA 91,1–92,47 |
| Dung lượng BF16 và ngày phát hành | Khoảng 3,1 GB; 12-10-2026 | Khoảng 4,3 GB; 27-10-2026 | Không nêu trong dữ liệu đối chiếu; ra mắt 12-08-2026 |
MiniCPM-V 4.7 1B nổi bật nhờ ngữ cảnh 262.144 token, tức khoảng tám lần LFM3-Omni-2B, và dung lượng tệp BF16 nhỏ hơn. Lợi thế ấy đáng giá khi xử lý PDF dài hoặc nhiều lượt trao đổi về tài liệu; nó không tự động bảo đảm chất lượng cao hơn trong mọi thiết lập. Con số OCRBench 86,1 được đo ở mức nén thị giác 4×; mức 16× chạy tiết kiệm hơn nhưng được nguồn mô tả là cho điểm thấp hơn, không nêu điểm cụ thể.
Ba cách đánh đổi: chuyên nhìn, đa phương thức hay VLM mạnh hơn
MiniCPM-V 4.7 dành ngân sách cho thị giác và cho phép chọn mức nén token sớm: 4× giữ lại nhiều chi tiết hơn, phù hợp OCR tài liệu, biểu đồ và ảnh chụp màn hình; 16× phù hợp hơn khi ưu tiên xử lý gọn. Đây là lựa chọn tốt nhất trong nhóm nếu việc chính là đọc, nhưng mô hình chỉ trả về văn bản, không nghe âm thanh hay tạo giọng nói. Giấy phép Apache-2.0 cũng khác hai mô hình Liquid AI, vốn dùng LFM Open License v1.0 với điều kiện thương mại theo ngưỡng doanh thu được nêu trong tài liệu.
LFM3-Omni-2B đổi một phần năng lực thị giác lấy khả năng nhận văn bản, ảnh, video có hoặc không có âm thanh nền và âm thanh 16 kHz, rồi tạo văn bản hoặc giọng nói 24 kHz. Trên năm benchmark thị giác chung với LFM2.5-VL-3B, nó thua ở RealWorldQA, MMStar, MMBench và RefCOCO, nhưng thắng DocVQA với 92,47 so với 91,1. Vì thế, gọi đây là bản nâng cấp thị giác sẽ gây hiểu nhầm: điểm của nó nằm ở quy trình nghe-nói đa phương thức, không phải đứng đầu mọi bài kiểm tra ảnh. LFM2.5-VL-3B phù hợp hơn nếu cần VLM chuyên xử lý OCR, giao diện và hỏi đáp hình ảnh.
Benchmark thị giác không đo được khả năng nghe âm thanh, tổng hợp giọng nói hay kết hợp các luồng đầu vào. Ngược lại, một lợi thế OCR không nói lên mô hình sẽ làm tốt hơn trong hội thoại bằng giọng nói. Các số liệu ở đây cũng do nhà cung cấp báo cáo và chưa được tái tạo độc lập; so sánh trong cùng bộ có ích để định hướng, nhưng vẫn nên thử trên dữ liệu và quy trình thực tế trước khi chốt.
Buy if / Skip if
- Buy the MiniCPM-V 4.7 1B if công việc chủ yếu là OCR, đọc hóa đơn, biểu mẫu, biểu đồ, ảnh chụp màn hình hoặc PDF dài; mô hình có điểm cao hơn LFM3-Omni-2B trên cả bốn benchmark thị giác chung được nêu và ngữ cảnh 262.144 token.
- Skip the MiniCPM-V 4.7 1B if bạn cần đầu vào âm thanh, xử lý tiếng nói hoặc đầu ra giọng nói ngay trong cùng mô hình.
- Buy the LFM3-Omni-2B if thiết bị cần nghe âm thanh 16 kHz, xử lý video có âm thanh và phản hồi bằng giọng nói 24 kHz; đây là điểm khác biệt mà hai mô hình thiên về thị giác không cung cấp.
- Skip the LFM3-Omni-2B if ưu tiên hàng đầu là thị giác: LFM2.5-VL-3B đạt điểm cao hơn ở bốn trong năm benchmark chung, còn MiniCPM-V 4.7 1B vượt nó ở bốn benchmark thị giác được so sánh.
- Buy the LFM2.5-VL-3B if bạn cần VLM chuyên dụng cho ảnh, tài liệu, giao diện người dùng hoặc định vị vật thể; nó dẫn trước LFM3-Omni-2B ở RealWorldQA, MMStar, MMBench và RefCOCO.
- Skip the LFM2.5-VL-3B if yêu cầu bắt buộc là hiểu âm thanh và tạo giọng nói từ một mô hình duy nhất.