
Đừng chọn TTS chỉ bằng một con số benchmark
Mô hình chuyển văn bản thành giọng nói (TTS) là hệ thống biến văn bản đầu vào thành âm thanh lời nói, có thể được cung cấp qua API hoặc chạy bằng trọng số trên phần cứng do người dùng quản lý. Với AI tạo giọng nói, lựa chọn đúng thường phụ thuộc trước hết vào nơi bạn muốn vận hành và mức kiểm soát cần có, chứ không phải một bảng xếp hạng duy nhất. Các phương án ở đây đại diện cho ba đánh đổi khác nhau: VoxCPM2 và Ming-3.0-tts-tiny là mô hình tải xuống; Drama 3 có trọng số mở nhưng đòi hỏi phần cứng lớn; AssemblyAI-TTS-1 là dịch vụ API tổng hợp giọng nói. Chúng không phải những sản phẩm có thể đặt cạnh nhau như thể cùng điều kiện thử nghiệm. VoxCPM2 công bố hệ số thời gian thực 0,30 trên RTX 4090 với PyTorch tiêu chuẩn, tức khoảng 3,3 giờ âm thanh tạo ra cho mỗi giờ GPU; chạy bằng Nano-VLLM, hệ số được nêu là 0,13. Ngược lại, Ming-3.0-tts-tiny chưa công bố thông lượng: không có hệ số thời gian thực hay số ký tự mỗi giây được đo trên card. Vì vậy, dữ liệu hiện có chưa thể chứng minh bên nào nhanh hơn trong cùng điều kiện.
Mô hình tải xuống: dung lượng và độ trưởng thành quan trọng
Ming-3.0-tts-tiny của inclusionAI thuộc Ant Group là mô hình hỗn hợp chuyên gia 7,9 tỷ tham số, kích hoạt khoảng 1,3 tỷ tham số mỗi token, chiếm khoảng 18 GB và khuyến nghị dùng H800; giấy phép được nêu là MIT. VoxCPM2 của OpenBMB là mô hình 2 tỷ tham số không dùng tokenizer, dựa trên MiniCPM-4, khoảng 8 GB ở bfloat16 và theo giấy phép Apache 2.0. Khác biệt về công bố hiệu năng khiến VoxCPM2 dễ lập kế hoạch triển khai hơn, nhưng không biến con số của nó thành phép so sánh trực tiếp với Ming. VoxCPM2 còn có tài liệu tinh chỉnh có giám sát đầy đủ và LoRA với 5–10 phút âm thanh, kèm tập lệnh và cấu hình huấn luyện. Đây là lợi thế thực tế nếu muốn thích nghi mô hình bằng dữ liệu riêng. Tuy nhiên, hai mô hình đều chưa có mục trên bảng xếp hạng trong tài liệu được cung cấp, cũng như chưa có giá dịch vụ lưu trữ được nêu. Với mô hình TTS mã mở, hãy kiểm tra giấy phép, bộ công cụ và mức độ hoạt động của dự án trước khi coi trọng số tải xuống là giải pháp sẵn sàng.
| Tiêu chí | Ming-3.0-tts-tiny | VoxCPM2 |
|---|---|---|
| Quy mô và dung lượng | 7,9 tỷ tham số; khoảng 18 GB | 2 tỷ tham số; khoảng 8 GB ở bfloat16 |
| Phần cứng được nêu | H800 được khuyến nghị | Có số đo tốc độ trên RTX 4090 |
| Thông lượng công bố | Chưa có | RTF 0,30 với PyTorch; 0,13 với Nano-VLLM trên RTX 4090 |
| Giấy phép | MIT | Apache 2.0 |
API tiện triển khai; Drama 3 đổi tiện ích lấy quyền kiểm soát
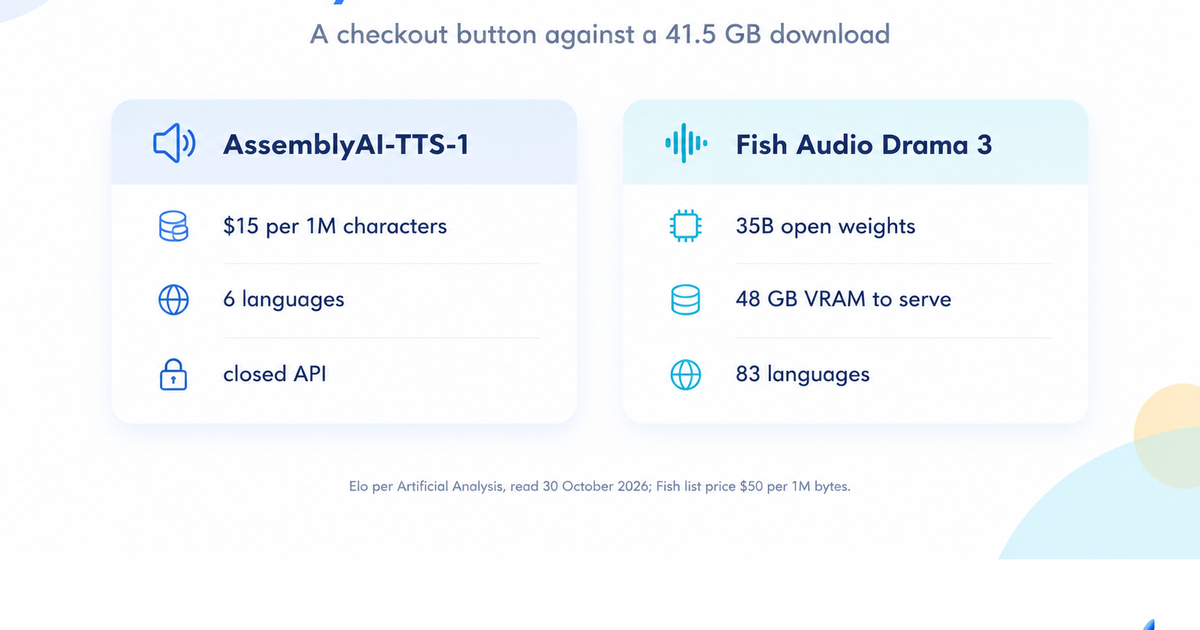
AssemblyAI-TTS-1 là điểm cuối HTTPS, hoạt động tại các khu vực Mỹ và EU, nhận văn bản mà không yêu cầu người dùng cung cấp GPU. Dịch vụ có giao tiếp HTTP và WebSocket, tuyến tương thích OpenAI, thư viện hơn 4.000 giọng và hỗ trợ nhân bản giọng từ mẫu ngắn. Đây là lựa chọn thực dụng cho nhóm cần đưa giọng nói vào ứng dụng nhanh, nhưng API đồng nghĩa với việc phụ thuộc vào dịch vụ, khu vực xử lý và cách tính phí theo ký tự. Drama 3 đi theo hướng ngược lại: mô hình hỗn hợp chuyên gia 35 tỷ tham số, trọng số khoảng 41,5 GB trước codec và cần khoảng 48 GB VRAM để phục vụ ở FP8. Trọng số có thể tải xuống không đồng nghĩa với triển khai nhẹ, cũng không tự động bảo đảm quyền sử dụng không giới hạn; cần đọc kỹ điều khoản giấy phép trước khi đưa vào sản phẩm. Drama 3 hỗ trợ 83 ngôn ngữ, tối đa 16 người nói trong một lượt và chỉ dẫn diễn xuất bằng ngôn ngữ tự nhiên. Đó là lợi thế cho lồng tiếng có dàn dựng, nhưng phần cứng và vận hành khiến nó khó thay thế một API gọn nhẹ.
- Mua/chọn AssemblyAI-TTS-1 nếu cần tích hợp nhanh qua API, tải đồng thời linh hoạt và không muốn quản lý GPU; bỏ qua nếu bắt buộc lưu toàn bộ mô hình trên hạ tầng riêng.
- Mua/chọn Drama 3 nếu cần diễn xuất có chỉ dẫn, nhiều người nói, hỗ trợ ngôn ngữ rộng hoặc lưu trú dữ liệu trên phần cứng của mình; bỏ qua nếu không có khoảng 48 GB VRAM và năng lực vận hành phù hợp.
- Mua/chọn VoxCPM2 nếu khối lượng dài, nhạy cảm với chi phí vận hành hoặc cần tinh chỉnh LoRA từ âm thanh riêng; bỏ qua nếu cần tốc độ đã được kiểm chứng trên chính cấu hình triển khai của mình mà chưa chạy thử.
- Mua/chọn Ming-3.0-tts-tiny nếu giấy phép MIT, kiến trúc MoE và phần cứng H800 phù hợp mục tiêu thử nghiệm; bỏ qua nếu cần dự báo thông lượng chắc chắn trước khi triển khai.
Chất lượng và tốc độ vẫn cần phép thử cùng điều kiện
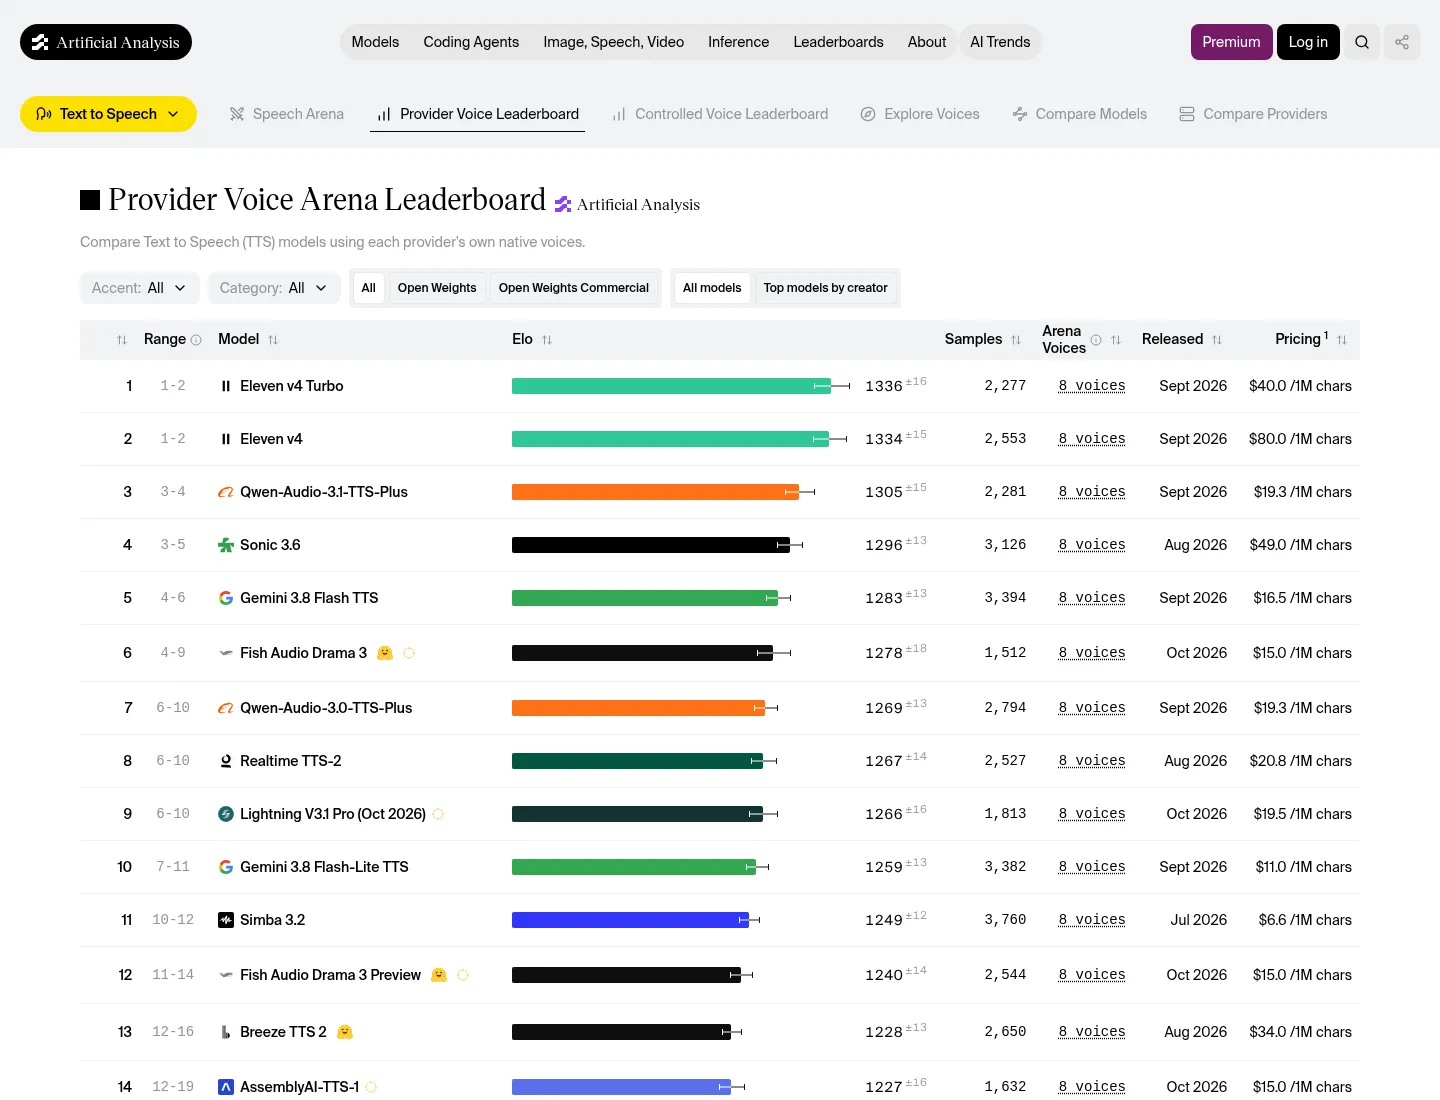
Số độ trễ của các nhà cung cấp không thể đặt cạnh nhau như một cuộc đua công bằng: phép đo có thể khác phần cứng, tải, cách tính thời điểm bắt đầu và cấu hình phục vụ. Tài liệu hiện có cũng không đưa ra phép thử đồng nhất đủ để kết luận mô hình nào nhanh hơn trong cùng điều kiện. Với Ming-3.0-tts-tiny, khoảng trống thông lượng còn rõ hơn vì chưa có số đo công khai. Tương tự, điểm xếp hạng không trả lời đầy đủ câu hỏi giọng nào tự nhiên hơn trong ứng dụng cụ thể. Drama 3 được mô tả là xếp cao hơn về độ tự nhiên, nhưng hai mô hình nằm trong khoảng nhiễu khi giữ cố định bản ghi tham chiếu. Điều đó không đủ để khẳng định ưu thế phổ quát, nhất là khi chất lượng cảm nhận còn tùy ngôn ngữ, giọng mẫu và loại nội dung. Trước khi cam kết, hãy chạy cùng văn bản, cùng giọng tham chiếu và phần cứng phù hợp; đo độ trễ, tốc độ tạo âm thanh, mức tiêu thụ bộ nhớ và chất lượng nghe được.
Kết luận: chọn theo cách bạn muốn vận hành. API phù hợp khi tốc độ tích hợp và sự đơn giản quan trọng hơn quyền kiểm soát hạ tầng; trọng số mở phù hợp khi cần tùy biến, lưu trú dữ liệu hoặc tự quản lý suy luận. Trong nhóm tải xuống, VoxCPM2 hiện có lợi thế về dữ liệu tốc độ và tài liệu tinh chỉnh, còn Ming-3.0-tts-tiny chưa cung cấp thông lượng để đối chiếu. Drama 3 mở rộng khả năng trình diễn nhưng yêu cầu phần cứng đáng kể. Không có dữ liệu đồng điều kiện, vì vậy đừng nhầm thông số riêng lẻ với bằng chứng rằng một mô hình vừa nhanh hơn vừa tự nhiên hơn.