
Từ dữ liệu internet bị ô nhiễm đến cuộc săn lùng ‘vàng xám’ trong sách in
Hiện tượng sách in trước 2022 bất ngờ được các hãng công nghệ săn lùng như một nguồn dữ liệu huấn luyện AI “vàng xám” xuất phát từ nỗi lo internet bị ô nhiễm bởi văn bản do máy tạo ra, nguy cơ suy thoái chất lượng mô hình ngôn ngữ và sự sụp đổ của mô hình kinh tế nội dung đổi lưu lượng, buộc ngành AI phải quay lại các nguồn dữ liệu sạch hơn, dài hơi hơn và giàu tính biên tập như sách in. Việc những thùng sách bị lần theo bằng AirTag, bí mật đưa đến kho, xé gáy, quét và tiêu hủy cho thấy cuộc đua tranh giành ngôn ngữ con người đã bước sang giai đoạn âm thầm nhưng khốc liệt.
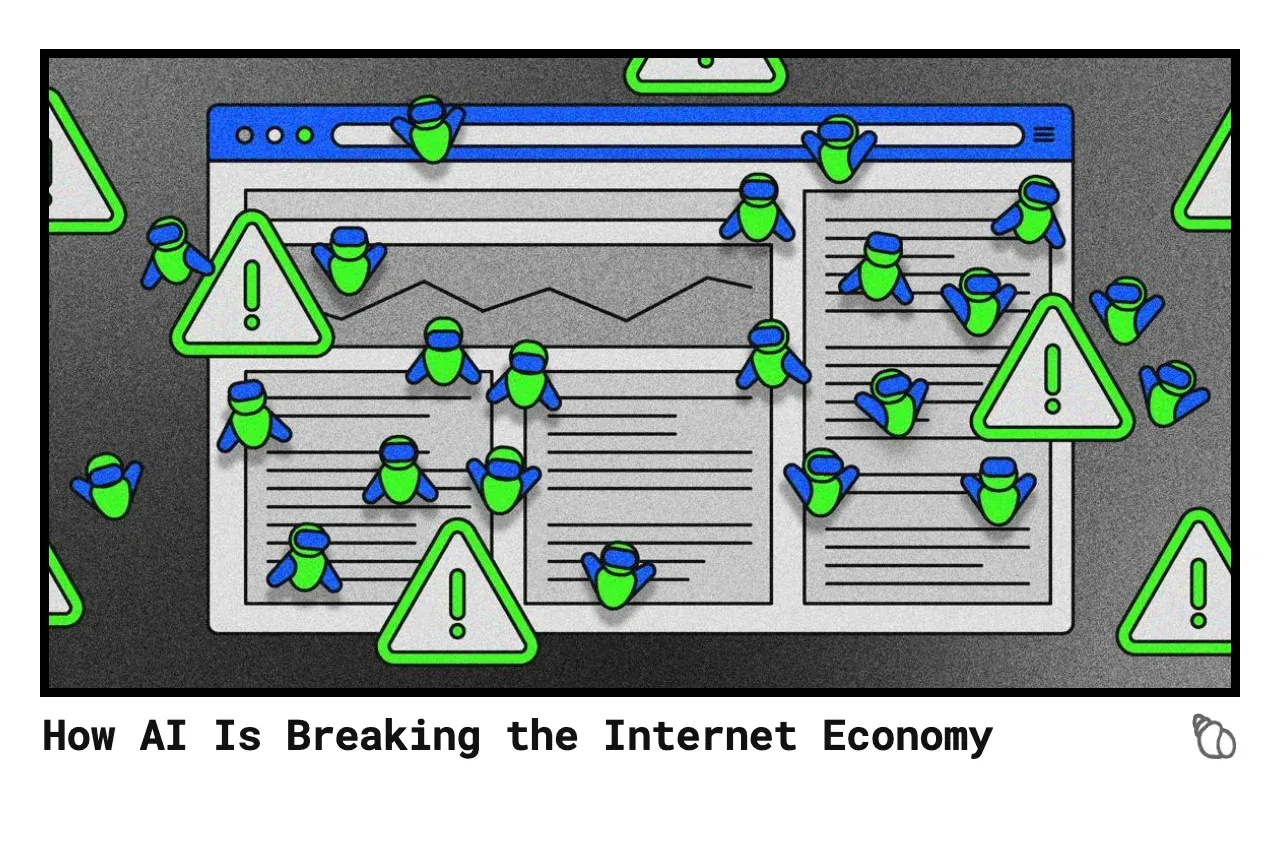
Một chiếc AirTag giấu trong thùng sách đã phơi bày toàn bộ đường đi của một lô sách hiếm: từ một hiệu sách ở California, qua Milwaukee, Colorado Springs, rồi kết thúc tại nhà kho mã VGT3, nơi sách bị xé rời và số hóa trước khi biến mất. Câu chuyện nghe như tiểu thuyết trinh thám, nhưng nó chỉ là bề nổi của cuộc săn lùng dữ liệu huấn luyện AI. Trong khi đó, theo một phân tích hạ tầng mạng lớn, lưu lượng bot AI đã chiếm khoảng 60% yêu cầu HTML, vượt xa 38,2% lưu lượng từ con người. Đây không còn là cảnh báo kỹ thuật, mà là dấu hiệu rõ ràng cho thấy trật tự nội dung trên internet đang đảo chiều, khi máy móc trở thành người đọc và người sản xuất chính.
Model collapse: vì sao các hãng AI bị ám ảnh với mốc ‘trước 2022’
Nếu phải chọn một mốc thời gian để hiểu vì sao sách và trí tuệ nhân tạo đang va chạm, thì đó là cuối năm 2022 – thời điểm ChatGPT xuất hiện. Từ đây, dữ liệu internet bị ô nhiễm bởi văn bản máy tạo ra ở mọi ngóc ngách: bài báo tự động, nội dung SEO, bình luận mạng xã hội, thậm chí cả mã nguồn tham khảo. Khi các mô hình mới tiếp tục ăn lại chính văn bản do AI đời trước tạo ra, giới kỹ thuật gọi đó là “model collapse”: chất lượng đầu ra suy giảm qua mỗi thế hệ, giống như việc photocopy một bản photocopy cho đến khi mọi chi tiết trở nên mờ nhòe.
Trong bối cảnh đó, các công ty AI buộc phải tìm về một mốc dữ liệu được coi là nguồn dữ liệu sạch – trước khi văn bản sinh bởi máy trở thành dòng chính. Theo một phân tích về ISBN và xuất bản, sách in trước mốc này gần như chắc chắn không chứa văn bản AI, bởi lúc đó công nghệ tạo văn bản tự động chưa phổ biến. Sách còn có một ưu điểm không thể thay thế: cấu trúc lập luận dài, mạch lạc, giàu ngữ cảnh, đã qua nhiều vòng biên tập. Khác với các mẩu nội dung rời rạc trên diễn đàn, mạng xã hội hay kho mã, sách in tạo nên một trường ngôn ngữ đầy đủ – thứ mà mô hình ngôn ngữ lớn vốn thiếu khi chỉ ăn “fast-food” dữ liệu trên internet. Ở đây, các hãng AI không tìm cảm hứng văn chương; họ tìm độ sâu của hệ thống khái niệm mà chỉ văn bản dài mới mang lại.
Project Panama và các đơn hàng triệu cuốn: khi sách in trở thành mỏ dữ liệu huấn luyện AI
Đằng sau các kho sách vô danh là những kế hoạch dữ liệu huấn luyện AI có quy mô gây choáng. Một tài liệu nội bộ cho thấy một hãng phát triển mô hình Claude từng âm thầm vận hành dự án “Project Panama” với mục tiêu quét và tiêu hủy gần như toàn bộ sách in trên thế giới để khai thác dữ liệu huấn luyện AI. Các đơn đặt hàng ẩn danh mà giới buôn sách cũ nhận được dao động từ 1.000 đến 1.000.000 cuốn mỗi lần; riêng kế hoạch của hãng này là quét hủy từ 500.000 đến 2.000.000 cuốn sách chỉ trong một hợp đồng sáu tháng với một nhà cung cấp. Đến tháng 10/2024, số sách họ đã mua được ghi nhận là “hàng triệu cuốn”, dù con số cụ thể bị che.
Từ góc nhìn công nghệ, đây là một phản ứng hợp lý: sách trước 2022 cung cấp kho lưu trữ ngôn ngữ con người chưa bị máy móc đụng tới, lại được biên tập và phân loại rõ ràng. Nhưng cách làm cho thấy một sự chuyển dịch khó chấp nhận trong cách ngành AI định giá và đối xử với dữ liệu: sách bị biến thành vật liệu thô, xé rời, quét và vứt bỏ, như thể giá trị của chúng chỉ nằm ở việc nuôi bộ máy thuật toán. Trong khi người dùng đang được hứa hẹn những trợ lý thông minh hơn, tác giả và nhà xuất bản thấy tác phẩm của mình bị trộn vào “cháo dữ liệu” khổng lồ mà chẳng có quyền kiểm soát hay thương lượng. Sách và trí tuệ nhân tạo vì thế không còn là mối quan hệ cộng sinh, mà trở thành chuỗi khai thác một chiều.
Khi bot vượt con người: AI đang làm lộ điểm yếu chí tử của mô hình kinh tế internet
Trong hơn hai thập kỷ, nền kinh tế internet dựa trên một giao dịch đơn giản: nội dung đổi lấy lưu lượng. Nhà xuất bản cung cấp bài viết, video, mã nguồn; công cụ tìm kiếm gửi độc giả tới; quảng cáo trả tiền cho mỗi lượt truy cập. Nhưng khi lưu lượng máy móc vượt qua lưu lượng con người, giao dịch này mất ý nghĩa. Dữ liệu mới từ một mạng phân phối nội dung lớn cho thấy bot chiếm khoảng 60% yêu cầu HTML, trong khi con người chỉ chiếm 38,2%. Đây là một câu nói đáng trích: "Khi tỷ lệ yêu cầu các trang HTML do hệ thống tự động tạo ra vượt quá con người, các mô hình kinh doanh mà internet dựa vào để tồn tại đang sụp đổ".
Không chỉ ở giai đoạn dữ liệu huấn luyện AI, nơi mô hình cào sách, bài báo, mã nguồn và tác phẩm nghệ thuật để học rồi phản hồi mà không dẫn nguồn hay trả phí; ở giai đoạn tìm kiếm thời gian thực, chatbot AI giữ người dùng bên trong giao diện hội thoại, tóm tắt và trả lời thay cho trang gốc. Một nghiên cứu cho thấy khi tóm tắt AI xuất hiện trong trang kết quả, tỷ lệ nhấp của con người giảm từ 15% xuống 8%, và 26% phiên duyệt web bị bỏ hẳn. Các nhà xuất bản mất mối quan hệ trực tiếp với độc giả, lượng truy cập từ người thật giảm. Vòng tròn nội dung – lưu lượng – quảng cáo bị đứt gãy, trong khi hạ tầng “trả theo yêu cầu” cho nội dung số vẫn chưa kịp hình thành. Người sáng tạo bị kẹt giữa hai hệ thống: một hệ thống cũ đang chết, và một hệ thống mới chưa biết sẽ bù đắp thiệt hại như thế nào.

Quyền tác giả AI, nguồn dữ liệu sạch và câu hỏi đạo đức mà sách in buộc chúng ta phải trả lời
Khi sách in trở thành nguồn dữ liệu sạch cho AI, câu chuyện không còn dừng ở kỹ thuật mà chuyển hẳn sang đạo đức và pháp lý. Một vụ kiện liên bang liên quan đến một hãng AI đã dẫn đến phán quyết rằng việc dùng sách được mua hợp pháp để huấn luyện thuộc phạm vi “sử dụng hợp lý”, vì nó được coi là mang tính chuyển đổi, không thay thế cuốn sách gốc. Nhưng phần khó hơn chính là thư viện sách lậu được tải xuống, hiện đã bước vào giai đoạn xét xử. Một vụ kiện khác buộc một hãng chatbot lớn phải bàn giao 20 triệu nhật ký hội thoại để xem mô hình sao chép bài báo đến mức nào nhằm thay thế đăng ký trả phí. Những con số này cho thấy luật hiện hành đang phải cúi xuống xem xét kỹ từng dòng dữ liệu huấn luyện AI, thay vì chỉ nhìn vào sản phẩm cuối cùng.
Trong khi đó, các mô hình hình ảnh có thể tái hiện phong cách Ghibli, đặt ra câu hỏi nhức nhối về khả năng “bắt chước” phong cách sáng tạo mà không cần xin phép. Ngay cả khi một hạ tầng “trả theo yêu cầu” mới nổi lên có thể đo lường và trả công cho việc truy cập tác phẩm trong tương lai, nó không thể truy ngược để bù đắp cho kho tư liệu đã được dùng để huấn luyện, cũng không ngăn mô hình tái hiện phong cách đã học. Điều đó khiến nguồn dữ liệu sạch như sách trước 2022 trở nên mâu thuẫn: càng sạch, càng có giá với hãng AI, nhưng càng làm lộ rõ việc tác giả bị đặt ra ngoài cuộc chơi thương lượng. Nếu sách và trí tuệ nhân tạo phải tiếp tục sống chung, chúng ta cần một nguyên tắc đơn giản nhưng mạnh mẽ: không có dữ liệu huấn luyện AI nào là “miễn phí đạo đức”. Các hãng công nghệ phải học cách coi dữ liệu như một mối quan hệ cần được thỏa thuận, chứ không phải một mỏ tài nguyên để khai thác đến cạn kiệt.