
Từ internet ô nhiễm dữ liệu đến cơn khát sách in trước 2022
Cuộc chiến dữ liệu huấn luyện AI là cuộc cạnh tranh giành những nguồn văn bản đủ sạch, đủ sâu và đủ an toàn pháp lý để nuôi các mô hình ngôn ngữ khổng lồ trong bối cảnh internet tràn ngập nội dung do máy tạo ra, gây suy thoái chất lượng và thách thức toàn bộ nền kinh tế nội dung số. Internet hiện nay đã bị ô nhiễm dữ liệu internet ở mức đáng báo động: văn bản do máy tạo ra xuất hiện từ bài báo tự động đến bình luận mạng xã hội. Khi mô hình tiếp tục học lặp đi lặp lại trên văn bản do AI khác sinh ra, giới kỹ thuật gọi đó là “model collapse” – giống như photocopy một bản photocopy nhiều lần. Trong bối cảnh đó, các hãng AI bắt buộc phải quay lưng với dữ liệu web mới, săn lùng những kho văn bản “trước thời AI” để tránh trượt xuống vòng xoáy tự ăn chính mình.
Những đường dây bí mật cắt sách nuôi AI và lý do phải là sách trước 2022
Một chiếc AirTag giấu trong thùng sách từ một hiệu sách hiếm ở California đã bất ngờ vạch trần cả một đường dây bí mật: lô sách đi qua Milwaukee, Colorado Springs rồi dừng ở kho VGT3 tại Las Vegas, nơi sách bị xé gáy, quét thành dữ liệu số rồi biến mất vĩnh viễn. Tài liệu nội bộ cho thấy một hãng đứng sau mô hình Claude từng vận hành Project Panama với mục tiêu quét và tiêu hủy gần như toàn bộ sách in trên thế giới để lấy dữ liệu huấn luyện AI. Lý do ám ảnh sách cũ rất rõ: sách in trước mốc phát hành ChatGPT cuối năm 2022 gần như chắc chắn không chứa văn bản AI, vì công nghệ tạo văn bản tự động chưa xuất hiện thời điểm đó. Đồng thời, sách mang cấu trúc lập luận dài, mạch lạc, đã qua biên tập kỹ, vượt xa các mẩu nội dung ngắn trên Reddit, Stack Overflow hay GitHub. Đây không chỉ là kho dữ liệu huấn luyện AI chất lượng, mà còn là “bản ghi” ngôn ngữ con người chưa bị máy móc chạm vào.
Bản quyền nội dung số: sách an toàn hơn nhưng không phải vùng trắng pháp lý
Các công ty AI không quay về sách chỉ vì chất lượng; họ tìm một vị trí phòng thủ tốt hơn trong cuộc chiến bản quyền nội dung số. Một phán quyết liên bang đã khẳng định rằng việc chuyển đổi một cuốn sách in đã mua hợp pháp sang định dạng số để huấn luyện AI nội bộ là “sử dụng hợp lý mang tính chuyển đổi”. Câu chữ đó mở cánh cửa pháp lý cho việc săn lùng sách cũ, vì nó xem việc huấn luyện là tạo ra thứ mới chứ không thay thế cuốn sách gốc. Tuy vậy, đây không phải vùng trắng pháp lý: cùng lúc, một vụ kiện nổi bật buộc một nền tảng AI phải bàn giao 20 triệu nhật ký hội thoại chatbot để điều tra xem mô hình đã sao chép bài viết tới mức nào nhằm thay thế đăng ký trả phí. Nói cách khác, sách in được ưu ái vì nằm trong vùng “sử dụng hợp lý” rõ ràng hơn, còn nội dung báo chí, tác phẩm nghệ thuật số và kho thư viện trực tuyến vẫn là bãi mìn pháp lý mà AI phải bước từng bước thận trọng.
Khi lưu lượng máy vượt người: nền kinh tế nội dung internet bị lật bàn
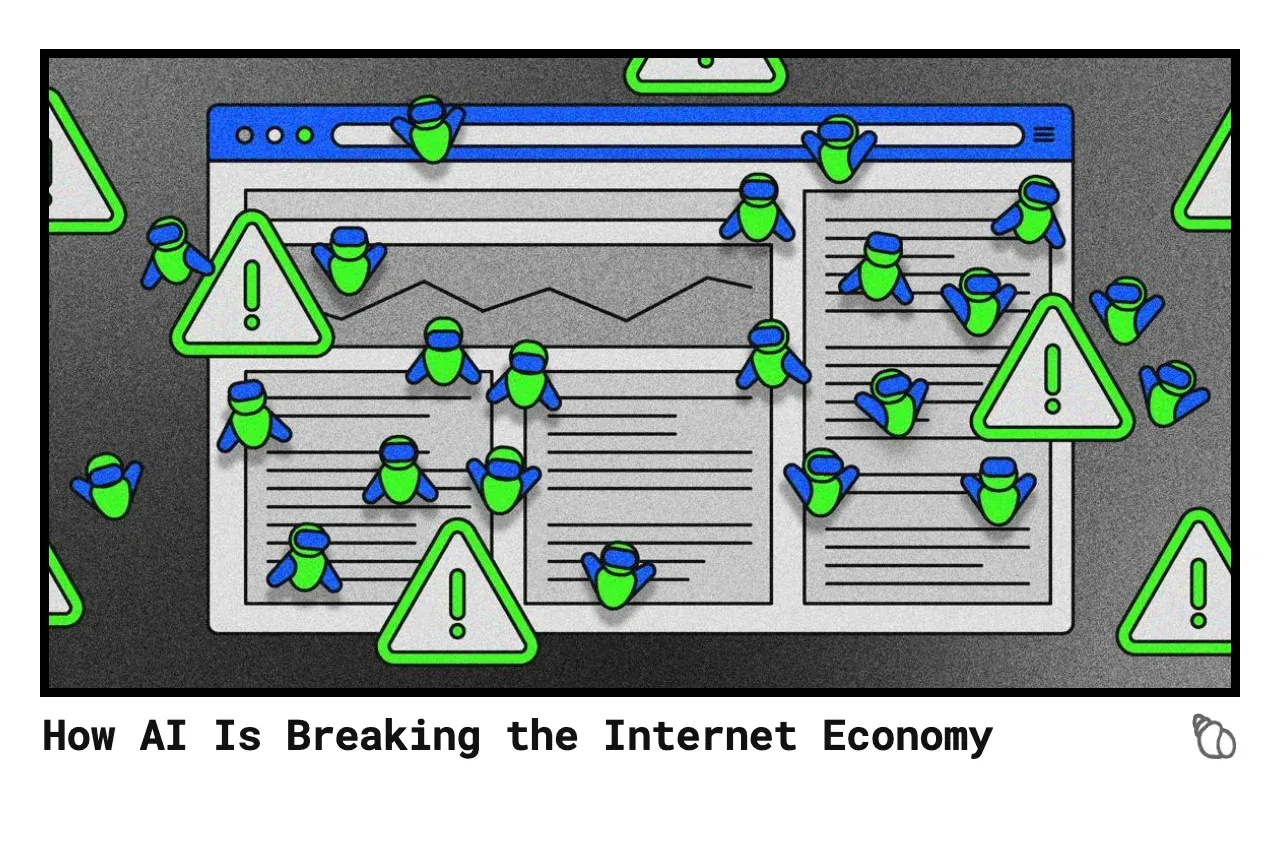
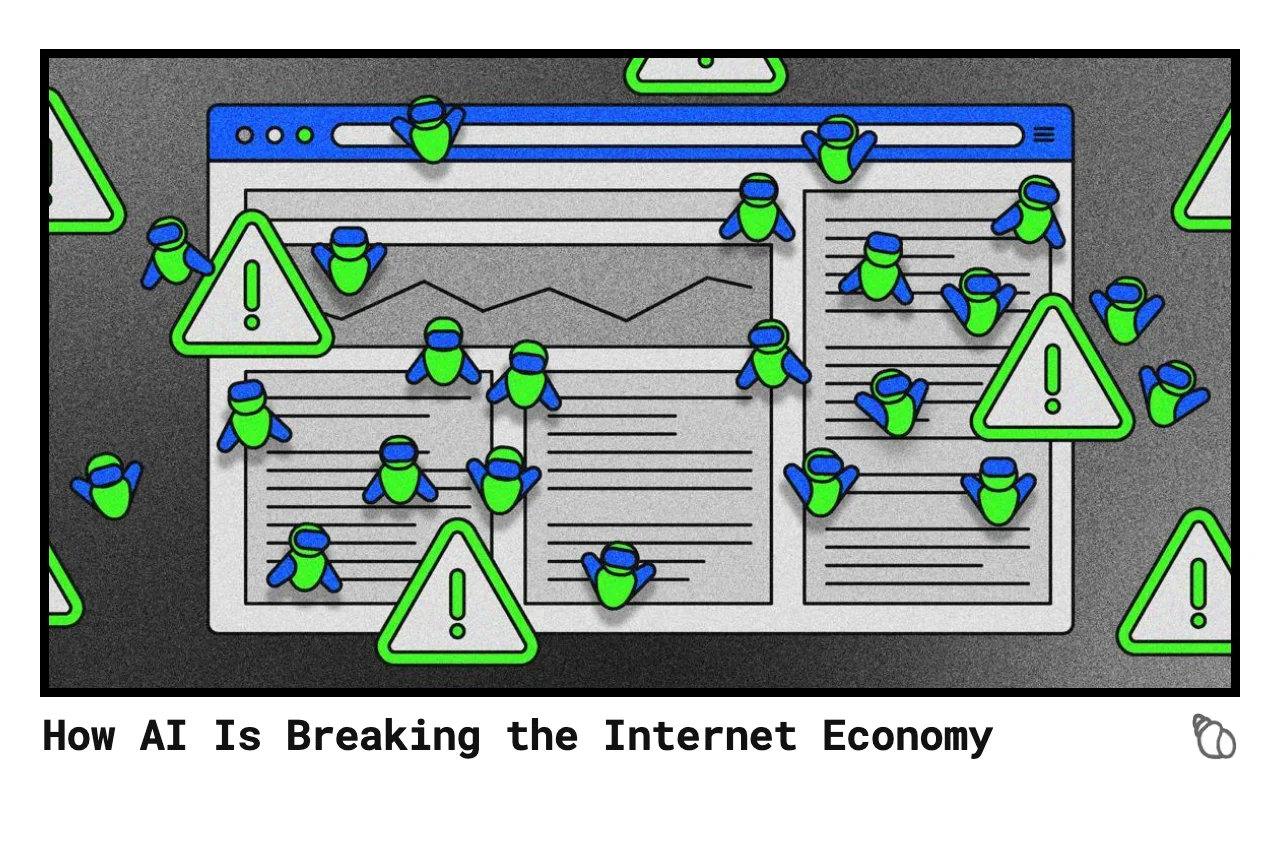
Trong khi các hãng AI đào bới thư viện sách để nuôi mô hình, trên mặt tiền internet, một cuộc đảo lộn kinh tế nội dung đang diễn ra. Một mạng phân phối nội dung lớn cho biết lưu lượng bot đã chiếm khoảng 60% yêu cầu HTML, con người chỉ còn 38,2%, nghĩa là lưu lượng máy móc đã vượt người. Mô hình “nội dung đổi lưu lượng” – nhà xuất bản đưa bài lên, trình tìm kiếm mang độc giả đến, nhà quảng cáo trả tiền cho mỗi lượt truy cập – chính là thứ đã nuôi sống internet mở không tường phí suốt hai thập kỷ. Các ứng dụng chatbot AI phá vỡ giao dịch đó: chúng giữ khán giả trong giao diện trò chuyện, tóm tắt thông tin và trả lời trực tiếp, không gửi người đọc quay lại trang nguồn. Một nghiên cứu đã chỉ ra rằng khi tóm tắt AI chặn truy vấn tìm kiếm, tỷ lệ nhấp của con người giảm từ 15% xuống 8% và 26% người dùng bỏ hẳn phiên duyệt web. Theo nghĩa kinh tế nội dung, AI đang ăn mòn chính dòng máu lưu lượng từng nuôi sống các nhà xuất bản.
Tương lai song song: kho sách kín cho AI, internet trả theo yêu cầu cho con người?
Điều trớ trêu là trong khi máy móc ngày càng đọc sách nhiều hơn, con người lại bị đẩy ra khỏi những nội dung mà họ tạo ra. Ứng dụng AI tạo sinh đã biến bot crawler từ công cụ lập chỉ mục thành người tiêu dùng chủ động, làm tan vỡ giao dịch nội dung đổi lưu lượng ở cả giai đoạn huấn luyện lẫn tìm kiếm thời gian thực. Nhà xuất bản cho phép bot cào dữ liệu mà gần như không nhận lại độc giả, bởi mỗi nền tảng AI có thể phân phối nội dung đã cào cho hàng triệu người dùng mà không hề chuyển hướng họ về nguồn. Hai phản ứng chính hiện nay – kiện tụng và các hợp đồng ủy quyền nội dung riêng – vẫn chỉ là biện pháp tạm thời, không phải mô hình có thể mở rộng. Một giải pháp đang nổi lên là hạ tầng thanh toán “trả theo yêu cầu” mới cho nội dung và tìm kiếm trên internet. Nếu xu hướng này tiếp tục, chúng ta có thể bước vào một tương lai song song: AI sống trong kho sách kín, còn con người duyệt web trong một nền kinh tế nội dung trả tiền từng lượt, nơi bản quyền không còn là dòng chữ nhỏ mà là trụ cột của toàn bộ hạ tầng.