
Rosalind dành cho sinh học, không phải mọi câu hỏi về sức khỏe
GPT-Rosalind là mô hình AI sinh học chuyên biệt của OpenAI, được thiết kế để hỗ trợ suy luận về hóa học, genomics và quy trình phòng thí nghiệm thay vì thay thế một mô hình tổng quát trong mọi tác vụ khoa học. Nó ra mắt ngày 16 tháng 4 năm 2026, nhưng chỉ được bán rộng rãi từ ngày 5 tháng 10. Điểm quan trọng khi đặt cạnh GPT-6.1 Sol, Grok 4.7 và Qwen 4 Max không phải là tìm một nhà vô địch chung cuộc; đó là xác định công việc nào cần chuyên môn sinh học, công việc nào cần quyền truy cập dễ dàng, và liệu quy trình thực tế có thể tận dụng hàng loạt tác nhân hay không. Rosalind đòi hỏi đánh giá truy cập tin cậy và xác minh tổ chức, trong khi GPT-6.1 Sol chỉ cần tài khoản thanh toán. Sự kiểm soát này vừa là rào cản, vừa là dấu hiệu cho thấy năng lực chuyên môn của Rosalind được xem là nhạy cảm.
| Mô hình | Trọng tâm hoặc tình trạng | Truy cập và ngữ cảnh |
|---|---|---|
| GPT-Rosalind | Hóa học, genomics, suy luận phòng thí nghiệm ướt | Cần phê duyệt; ngữ cảnh 1 triệu token |
| GPT-6.1 Sol | Mô hình tổng quát | Tài khoản thanh toán; cùng bề mặt API |
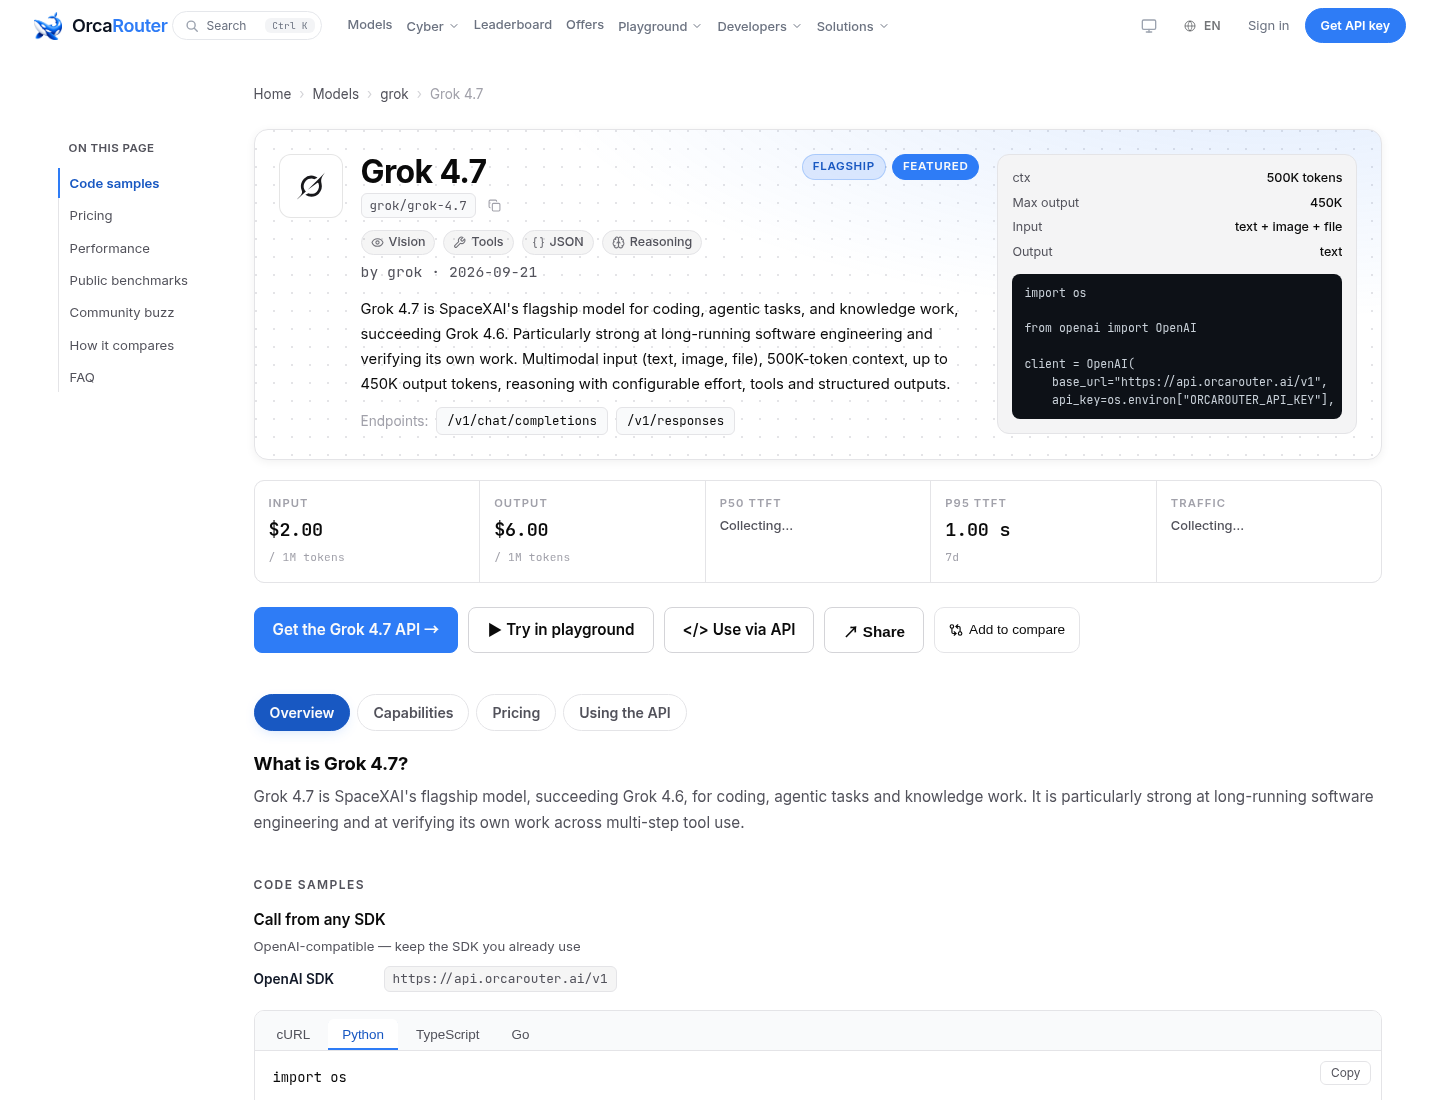
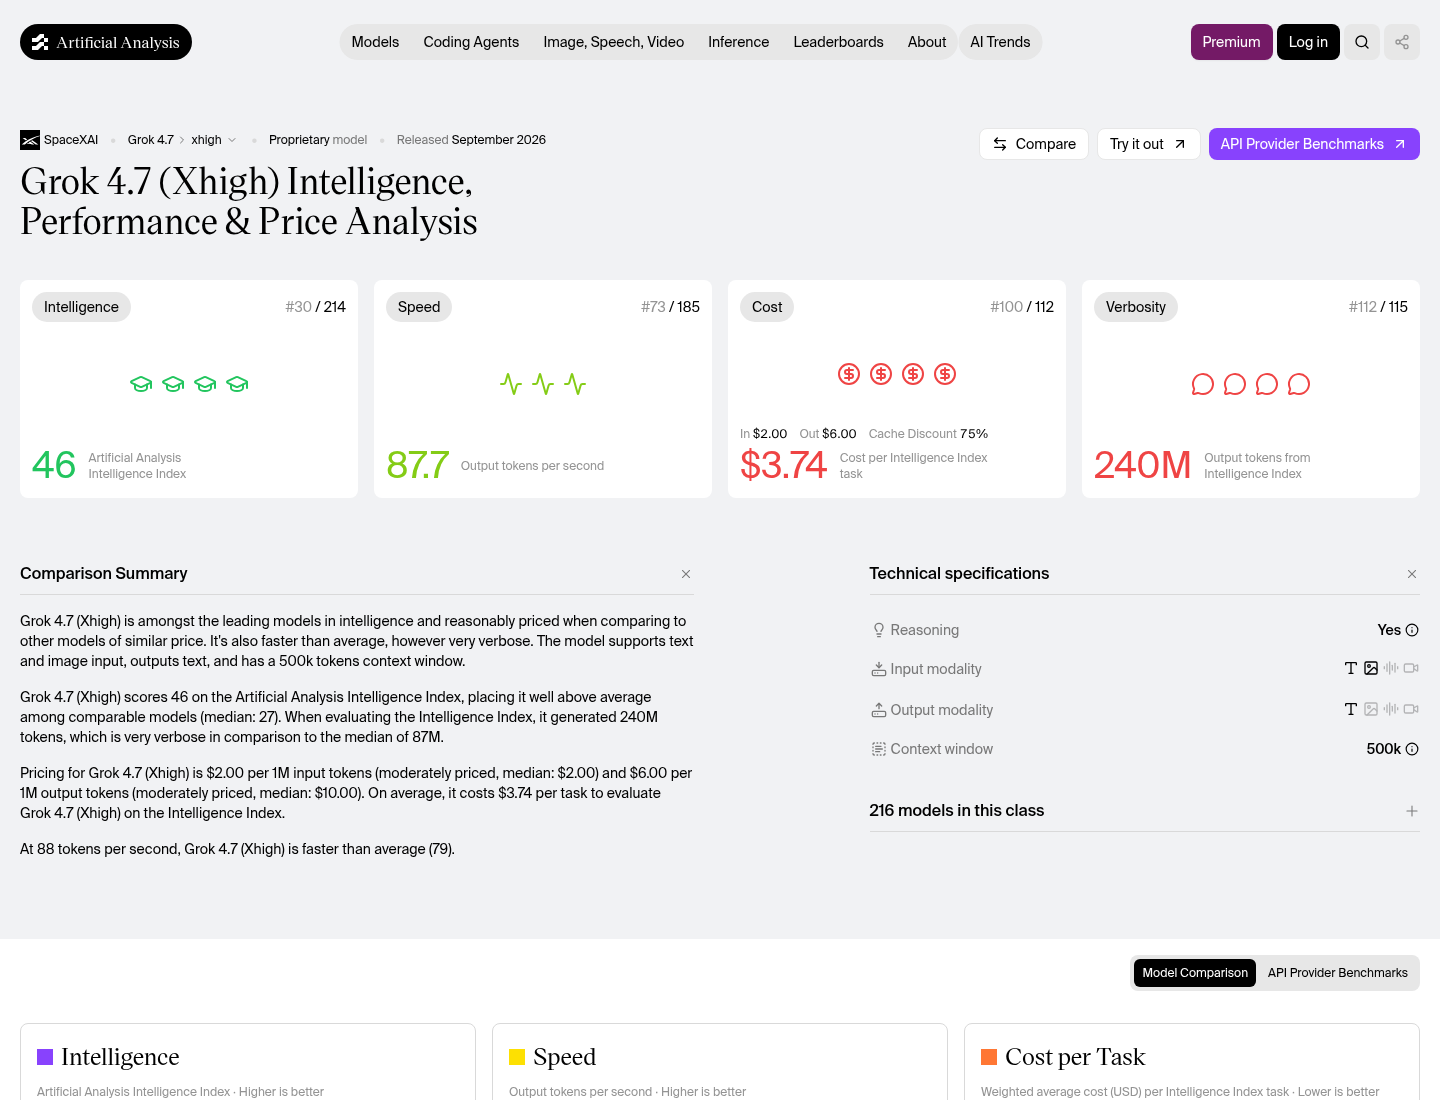
| Grok 4.7 | Kiến thức và phán đoán lâm sàng | Ngữ cảnh 500.000 token |
| Qwen 4 Max | Chưa có thông số công khai để so sánh đầy đủ | Ngữ cảnh chưa được công bố |
Điểm lâm sàng không chứng minh năng lực wet-lab
So Grok 4.7 với Rosalind bằng một điểm sức khỏe duy nhất là so nhầm hai bài thi. Grok đạt 56,7% trên HealthBench Professional, bộ kiểm tra kiến thức và phán đoán theo kiểu câu hỏi bác sĩ lâm sàng gặp phải; bài thi đánh giá khả năng ghi nhớ, hiệu chuẩn và giữ đúng khung lâm sàng. Nó không đo khả năng thiết kế thí nghiệm nhiễu loạn, đọc quy trình phòng thí nghiệm ướt hay lý luận về quan hệ cấu trúc–hoạt tính. Rosalind được đánh giá bằng các bài kiểm tra khác: MedChemBench về hiệu lực, ADME và tổng hợp ngược; GeneBench về genomics tầm xa; LabWorkBench về liên hệ giữa nhiễu loạn và kết quả trong quy trình thực tế. Các kết quả được công bố gồm 27,5% trên MedChemBench và 63,2% trên LabWorkBench, nhưng không thể đặt trực tiếp cạnh điểm Grok. Cũng chưa có tái lập độc lập cho những benchmark được nêu, nên chúng là tín hiệu định hướng, không phải giấy chứng nhận độ tin cậy.
Vì thế, Grok có lợi thế rõ hơn nếu câu hỏi thuộc sức khỏe lâm sàng; Rosalind đáng cân nhắc hơn khi công việc đòi hỏi suy luận hóa học hoặc gắn dữ liệu nhiễu loạn với kết quả wet-lab. Nhưng không điểm nào trong các bài kiểm tra này cho biết một mô hình có thể được tin cậy để tạo ra kết quả đưa vào hồ sơ nộp hay không. Muốn quyết định, phòng thí nghiệm phải kiểm tra kiểu lỗi trên dữ liệu và quy trình của chính mình, thay vì xem điểm tổng hợp như bảo đảm chất lượng.
Giá token không kể hết chi phí của một đội tác nhân
Đối với AI nghiên cứu sinh học, câu hỏi kinh tế quan trọng đôi khi không phải một triệu token giá bao nhiêu, mà là cần gọi mô hình bao nhiêu lần để hoàn tất cả quy trình. Trong thử nghiệm atlas CRISPR toàn não chuột được công bố ngày 21 tháng 10, hàng nghìn tác nhân dùng Rosalind để phân tích từng đột biến, tìm tài liệu và viết báo cáo; toàn bộ lượt chạy mất 32 phút và tạo hơn 700 tài liệu tham khảo. Khi giao dữ liệu cho một tác nhân duy nhất, độ phủ tài liệu ở khối lượng lớn nhất chỉ còn 11 tài liệu tham khảo, còn các chuyên gia đánh giá mù chọn báo cáo phân tán trong 75% trường hợp. Đây là bằng chứng cho giá trị của việc chia nhỏ công việc, chứ không phải bằng chứng rằng một mô hình đơn lẻ luôn vượt trội. Mỗi tác nhân bổ sung lại nhân số lượt gọi; vì vậy chi phí tác nhân AI gắn với số lần chạy, khả năng dùng chung phần đầu vào và quyền truy cập, chứ không chỉ đơn giá token.
Qwen 4 Max chưa có giá hay cửa sổ ngữ cảnh được công bố, nên không thể xem nó là đối thủ đã được kiểm chứng về chi phí hoặc hiệu năng. Qwen3.8-Max là lựa chọn có thể thuê qua API thương mại mở, nhưng thông số của phiên bản đó không thể tự động gán cho Qwen 4 Max. Rosalind có ngữ cảnh một triệu token; Qwen 4 Max chưa công bố cửa sổ của mình. Báo cáo thử nghiệm cho thấy kiến trúc phân tán có thể cải thiện độ phủ, nhưng phép tính chi phí phụ thuộc vào phần prompt được chia sẻ giữa các tác nhân. Do đó, hãy ước lượng tổng số lượt gọi của tác vụ thật và điều kiện truy cập trước khi kết luận mô hình nào rẻ hơn.
Chọn theo công việc, rồi kiểm chứng trước khi mở rộng
Cách chọn hợp lý bắt đầu từ đầu ra cần có. Với câu hỏi lâm sàng, Grok 4.7 có benchmark phù hợp hơn để tham khảo; với hóa học, genomics và quy trình wet-lab, Rosalind có bộ kiểm tra chuyên biệt hơn. Nếu ưu tiên mô hình tổng quát và quy trình truy cập ít rào cản, GPT-6.1 Sol dễ bắt đầu hơn Rosalind. Còn Qwen 4 Max hiện chưa đủ thông tin công khai để so sánh ngang hàng. Những lựa chọn này không thể rút gọn thành một bảng xếp hạng: benchmark do chính nhà cung cấp báo cáo, chưa được tái lập độc lập, và phép thử của Grok không đo cùng năng lực với phép thử của Rosalind.
- Xác định tác vụ: hỗ trợ lâm sàng, suy luận hóa học, phân tích genomics hay tổng hợp báo cáo từ dữ liệu wet-lab.
- Kiểm tra điều kiện truy cập, khả năng kết nối công cụ và số lượt gọi mà quy trình dự kiến cần.
- Thử nghiệm trên bộ dữ liệu nội bộ, đánh giá lỗi và kiểm chứng trích dẫn trước khi dùng kết quả trong quyết định nghiên cứu.
Kết luận: Rosalind có lý do để đứng riêng khi chuyên môn sinh học và xử lý theo đội tác nhân là phần cốt lõi của công việc, nhưng quyền truy cập hạn chế và chi phí của nhiều lượt gọi có thể làm giảm lợi thế. Đừng chọn theo điểm benchmark cao nhất hay giá niêm yết riêng lẻ; hãy chọn mô hình đáp ứng đúng quy trình, rồi đo tổng chi phí và độ tin cậy trên chính tác vụ của mình.