
DeepSeek V4.1 Flash là gì và vì sao nó đáng chú ý?
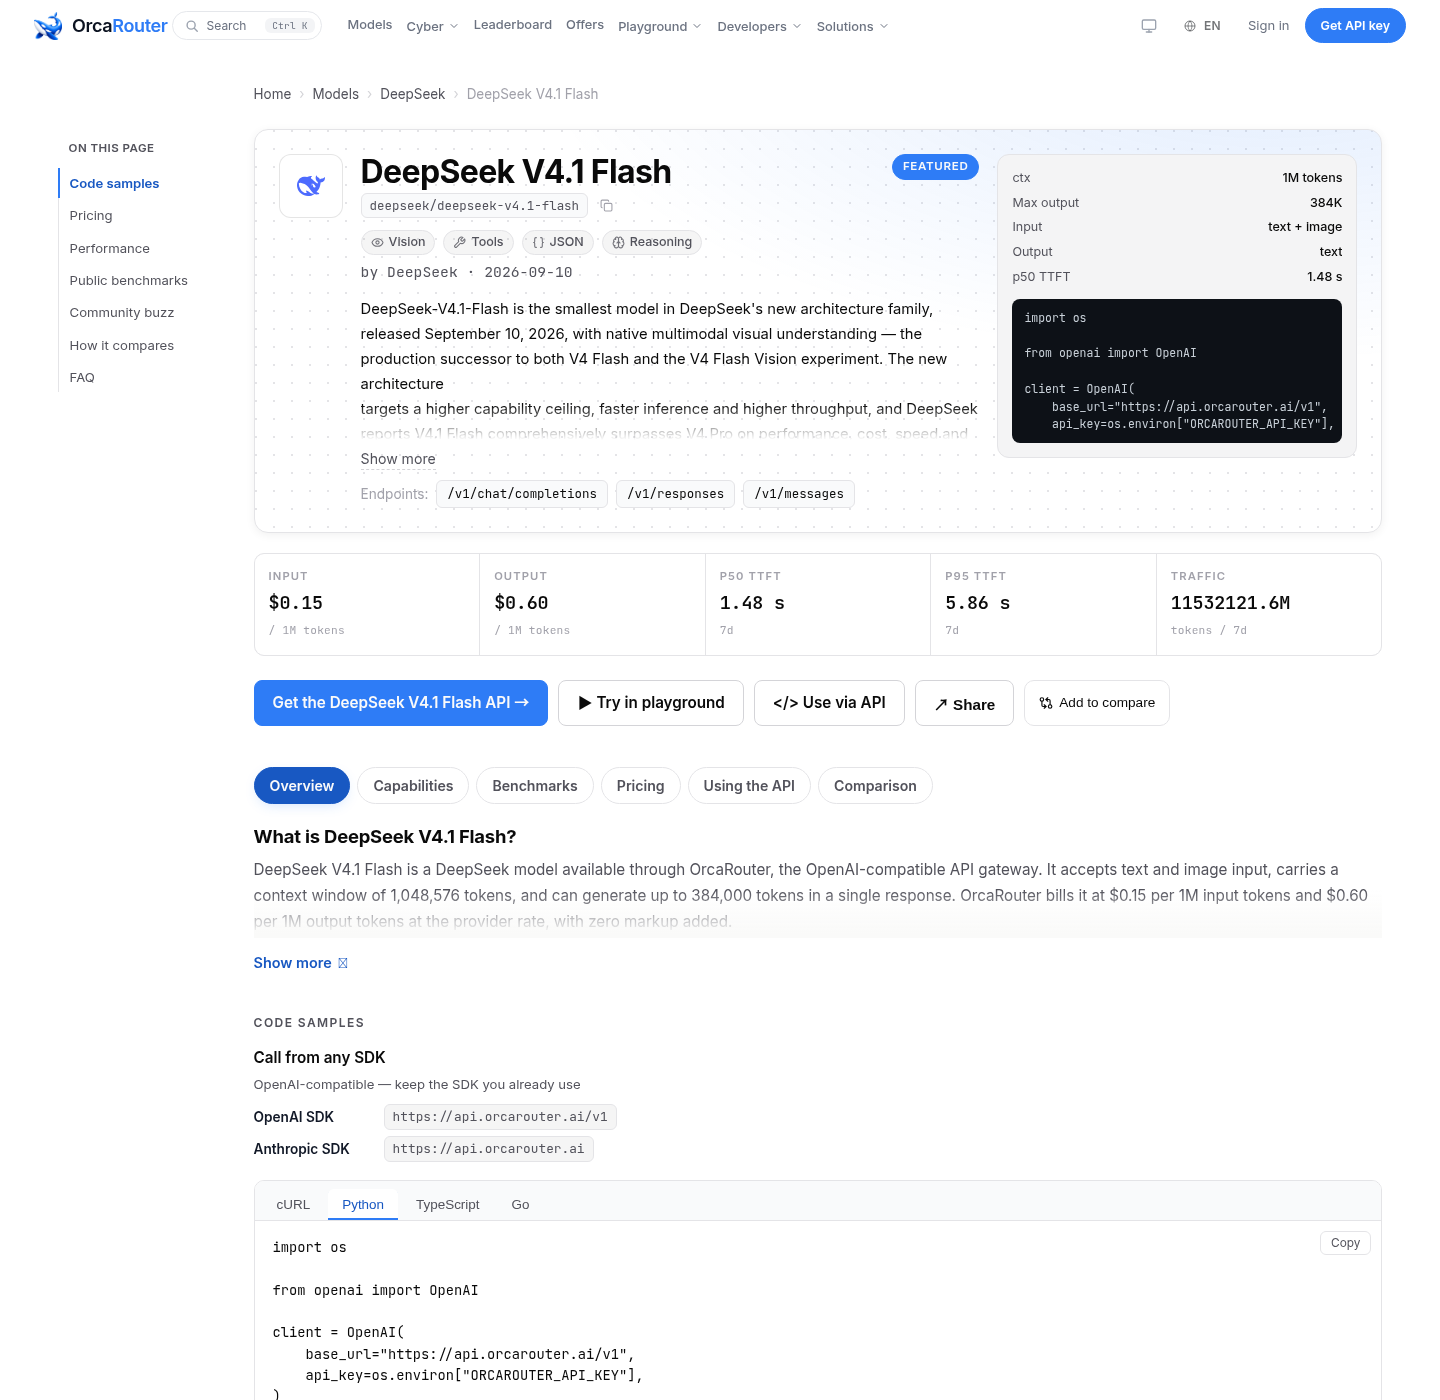
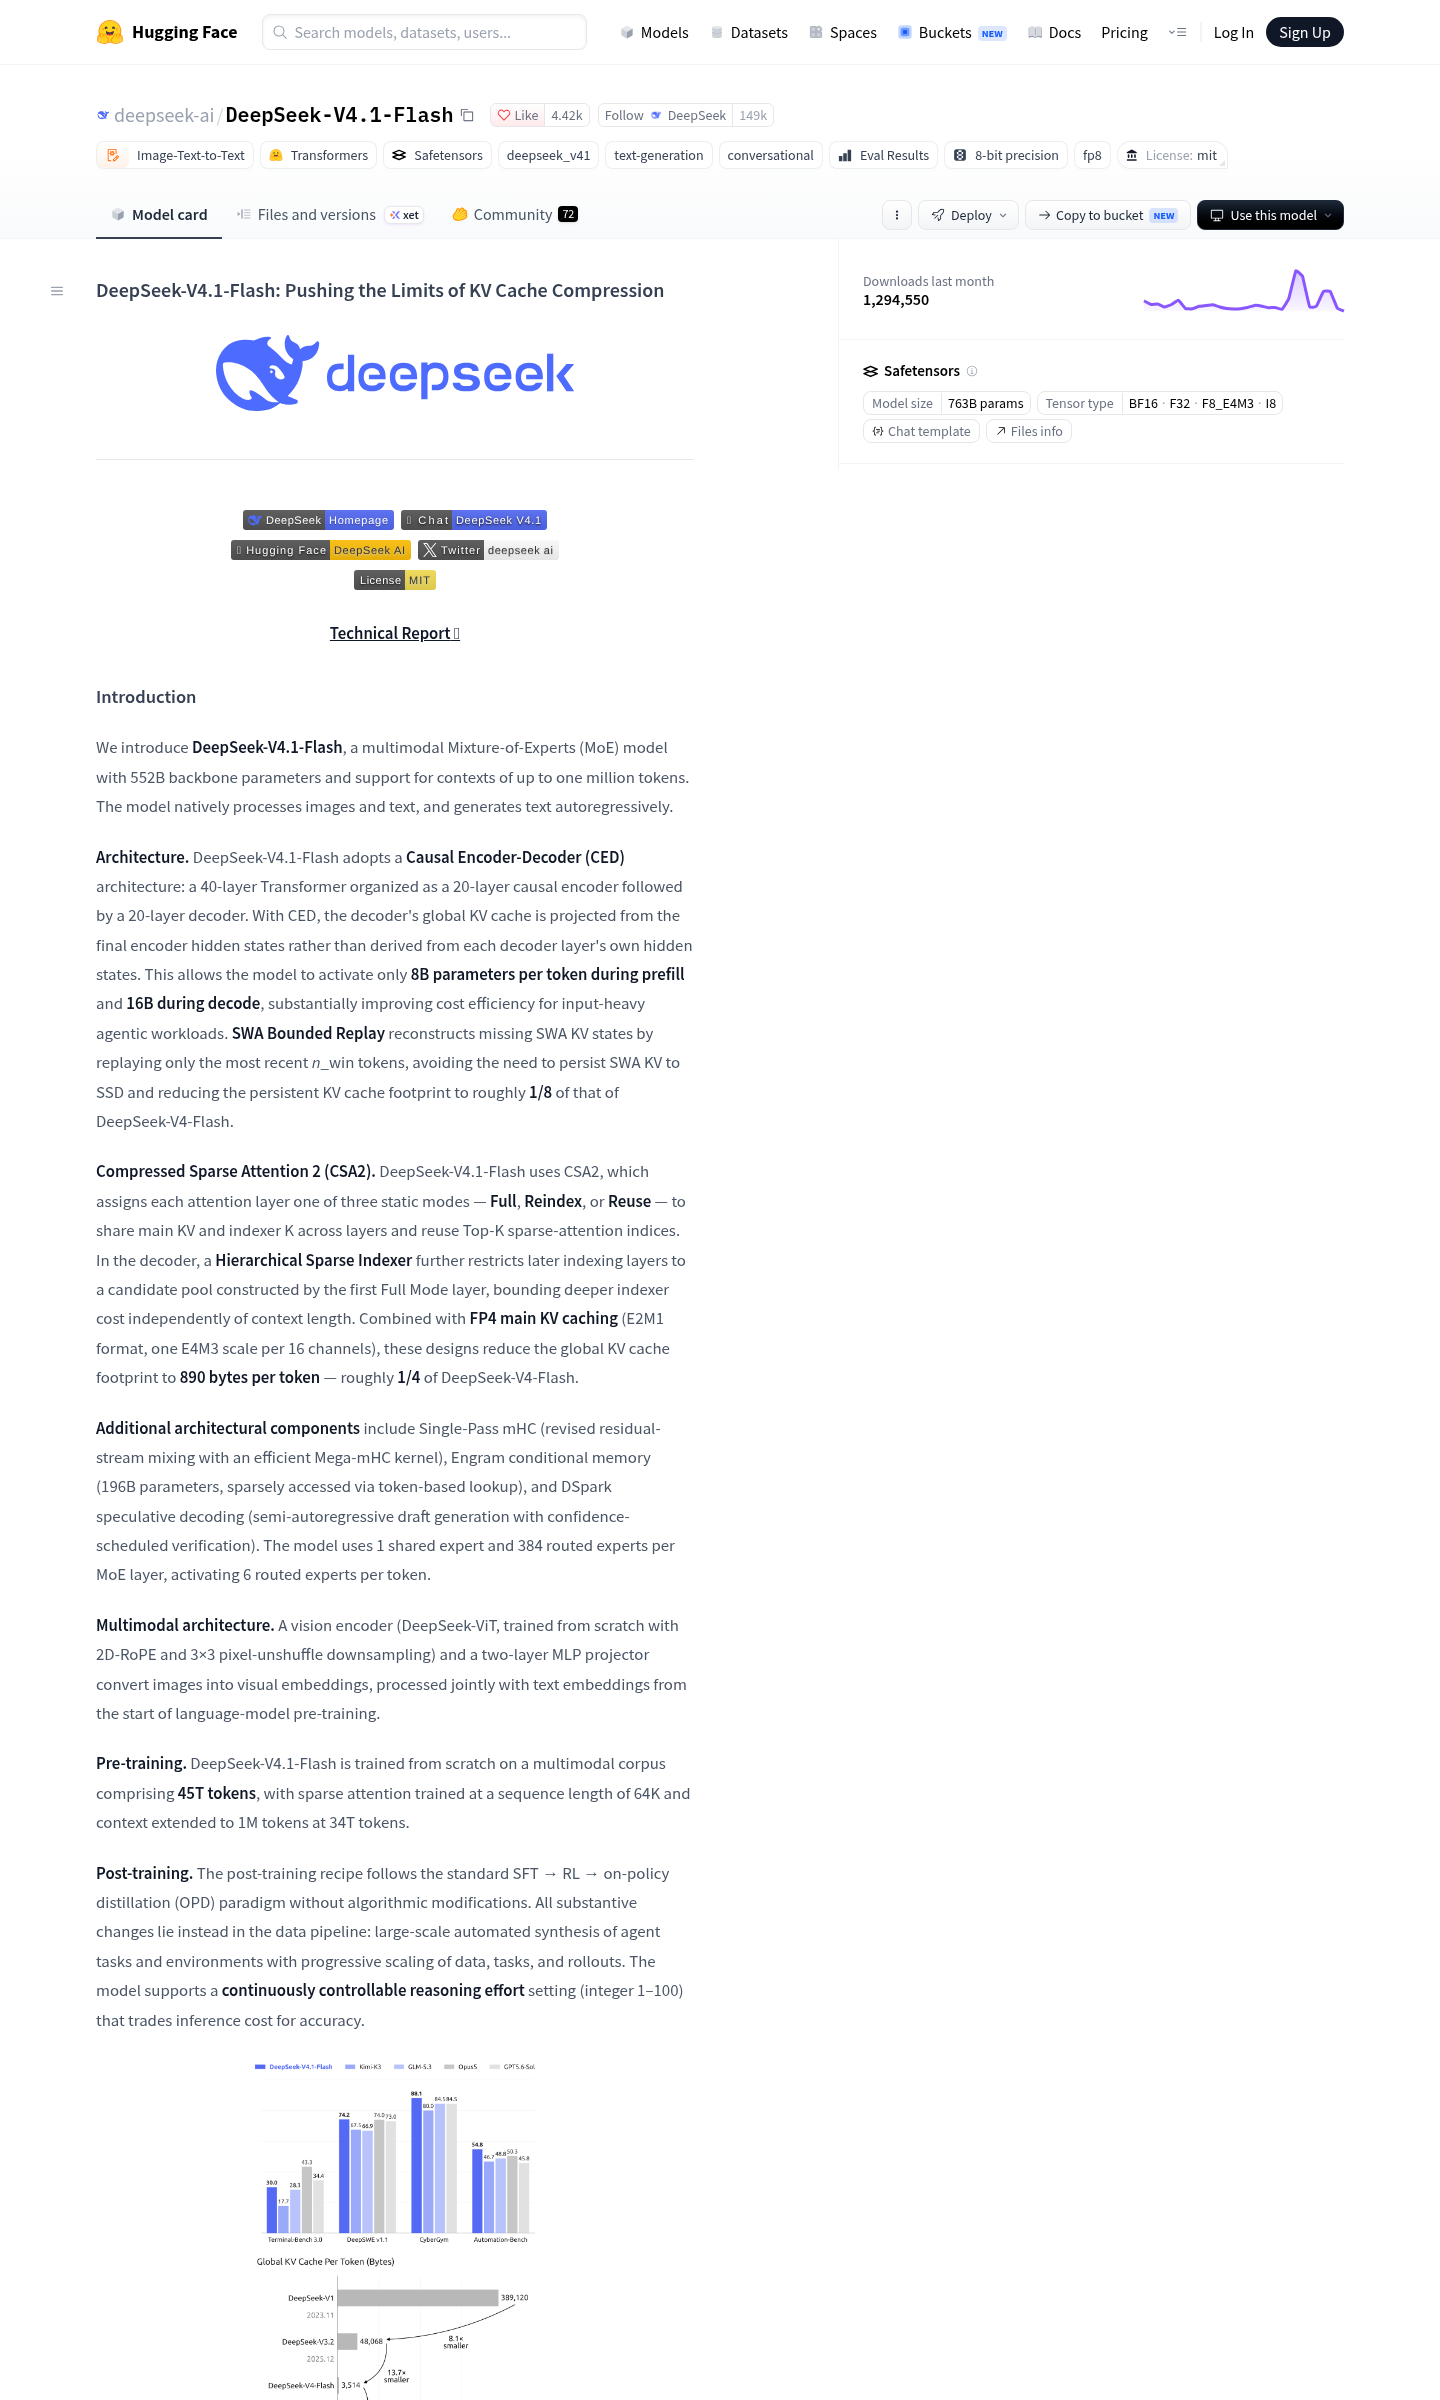
DeepSeek V4.1 Flash là một mô hình AI đa phương thức thuộc kiến trúc mixture-of-experts, hỗ trợ cửa sổ ngữ cảnh 1.048.576 token, đầu vào văn bản và hình ảnh, trọng số được cấp phép theo MIT và cung cấp qua API tương thích OpenAI/Anthropic, được thiết kế ưu tiên tốc độ, chi phí thấp và khả năng xử lý tài liệu rất dài cho cả nhà phát triển lẫn doanh nghiệp. Điểm mấu chốt: đây là một mô hình AI giá rẻ nhưng không “rẻ tiền”. DeepSeek định vị V4.1 Flash là tầng nhanh trong dòng V4.1, tối ưu cho thông lượng và chi phí thay vì chạy đua ngôi vương benchmark tuyệt đối. Trong bối cảnh nhiều doanh nghiệp đang đau đầu với hóa đơn API AI, một mô hình ngôn ngữ mở có trọng số MIT và khả năng tự lưu trữ là một lời thách thức trực diện với các nền tảng đóng. Quan trọng hơn, V4.1 Flash không chỉ là bản nâng cấp nhẹ. DeepSeek đã phát hành rộng rãi mô hình này vào ngày 10-09-2026, sau đó tiếp tục công bố phiên bản trọng số mới DeepSeek-V4.1-Flash-1017 với giấy phép MIT cho thương mại, cho thấy chiến lược dài hơi với dòng Flash.
Ngữ cảnh 1.048.576 token: lợi thế thực tế hay chỉ là con số đẹp?
Cửa sổ ngữ cảnh 1.048.576 token của DeepSeek V4.1 Flash không chỉ là một con số để khoe trên model card; nó mở ra những kiểu ứng dụng mà nhiều mô hình cạnh tranh vẫn còn chật vật. Với khả năng đầu ra tối đa 384K token trên API, V4.1 Flash có thể xử lý cả kho mã, tài liệu pháp lý, tài liệu kỹ thuật nhiều trăm trang trong một lần gọi, thay vì phải chia nhỏ rồi ghép lại bằng logic ứng dụng dễ lỗi. Trong thực tế, điều này nghĩa là bạn có thể nhúng toàn bộ codebase hoặc corpus nội bộ vào lời nhắc hệ thống, để agent coding hoặc trợ lý doanh nghiệp làm việc trên bối cảnh đầy đủ, không phải phiên bản rút gọn. Theo mô tả, bất kỳ khối lượng công việc nào có tiền tố lớn, ổn định như hướng dẫn hệ thống, lược đồ công cụ hay bản đồ kho mã gần như không tốn gì cho phần lặp lại của lời nhắc nhờ cơ chế cache, trong khi chi phí nằm ở token mới. Từ góc nhìn sản phẩm, đây là một thay đổi chất lượng: thay vì phải thiết kế quanh giới hạn ngữ cảnh, bạn có thể thiết kế tính năng dựa trên dữ liệu thực tế mà mô hình nhìn thấy đầy đủ.
Giá rẻ, API AI chi phí thấp và trọng số MIT: cuộc chơi mở cho doanh nghiệp
DeepSeek V4.1 Flash được định vị rõ ràng là mô hình AI giá rẻ: mức giá niêm yết ngoài giờ cao điểm cho mỗi triệu token đầu vào và đầu ra thấp hơn đáng kể so với nhiều đối thủ, cùng cơ chế cache giúp token đầu vào trúng bộ đệm chỉ tốn bằng một phần năm mươi so với token mới. Một câu trích đáng nhớ là: “Một token đầu vào trúng bộ đệm chỉ tốn 0,003 đô-la cho mỗi triệu token, so với 0,15 đô-la cho một token đầu vào mới vào giờ thấp điểm — bằng một phần năm mươi”. Dù không thể nhắc lại số tiền theo yêu cầu, tỷ lệ chênh lệch này đủ cho thấy định hướng chi phí thấp rất rõ. Về mặt triển khai, DeepSeek phục vụ mô hình trên API riêng với id deepseek-flash, trên base URL tương thích OpenAI và Anthropic, nên client hiện có thường chỉ cần đổi chuỗi mô hình để thử nghiệm. Đây là một API AI chi phí thấp theo đúng nghĩa: dễ thay thế, dễ A/B test, phù hợp để đặt phía sau các route có chuyển đổi dự phòng tự động, cho phép thử một mô hình chưa được kiểm chứng mà không mạo hiểm hệ thống production. Quan trọng hơn cả giá là giấy phép: trọng số V4.1 Flash và phiên bản Flash-1017 được công bố dưới MIT, cho cả kho lưu trữ và trọng số, và được ghi rõ là có thể dùng cho mục đích thương mại. Điều này biến V4.1 Flash thành một mô hình ngôn ngữ mở theo nghĩa thực dụng: doanh nghiệp có thể tải về, sửa đổi, tối ưu cho hạ tầng riêng, thay vì bị khóa vào một nhà cung cấp duy nhất.
Hiệu suất coding agent: DeepSeek V4.1 Flash có thật sự vượt GPT-6 Astra?
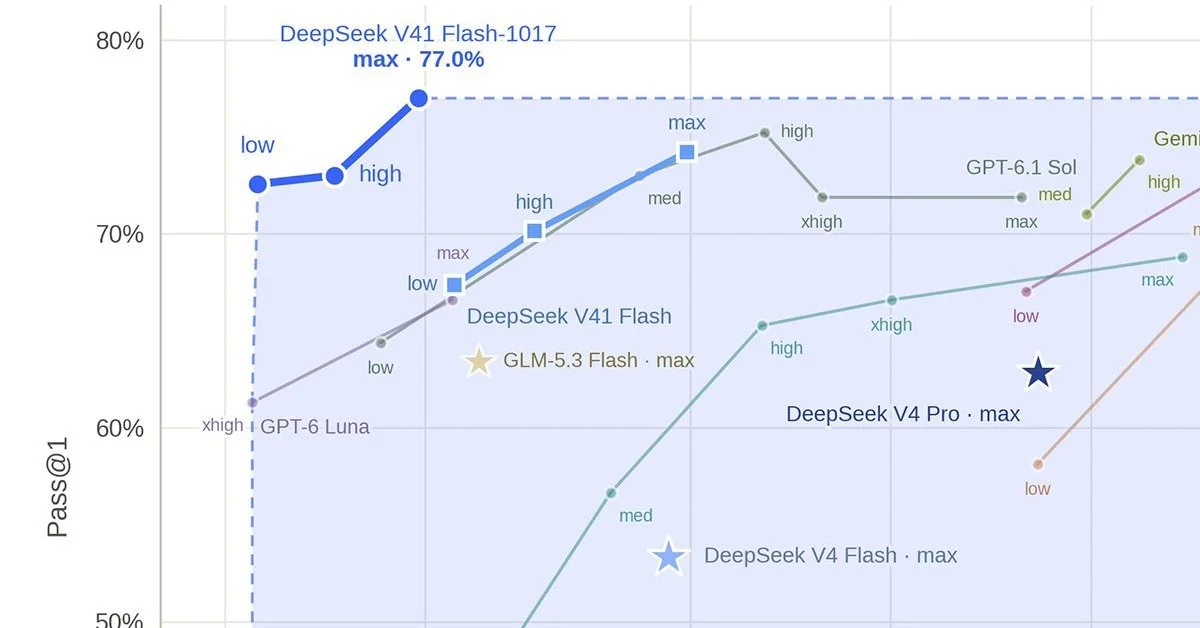
DeepSeek không giấu tham vọng khi tuyên bố V4.1 Flash vượt trội hơn GPT-6 Astra trong một số bài đánh giá hiệu suất coding agent. Trong benchmark DeepSWE v1.1 đo hiệu năng coding agent, với thiết lập suy luận “max”, họ báo cáo tỷ lệ thành công 77%, cao hơn GPT-6 Astra và một số mô hình khác như GPT-6.1 Sol hay Claude Opus 5, đồng thời đạt được ở chi phí thấp hơn phiên bản trước. Đây là một câu trích quan trọng vì nó cho thấy Flash không chỉ rẻ mà còn cạnh tranh về chất lượng: “DeepSeekが公表した比較図では、コーディングエージェント性能を測る『DeepSWE v1.1』で推論設定『max』での成功率が77%となり、GPT-6 Astraなどを上回る性能を前バージョンよりさらに低いコストで実現したとしている”。 Tuy nhiên, cần tỉnh táo: các con số này đều đến từ môi trường đánh giá của chính DeepSeek, chưa có nhiều kiểm chứng độc lập. Ngay cả một đồng sáng lập của một nền tảng mô hình mở lớn cũng nhấn mạnh rằng ông “rất muốn biết những hiệu năng này sẽ được đánh giá ra sao ngoài môi trường riêng của họ”. Dù vậy, với kiến trúc mixture-of-experts 552B tham số backbone, 8B tham số kích hoạt mỗi token trong prefill và 16B trong decode, cùng encoder-decoder nhân quả 40 lớp, rõ ràng Flash không phải là một mô hình cắt giảm đến mức tàn nhẫn mà là một thiết kế có chủ đích để tối ưu tỷ lệ hiệu năng/chi phí.
Thời gian thực thi, output tối ưu và ý nghĩa cho mobile, thiết bị biên
Một điểm ít được nói đến nhưng lại quan trọng với ứng dụng di động và thiết bị biên là cách DeepSeek tối ưu thời gian thực thi và lượng output của V4.1 Flash. Họ cho biết đã dùng cơ chế tự phản hồi trong quá trình học tăng cường để cải thiện khả năng đảm nhiệm toàn bộ dự án phát triển như làm game hay dựng mô hình 3D, đồng thời giảm lượng output và thời gian thực hiện tác vụ so với phiên bản trước. Điều này trực tiếp giải quyết hai vấn đề đau đầu trên mobile: độ trễ và băng thông. Ở phía trọng số, V4.1 Flash được phát hành dưới dạng 48 phân đoạn safetensors, khoảng 510 GB, với nhiều định dạng độ chính xác như BF16, F32, FP8 và lượng tử hóa KV cache xuống FP4. Rõ ràng đây không phải mô hình để chạy trên một GPU đơn lẻ; nó thuộc nhóm “thuê một node hoặc bỏ qua”. Nhưng chính việc hỗ trợ mức nỗ lực suy luận có thể chọn liên tục từ 1 đến 100, cùng khả năng kiểm soát mô hình để không “nghĩ quá nhiều” sau khi công việc đã xong, cho phép các nhà cung cấp dịch vụ biên hoặc mobile backend tinh chỉnh giữa chất lượng và tốc độ. Thực tế, với ứng dụng người tiêu dùng, DeepSeek cho phép dùng miễn phí, trong khi API phía sau vẫn tính phí và được tách biệt như hai sản phẩm khác nhau. Điều này cho thấy chiến lược: dùng ứng dụng miễn phí để kéo người dùng, trong khi doanh nghiệp và nhà phát triển sẽ trả tiền cho API, hoặc tự lưu trữ nhờ trọng số MIT nếu muốn kiểm soát toàn bộ chuỗi giá trị.