
Ba mô hình AI nhỏ gọn và bài toán chi phí cho doanh nghiệp nhỏ
So sánh mô hình AI rẻ cho doanh nghiệp nhỏ là việc đặt Claude Haiku 5.5, Qwen3.7 Flash và Granite 4.2 30B cạnh nhau, rồi đánh giá cấu trúc chi phí, khả năng xử lý token và yêu cầu hạ tầng để tối ưu chi phí AI cho các tác vụ văn phòng hàng ngày như tổng hợp email, viết báo cáo, hỗ trợ mã hóa và phân tích tài liệu dài. Ở mức khái quát, Claude Haiku 5.5 là dịch vụ API trả theo lưu lượng, Qwen3.7 Flash là API đa phương thức tối ưu cho thông lượng cao, còn Granite 4.2 30B là mô hình mã nguồn mở bạn tự vận hành trên GPU của mình. Nếu doanh nghiệp của bạn cần khởi động nhanh, ít đầu tư hạ tầng, Haiku và Qwen phù hợp hơn; nếu lưu lượng lớn, ổn định và đội kỹ thuật sẵn sàng, Granite có thể là lựa chọn kinh tế về dài hạn.
Claude Haiku 5.5: API nhanh cho tác vụ ngắn hạn, chi phí dễ kiểm soát
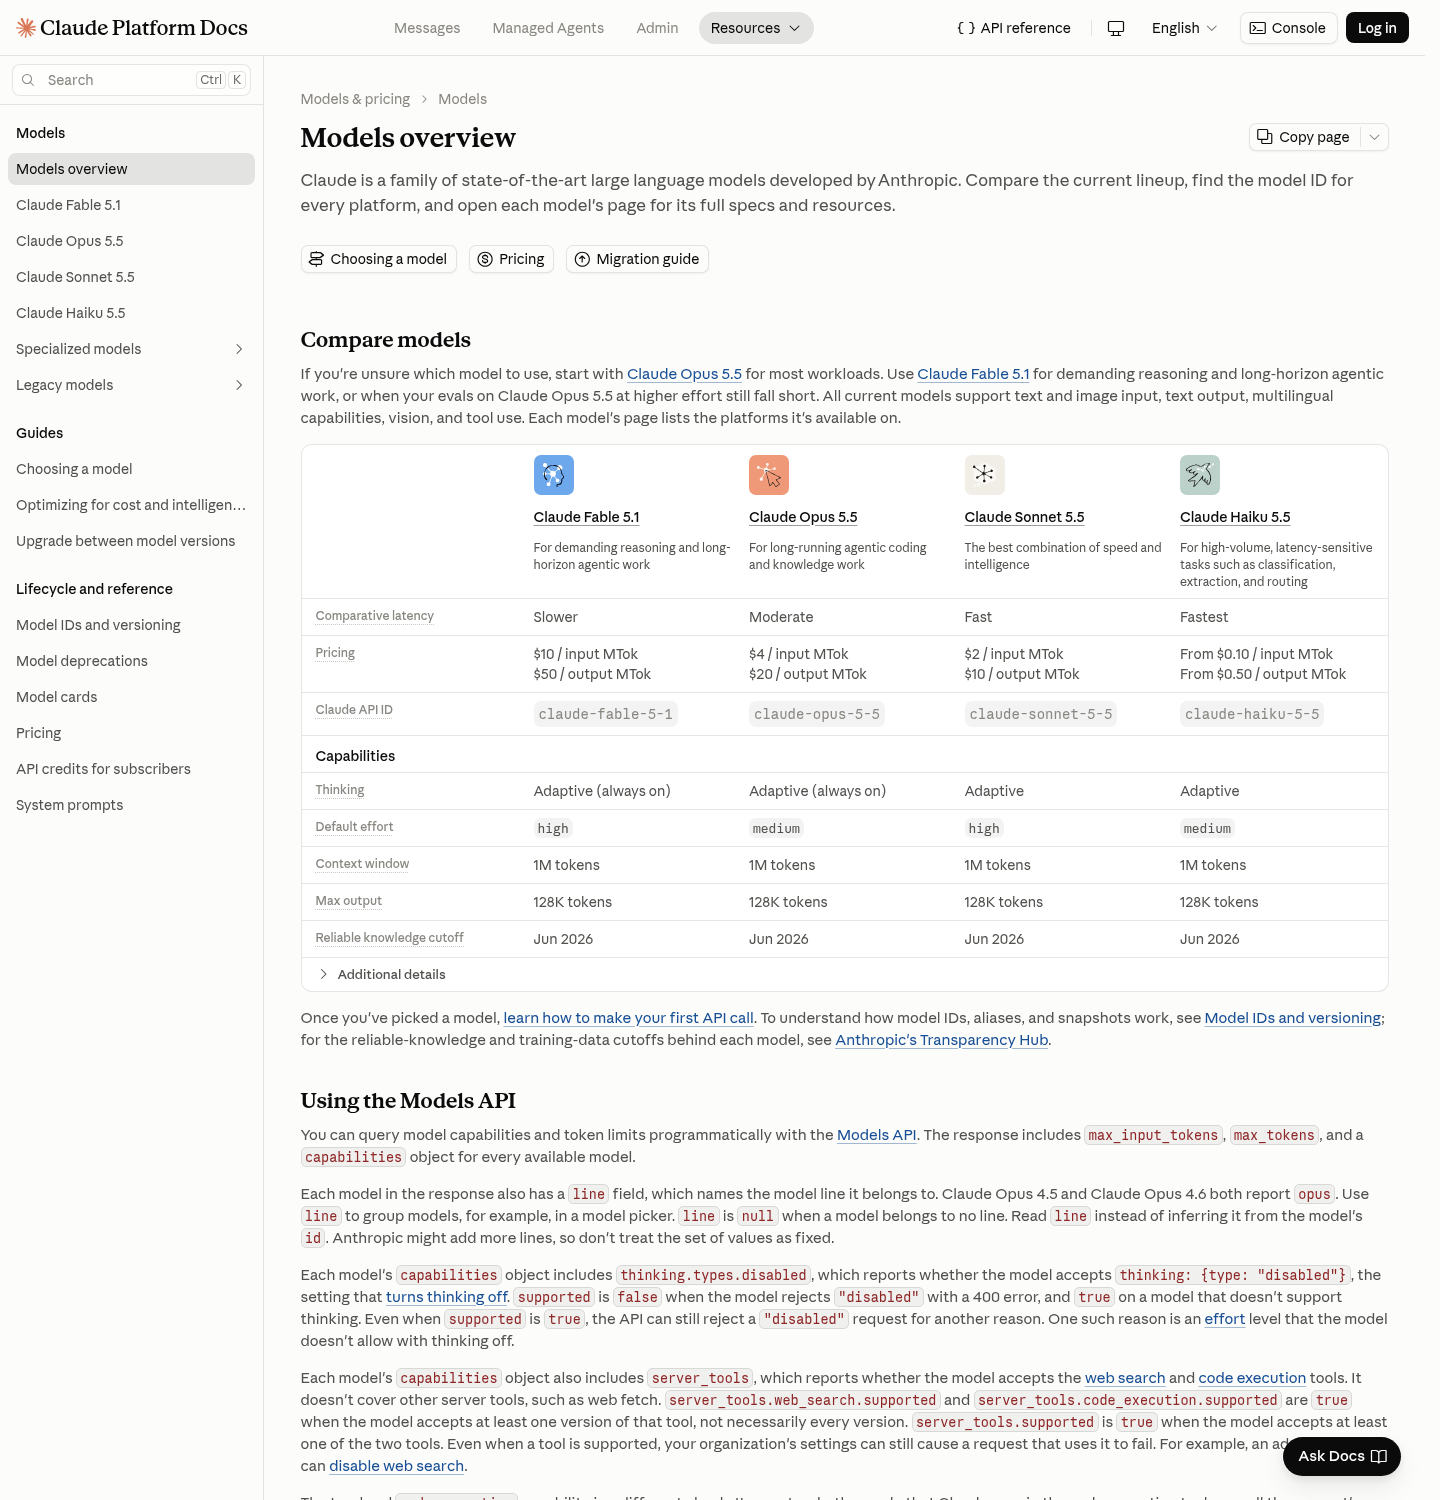
Claude Haiku 5.5 là mô hình nhỏ trong hệ sinh thái Anthropic, được thiết kế như một API tốc độ cao cho khối lượng công việc ngắn hạn và lặp lại, ví dụ chatbot nội bộ, trả lời email, sinh tài liệu ngắn. Mô hình này có cửa sổ ngữ cảnh lên đến một triệu token và đầu ra tối đa 128.000 token, đủ cho hầu hết quy trình văn phòng mà không cần chia nhỏ tài liệu. Theo tài liệu nền tảng, Haiku 5.5 được xem là mô hình nhanh nhất trong dòng sản phẩm hiện tại, với tốc độ khoảng 240 token đầu ra mỗi giây trên bảng đánh giá độc lập. Điểm mạnh của Haiku là bạn không phải lo GPU, bảo trì hay cập nhật mô hình; chi phí gắn trực tiếp với lưu lượng token, nên phù hợp với doanh nghiệp nhỏ chỉ cần khối lượng gọi API vừa phải và muốn dự toán ngân sách theo tháng.
| Spec | Claude Haiku 5.5 | Qwen3.7 Flash |
|---|---|---|
| Kiểu triển khai | API trả theo lưu lượng | API thông lượng cao |
| Ngữ cảnh tối đa | Khoảng 1.000.000 token | Khoảng 1.000.000 token |
| Đầu ra tối đa mỗi lần gọi | 128.000 token | Tài liệu nhà cung cấp ghi 131.072 token |
| Phương thức đầu vào | Văn bản, hình ảnh | Văn bản, hình ảnh, video |
| Phương thức đầu ra | Văn bản | Văn bản |
| Tinh chỉnh | Không cung cấp | Không cung cấp |
Qwen3.7 Flash: thông lượng cao, hỗ trợ video và prompt dài
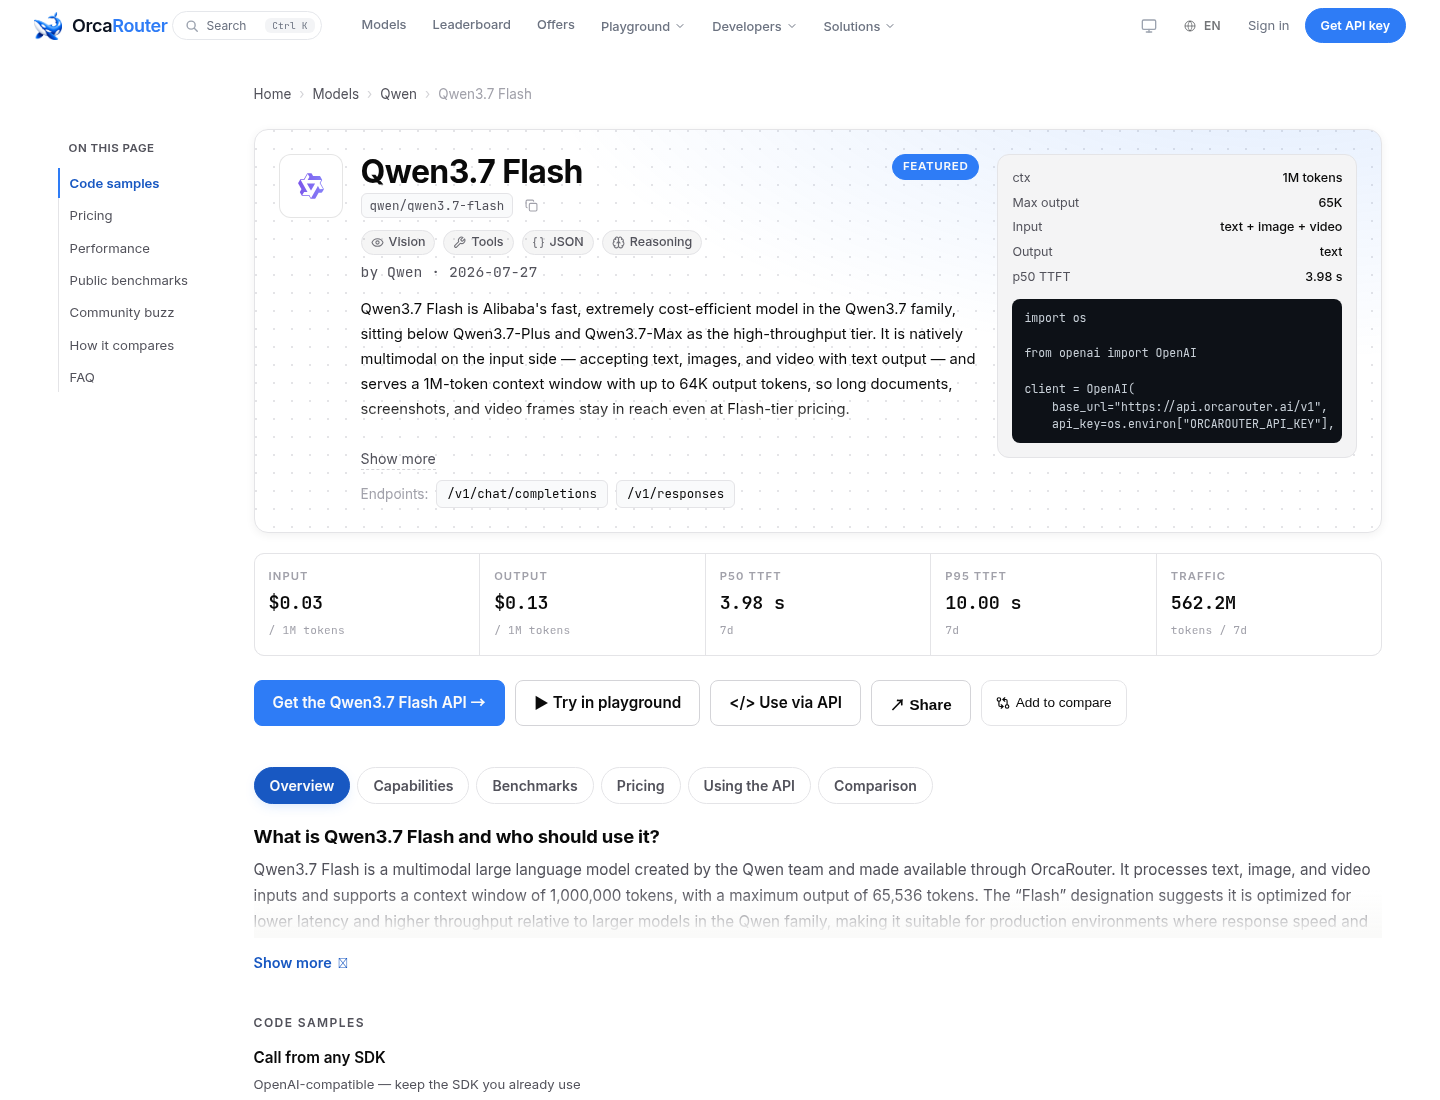
Qwen3.7 Flash là mô hình thị giác–ngôn ngữ nguyên bản, nhận đầu vào văn bản, hình ảnh và video, đầu ra văn bản, với cửa sổ ngữ cảnh công bố lên đến một triệu token và giới hạn đầu vào khoảng 991.808 token. Mô hình này được nhà cung cấp định vị là bậc thông lượng cao trong dòng Qwen3.7, nằm dưới Qwen3.7-Plus và Qwen3.7-Max, phù hợp cho các tác vụ cần nhiều yêu cầu song song như trợ lý văn phòng, phân tích video họp, xử lý tài liệu dài. Theo phân tích của Orca Router, trong khoảng dưới 32.000 token, Qwen3.7 Flash có chi phí hỗn hợp thấp hơn đáng kể so với Claude Haiku 5.5, và từ 100.000 đến 256.000 token, chi phí đầu vào và đầu ra đều thấp hơn nhiều lần. Điều này khiến Qwen3.7 Flash trở thành lựa chọn hấp dẫn cho doanh nghiệp nhỏ có luồng công việc đa phương thức, nhiều phiên chat dài và cần tối ưu chi phí API trên mỗi triệu token.
Granite 4.2 30B: mô hình mã nguồn mở, bài toán mua GPU hay dùng API
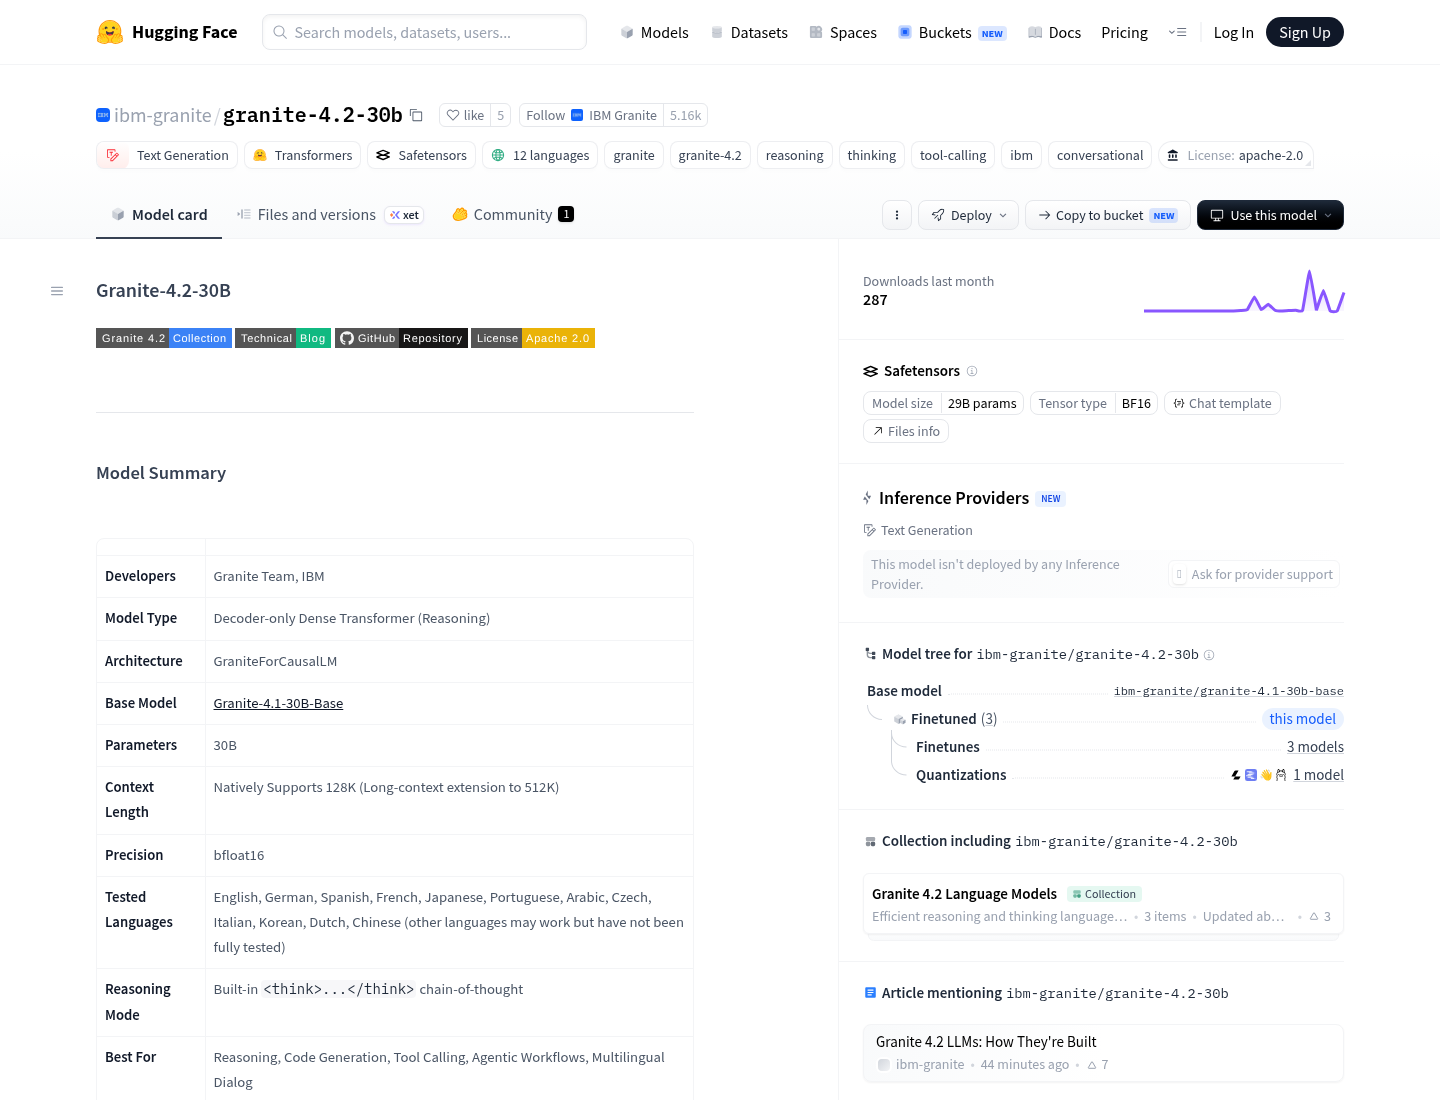
Granite 4.2 30B của IBM là mô hình ngôn ngữ dense 30 tỷ tham số, phát hành theo giấy phép Apache-2.0, nghĩa là doanh nghiệp có thể dùng cho mục đích thương mại mà không bị ràng buộc phí API. Bạn tải trọng số từ Hugging Face và chạy trên GPU do mình sở hữu hoặc thuê, với ngữ cảnh gốc 128K và khả năng mở rộng lên 512K token. Granite là transformer chỉ decoder, mỗi token đều kích hoạt toàn bộ 30 tỷ tham số, nên chi phí thực tế nằm ở phần cứng, điện năng và nhân sự vận hành. Mô hình hỗ trợ ba chế độ suy luận với chuỗi tư duy nội bộ, hữu ích cho bài toán logic nhiều bước, lập trình và gọi công cụ dạng tác tử. Đối với doanh nghiệp nhỏ, Granite chỉ trở thành mô hình AI rẻ khi lưu lượng token đủ lớn để chi phí GPU bình quân trên mỗi triệu token thấp hơn chi phí API của các mô hình như Claude Haiku 5.5 hoặc Qwen3.7 Flash.
Điểm giao thoa token: khi nào nên chuyển từ API sang GPU riêng?
Tối ưu chi phí AI cho doanh nghiệp nhỏ không chỉ là chọn mô hình rẻ trên giấy, mà là hiểu điểm giao thoa token giữa cấu trúc API và mô hình tự vận hành. Với Claude Haiku 5.5 và Qwen3.7 Flash, chi phí gắn trực tiếp với số token vào/ra, nên phù hợp khi tổng lưu lượng mỗi tháng còn thấp hoặc biến động mạnh; bạn trả cho mức dùng thực tế, không phải cho GPU rảnh rỗi. Ngược lại, Granite 4.2 30B không thu phí theo token, nhưng yêu cầu đầu tư hoặc thuê GPU, nghĩa là chi phí cố định. Khi tổng số token suy luận tăng lên, chi phí bình quân trên mỗi triệu token của Granite giảm dần, trong khi chi phí API tăng tuyến tính. Điểm giao thoa là thời điểm mà đường chi phí Granite cắt đường chi phí API: từ đó trở đi, mỗi token thêm vào rẻ hơn trên GPU riêng. Doanh nghiệp nhỏ nên ước lượng lưu lượng token 6–12 tháng, rồi quyết định giữ API hay chuyển sang mô hình mã nguồn mở.
Buy if / Skip if
- Buy the Claude Haiku 5.5 if doanh nghiệp của bạn cần khởi động nhanh, khối lượng công việc văn phòng ngắn hạn, muốn tránh đầu tư GPU và ưu tiên độ trễ thấp trên API.
- Skip the Claude Haiku 5.5 if bạn thường xuyên xử lý prompt rất dài trên 100.000 token và cần tối ưu chi phí trên mỗi triệu token cho khối lượng lớn.
- Buy the Qwen3.7 Flash if bạn cần mô hình AI rẻ cho thông lượng cao, nhiều phiên chat dài, hỗ trợ video và muốn tối ưu chi phí API trong dải ngữ cảnh rộng.
- Skip the Qwen3.7 Flash if quy trình của bạn chỉ dùng văn bản ngắn, không cần video, và muốn gắn bó với một hệ sinh thái cụ thể như Anthropic.
- Buy the Granite 4.2 30B if bạn có đội kỹ thuật, sẵn sàng đầu tư hoặc thuê GPU, lưu lượng token ổn định lớn và muốn tránh chi phí API dài hạn.
- Skip the Granite 4.2 30B if doanh nghiệp nhỏ chưa có năng lực vận hành hạ tầng AI, lưu lượng thấp hoặc biến động, và cần giải pháp dùng là trả ngay qua API.