
Hai con số, hai câu hỏi khác nhau
Benchmark Kimi K3.1 Pro là tập hợp các phép thử dùng để ước lượng năng lực của mô hình trên những nhiệm vụ cụ thể; điểm số chỉ có thể so sánh trực tiếp khi nguồn, bài kiểm tra và cấu hình chạy tương đồng. Trong đợt ra mắt, Artificial Analysis chấm mô hình 55 điểm trên Intelligence Index phiên bản 4.3.2, chỉ số tổng hợp mười đánh giá; bảng Moonshot ghi 65,7% trên Terminal-Bench 4.0. Đây không phải hai kết quả của cùng một bài thi: một bên là điểm chỉ số tổng hợp độc lập, bên kia là tỷ lệ đạt ở một bài kiểm tra cụ thể do nhà cung cấp công bố. Vì vậy, nhìn riêng hai con số rồi kết luận chúng mâu thuẫn về năng lực là đọc sai dữ liệu. Nhưng chênh lệch trong cách kể vẫn đáng chú ý: bảng của Moonshot tạo ấn tượng Kimi vượt GPT-6 Astra trên Terminal-Bench, còn điểm tổng hợp độc lập đặt Kimi nhỉnh hơn Astra hai điểm, với 55 so với 53.
Điểm Artificial Analysis xếp Kimi thứ tư trong 215 mô hình cùng lớp; mức trung vị của nhóm là 27, còn Claude Opus 5.5 đạt 58. Những con số này cho thấy Kimi có kết quả cao trong bộ đánh giá ấy, nhưng không biến 55 thành thước đo có thể thay thế mọi benchmark. Đánh giá mô hình AI cần bắt đầu bằng câu hỏi: điểm được tạo ra từ những nhiệm vụ nào, và có phản ánh công việc người dùng định giao hay không?
Terminal-Bench: cấu hình quan trọng ngang với mô hình
Ở Terminal-Bench 4.0, bảng Moonshot công bố Kimi K3.1 Pro đạt 65,7%, so với 66,4% của Claude Opus 5.5 và 58,2% của GPT-6 Astra. Kimi hơn Astra 7,5 điểm phần trăm, nhưng không dẫn đầu hàng này: Opus cao hơn 0,7 điểm. Quan trọng hơn, đây chưa phải một cuộc đối đầu đồng điều kiện. Opus được chạy ở mức nỗ lực xhigh, cao hơn mặc định; Kimi dùng cấu hình mặc định max. Hai kết quả còn đến từ các bộ khung đánh giá khác nhau. Vì vậy, điểm Terminal-Bench Kimi hữu ích như một tín hiệu, nhưng không đủ để tuyên bố mô hình nào vượt trội trong mọi thiết lập.
Cách chạy có thể làm đổi kết quả đáng kể: phần scaffolding bao quanh mô hình và mức nỗ lực suy luận đều ảnh hưởng đến điểm Terminal-Bench. Bởi vậy, một bảng benchmark thực chất nói về cả mô hình lẫn quy trình kiểm thử. Nếu không có cấu hình chi tiết và cách dựng harness tương thích, phép so sánh giữa các nhà cung cấp chỉ nên được xem là tham khảo, không phải phép đo sạch để chọn người thắng.
| Nguồn và bài đánh giá | Kimi K3.1 Pro | Đối chiếu được công bố |
|---|---|---|
| Artificial Analysis, Intelligence Index 4.3.2 | 55 điểm; hạng 4/215 | GPT-6 Astra 53; Claude Opus 5.5 58 |
| Moonshot, Terminal-Bench 4.0 | 65,7% | Claude Opus 5.5 66,4%; GPT-6 Astra 58,2% |
| Kimi Code Bench 3.0, long-horizon | 61,2% | Kimi K3 đạt 55,95% |
Những khoảng trống khiến kết luận còn sớm
Bảng điểm còn thiếu dữ liệu ở những nơi lẽ ra giúp người đọc kiểm tra bức tranh năng lực. Với Terminal-Bench-Science 0.1, tài liệu Moonshot chỉ nói Kimi K3.1 Pro cao hơn K3 mà không nêu điểm; Anthropic công bố Claude Opus 5.5 ở mức 58,7%. Còn SWE-bench, một thước đo thường được viện dẫn khi nói về tác nhân lập trình, được nhắc trong chú thích ra mắt nhưng không có điểm cụ thể. Trang hướng dẫn nhanh vào ngày ra mắt cũng còn các ô giữ chỗ dạng “[xx.x%]” cho Terminal-Bench 4.0, Terminal-Bench-Science 0.1 và một số đánh giá lập trình nội bộ, trong khi bài tiếp thị đã đưa ra số hoàn chỉnh. Sự khác biệt giữa tài liệu khiến việc kiểm tra và tái lập kết quả khó hơn.
Các hàng khác giúp bổ sung góc nhìn nhưng vẫn cần đặt đúng phạm vi. Trên Kimi Code Bench 3.0 long-horizon, Kimi đạt 61,2%, cao hơn mức 55,95% của thế hệ Kimi K3; đây là so sánh dễ đọc hơn vì benchmark và bộ khung đều thuộc Moonshot. Ở SWE Marathon, bảng tài liệu ghi Kimi 51,7%, cao hơn Claude Opus 5.5 ở 46,3% và GPT-6 Astra ở 42,5%. Ngược lại, BenchCAD có công cụ cho Kimi 92,7%, thấp hơn Opus 96,2% và Astra 95,9%. Không có một hàng nào đủ đại diện cho mọi công việc.
Điều người dùng nên kiểm tra trước khi chọn
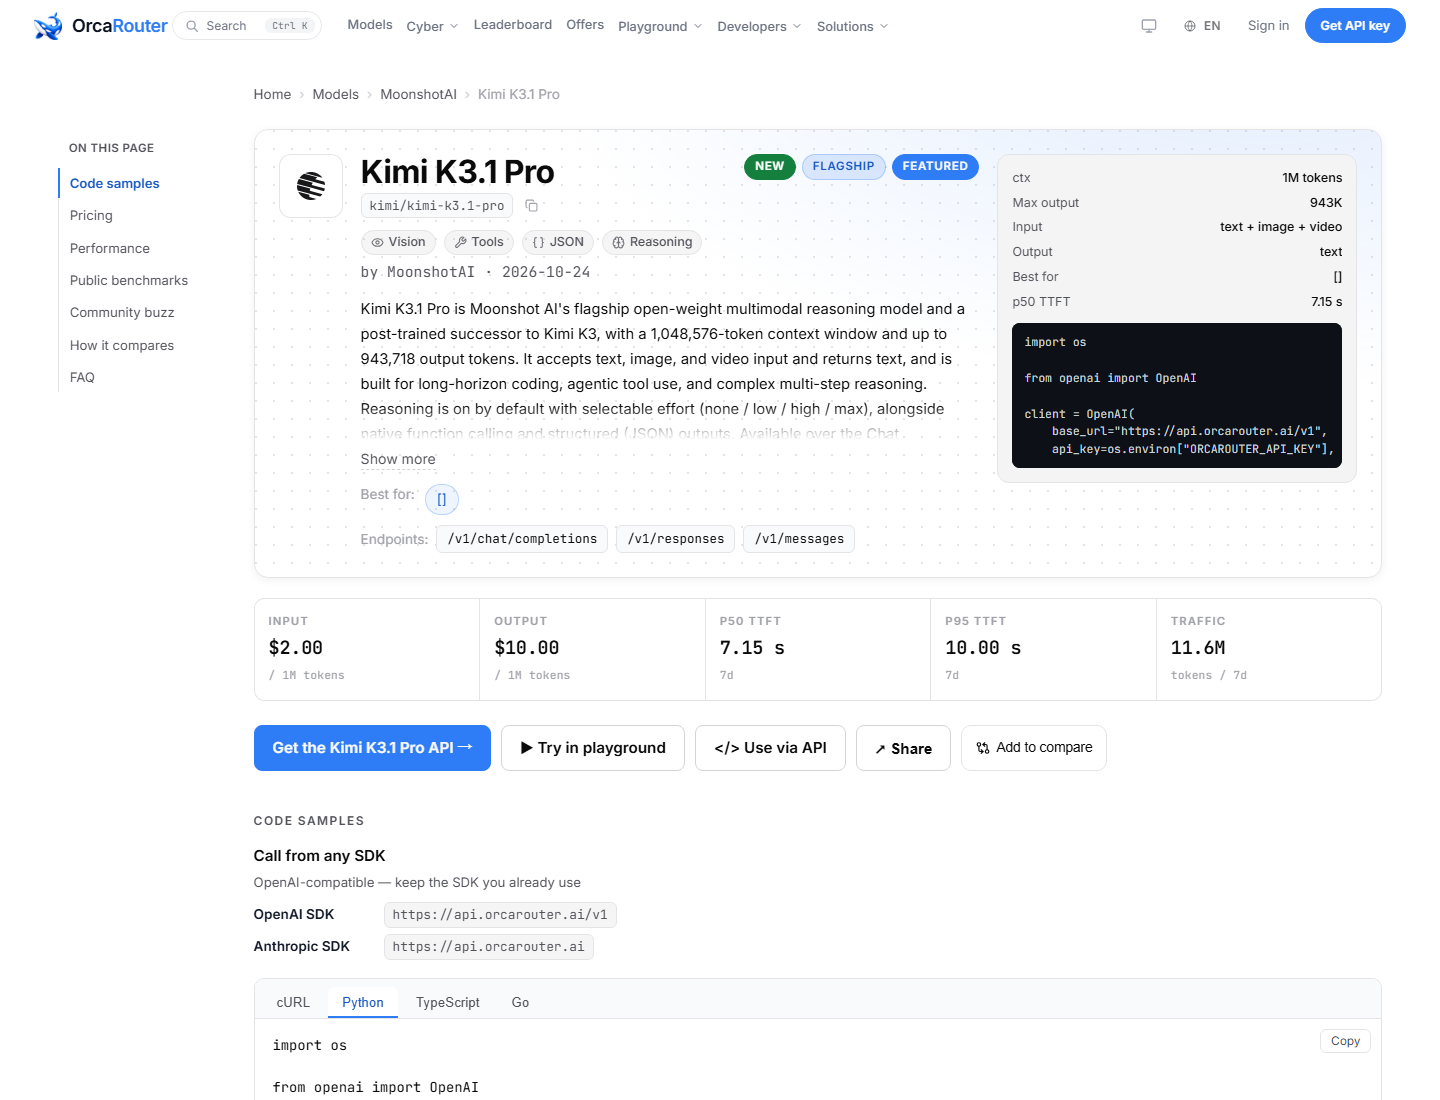
Với người dùng thực tế, điểm benchmark chỉ là bước sàng lọc; tốc độ phản hồi, độ dài câu trả lời và mức suy luận có thể quyết định trải nghiệm lẫn lượng đầu ra cần xử lý. Artificial Analysis ghi nhận tốc độ 73,5 token đầu ra mỗi giây, thấp hơn mức trung bình 82, và Kimi tạo 150 triệu token đầu ra trong lần chạy chỉ số, so với trung vị 87 triệu. Nhận xét mô hình khá dài dòng đặc biệt đáng lưu tâm với tác vụ viết tài liệu, lập trình kéo dài hoặc quy trình tác nhân tạo nhiều nội dung. Tuyến thử nghiệm được nêu có thời gian trung vị đến token đầu tiên 7,15 giây, một chỉ báo hữu ích cho phiên làm việc tương tác nhưng không bảo đảm tốc độ ở mọi nhà cung cấp.
Bối cảnh công bố cũng chưa khép lại: tại ngày 24 tháng 10, trọng số Kimi vẫn được hứa hẹn nhưng chưa phát hành; phân loại mô hình có thể thay đổi vào ngày 4 tháng 11 nếu Moonshot giữ lịch. Kết luận hợp lý lúc này không phải chọn một con số làm chân lý, mà là coi 55 và 65,7% như kết quả của hai phép đo khác nhau. Trước khi chuyển tải công việc, hãy thử một mẫu tác vụ thật ở mức nỗ lực thấp, cao và tối đa, rồi so chất lượng, thời gian và lượng đầu ra. Benchmark giúp đặt câu hỏi; cấu hình phù hợp với công việc của bạn mới đưa ra câu trả lời.