
Claude Fable 5.1 là gì và câu hỏi lớn về chi phí – hiệu năng
Claude Fable 5.1 là mô hình ngôn ngữ lớn mới của Anthropic, được thiết kế cho lập trình, công việc tri thức và các quy trình AI Agent nhiều bước, tập trung đồng thời vào giảm chi phí thực tế khoảng 25% cho workload thông thường và tăng hiệu năng ở mức suy luận cao để phù hợp với những tác vụ phức tạp, kéo dài hàng giờ. Vấn đề quan trọng với doanh nghiệp không phải là mô hình có “mạnh” hơn trên bảng điểm hay không, mà là liệu sự cân bằng giữa chi phí thấp hơn và hiệu năng cao hơn có đủ để thay đổi cách họ triển khai AI ở quy mô lớn. Từ góc nhìn vận hành, Fable 5.1 là bước thử nghiệm rõ ràng: nếu bạn muốn đưa AI từ chatbot trả lời từng câu sang Agent thực sự chạy liên tục nhiều giờ, đây là một ứng viên đáng cân nhắc nhưng không phải không có điều kiện đi kèm.

Giảm chi phí AI: 25% với workload thường, tới 45% cho Agent dài giờ
Điểm thuyết phục nhất của Claude Fable 5.1 với doanh nghiệp là câu chuyện giảm chi phí AI chứ không phải điểm số benchmark. Anthropic giữ nguyên mức giá cơ bản nhưng cắt mạnh chi phí đọc cache, giúp tổng chi phí thực tế giảm khoảng 25% với các tác vụ thông thường và tới 45% với quy trình AI tự chủ nhiều bước. Đây là thay đổi mang tính chiến lược: với Agent phải liên tục đọc lại mã nguồn, tài liệu và lịch sử hội thoại nhiều giờ, giảm chi phí bộ nhớ đệm là cách tối ưu hóa LLM thực tế hơn bất kỳ điểm IQ giả định. Nói một câu có thể trích dẫn: “Anthropic ước tính tổng chi phí của các tác vụ thông thường có thể giảm khoảng 25%, còn những tác vụ Agent phức tạp có thể giảm tới khoảng 45%.” Nếu doanh nghiệp đang đau đầu vì hóa đơn AI phình to khi thử nghiệm Agent, Fable 5.1 trực tiếp nhắm vào điểm đau đó.
Hiệu năng Claude ở effort cao: Fable 5.1 thắng thế nhưng không phải phép màu
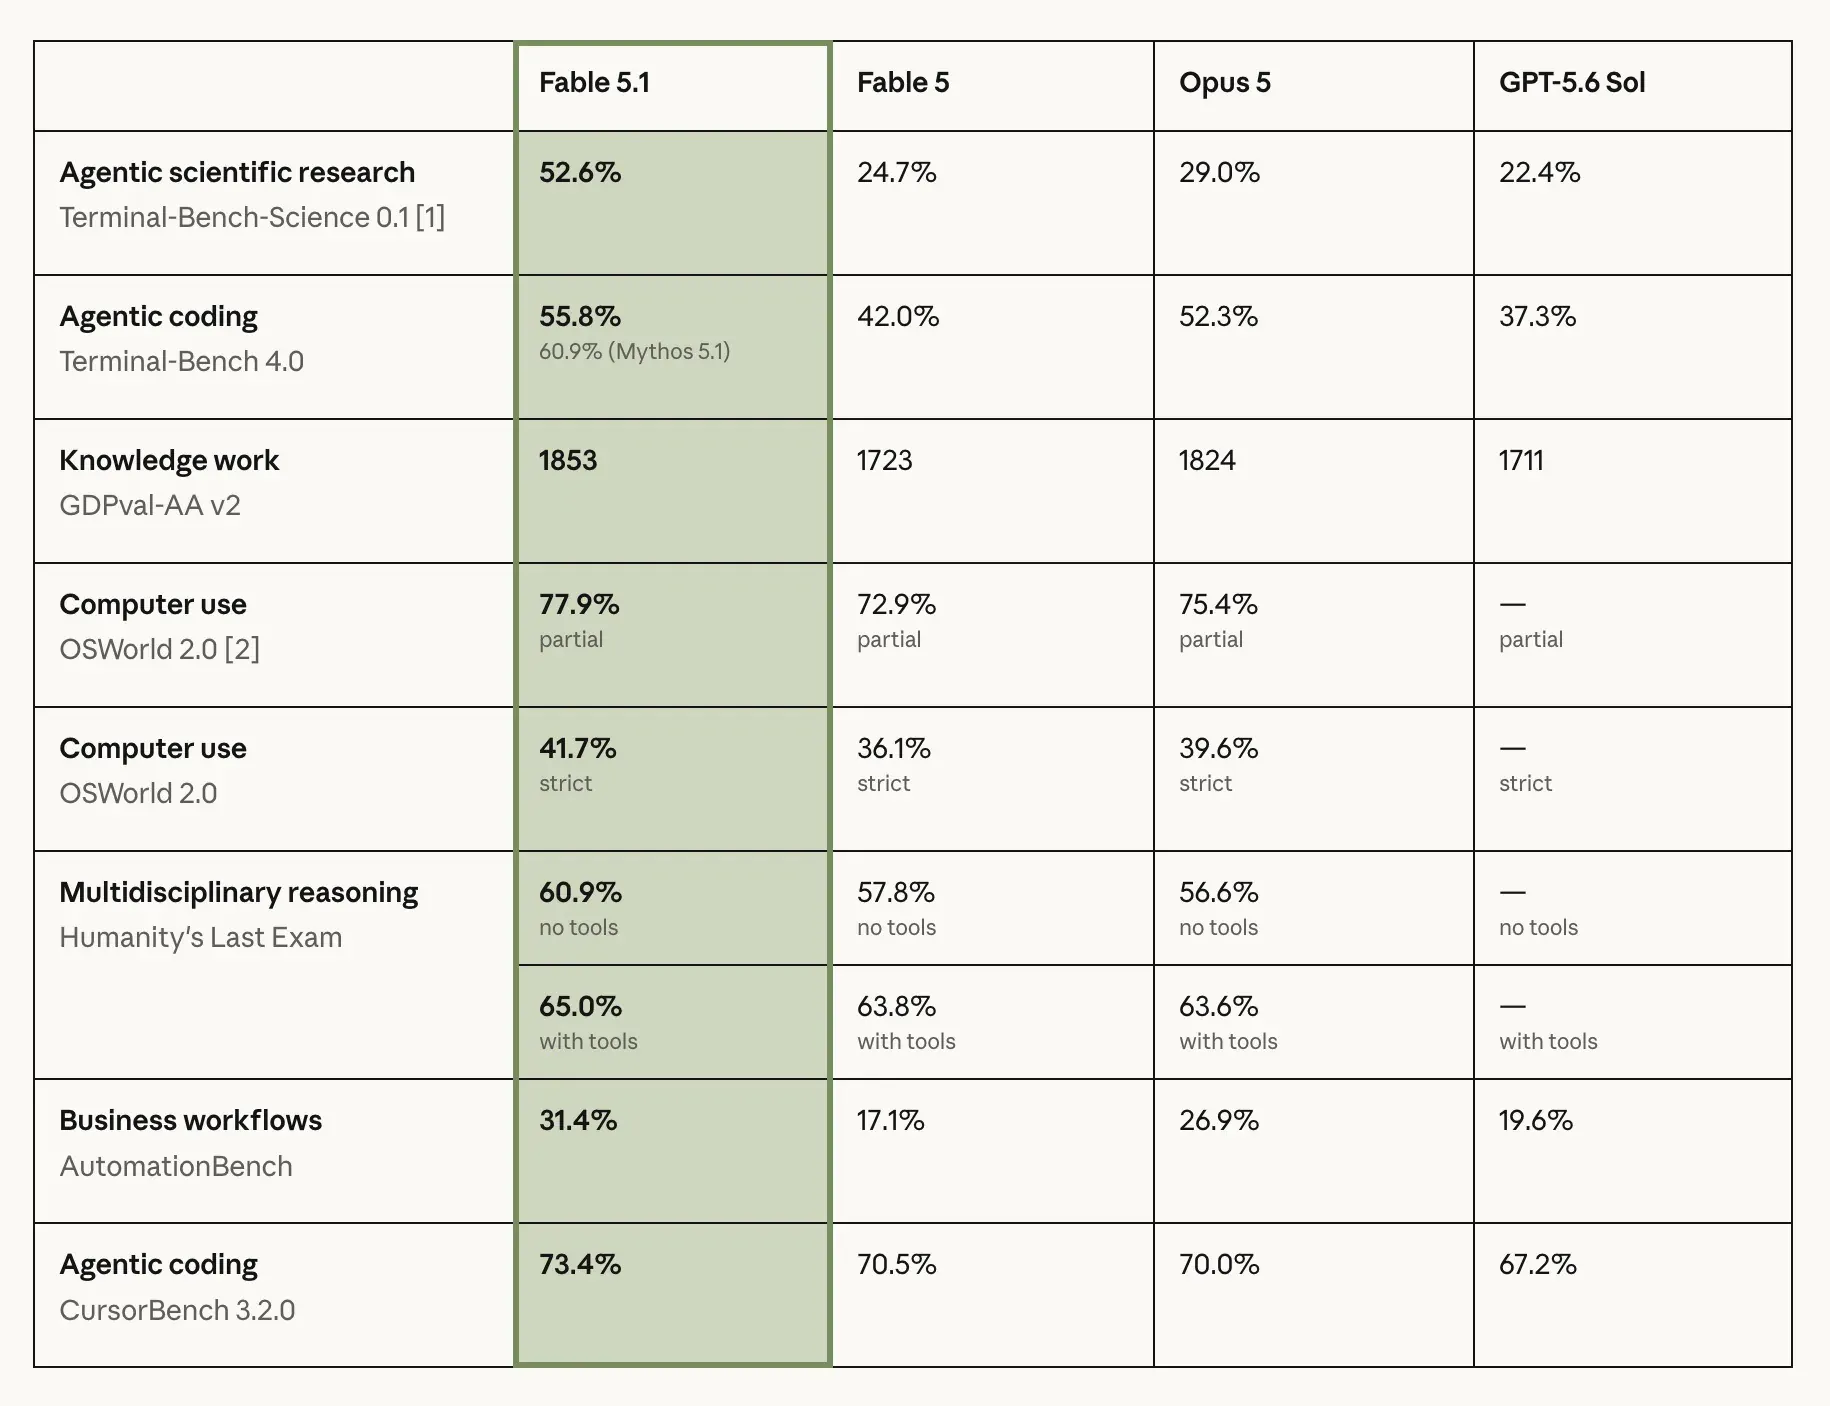
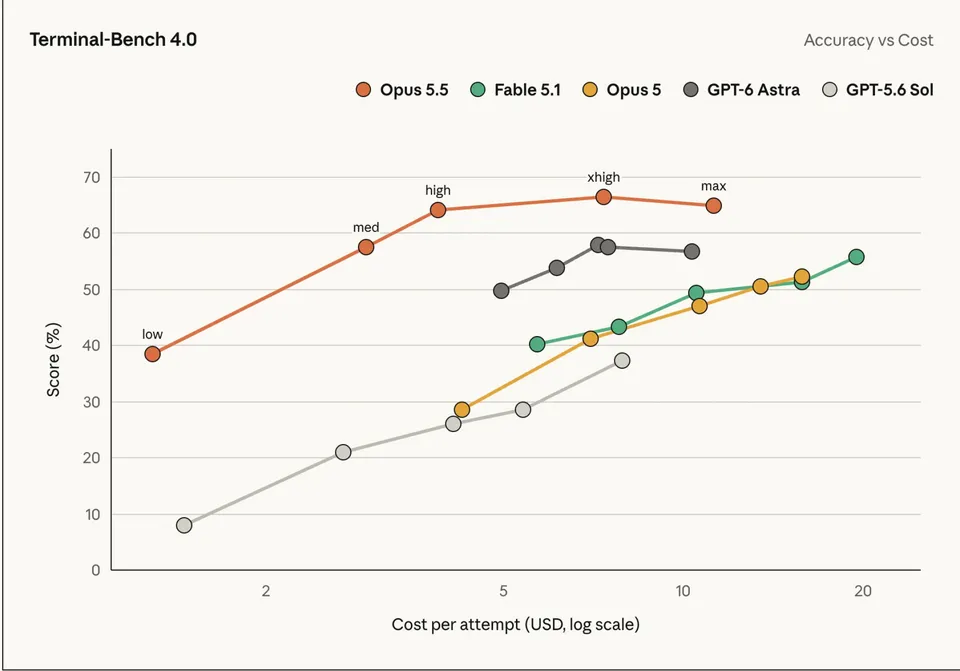
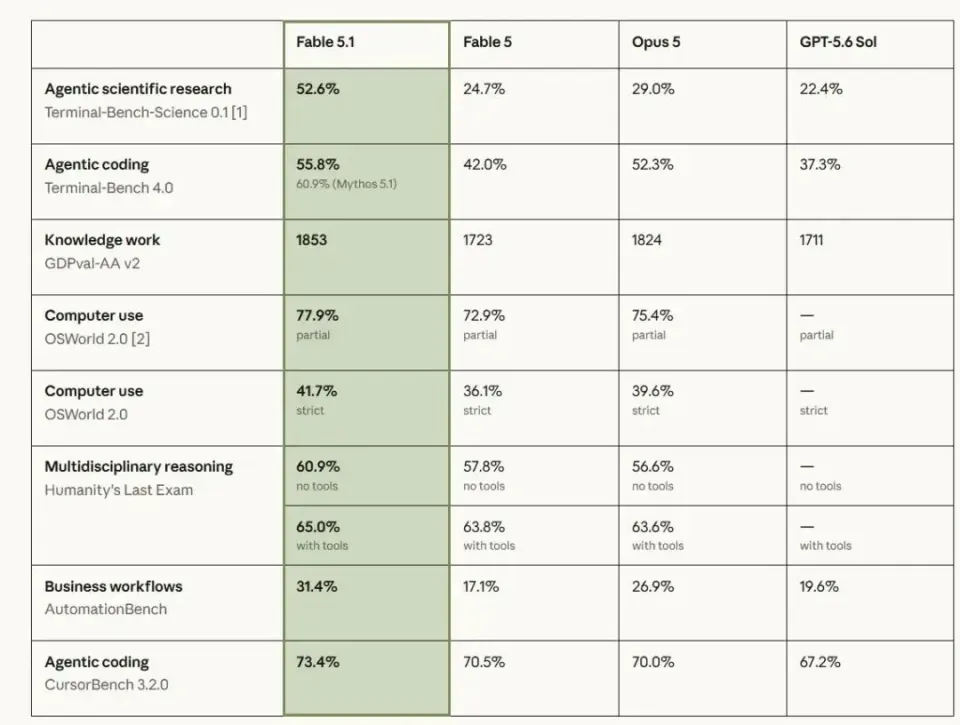
Về hiệu năng Claude, Fable 5.1 không tạo cú sốc trên các bài hỏi đáp đơn giản, nhưng thay đổi rõ ở mức suy luận cao. Mô hình đạt kết quả tương đương hoặc tốt hơn Fable 5 ở effort thấp và trung bình; khi tăng lên mức cao hơn, hiệu năng cải thiện rõ rệt cho lập trình, xử lý tri thức và các bài toán cần duy trì quá trình xử lý lâu. Trên nhiều bài kiểm thử, Fable 5.1 được cho là vượt Fable 5, Opus 5 và GPT-5.6 Sol trong nhiều kịch bản phức tạp. Đi sâu vào Agent thực thi trong terminal, Fable 5.1 đạt 55,8% trên Terminal-Bench 4.0, trong khi Mythos 5.1 nhỉnh hơn với 60,9%. Con số này quan trọng vì nó đo khả năng thực sự “làm việc” lâu với hệ thống, không chỉ viết vài dòng code. Tuy vậy, phần lớn dữ liệu hiệu năng vẫn đến từ thử nghiệm nội bộ của Anthropic và đối tác, chưa phải đánh giá độc lập. Doanh nghiệp nên xem đây là tín hiệu tích cực, nhưng không nên đánh đồng với bảo chứng tuyệt đối.
Tối ưu hóa LLM: cache rẻ hơn và siết chặt sao chép chuỗi suy luận
Fable 5.1 thể hiện cách Anthropic tối ưu hóa LLM ở hai mặt: vận hành và bảo vệ tài sản trí tuệ. Vận hành là câu chuyện giảm chi phí đọc cache như đã nói, giúp Agent có thể hoạt động lâu hơn mà không làm chi phí bùng nổ. Về bảo vệ, Anthropic triển khai cơ chế chống distillation: phần “suy nghĩ” nội bộ của Claude được gắn với lời nhắc hệ thống, công cụ và lịch sử cụ thể; nếu người dùng thay đổi ngữ cảnh rồi cố đưa phần suy nghĩ cũ trở lại, API sẽ phát hiện không nhất quán và loại bỏ nội dung. Mục tiêu là ngăn việc khai thác hàng loạt chuỗi suy luận để huấn luyện mô hình khác. Từ góc nhìn doanh nghiệp, đây là con dao hai lưỡi: bạn được bảo vệ tốt hơn khỏi rò rỉ logic nội bộ, nhưng cũng đồng nghĩa việc tái sử dụng output cho mục đích huấn luyện riêng sẽ bị hạn chế rõ rệt. Những tổ chức xây chiến lược AI xoay quanh chưng cất mô hình từ các LLM bên ngoài cần cân nhắc kỹ.
Fable 5.1 hay Mythos 5.1: doanh nghiệp nên chọn hướng nào?
Fable 5.1 và Mythos 5.1 dùng cùng một mô hình nền tảng, khác nhau chủ yếu ở mức bảo vệ và đối tượng sử dụng. Fable 5.1 mở rộng cho người dùng phổ thông và doanh nghiệp, còn Mythos 5.1 chỉ dành cho tổ chức nghiên cứu và an ninh được Anthropic phê duyệt, với chính sách an toàn ít hạn chế hơn. Điều này tạo nên khoảng cách hiệu năng thực tế: trên bài Terminal-Bench 4.0, Mythos đạt 60,9% so với 55,8% của Fable, cho thấy cùng một mô hình nhưng bị ràng buộc khác nhau có thể cho kết quả rất khác. Mythos còn được dùng trong các thử nghiệm thiết kế protein với tỷ lệ thành công gần 50% trên 12 mục tiêu, cao hơn nhiều so với chuẩn 10–15% mà Anthropic đưa ra. Tuy nhiên, cả hai phiên bản đều mang các giới hạn an toàn nhất định, như chỉ hỗ trợ phát hiện lỗ hổng phần mềm nhưng không giúp phát triển mã khai thác từ lỗ hổng đó. Kết luận thẳng thắn: đa số doanh nghiệp sẽ phải chấp nhận Fable 5.1 với hiệu năng bị “giảm độ tự do” so với Mythos, đổi lại là khả năng triển khai rộng và tuân thủ.