
Claude API caching là gì và vì sao doanh nghiệp nên quan tâm?
Claude API caching là cơ chế lưu lại phần ngữ cảnh cố định của prompt (system prompt, mô tả tool, tài liệu tham chiếu) để các lần gọi sau có thể đọc lại từ cache thay vì tính toàn bộ phí token đầu vào mỗi lần, từ đó giảm chi phí token đáng kể trên các workload dài và lặp lại nhiều bước, đặc biệt là agent xử lý tài liệu lớn và mã nguồn ổn định. Với Claude Fable 5.1, đọc cache được giảm giá mạnh, nên nếu ứng dụng của bạn thường xuyên dùng lại cùng một khối ngữ cảnh qua nhiều gọi API, việc đầu tư triển khai cache có thể mang lại mức tiết kiệm tương đương hoặc lớn hơn mọi tối ưu prompt thủ công.
Ở Fable 5.1, phần giảm giá nằm ở "cache read discount": token đọc lại từ cache rẻ hơn đáng kể so với token input thường, trong khi giá token input và output giữ nguyên. Điều này khiến Claude API caching trở nên đặc biệt hấp dẫn cho các doanh nghiệp đang triển khai hệ thống trợ lý nội bộ, nghiên cứu, phân tích tài liệu hoặc agent code review, nơi cùng một bộ quy tắc, repo, hay tài liệu được dùng lại qua hàng chục, hàng trăm bước suy luận. Ngược lại, nếu bạn chủ yếu dùng prompt ngắn, một câu hỏi, một câu trả lời thì lợi ích kinh tế từ cache sẽ khá hạn chế vì tỷ lệ token đọc lại không cao.
Hiểu giá, ngưỡng token và TTL 5 phút – 1 giờ trước khi bật cache
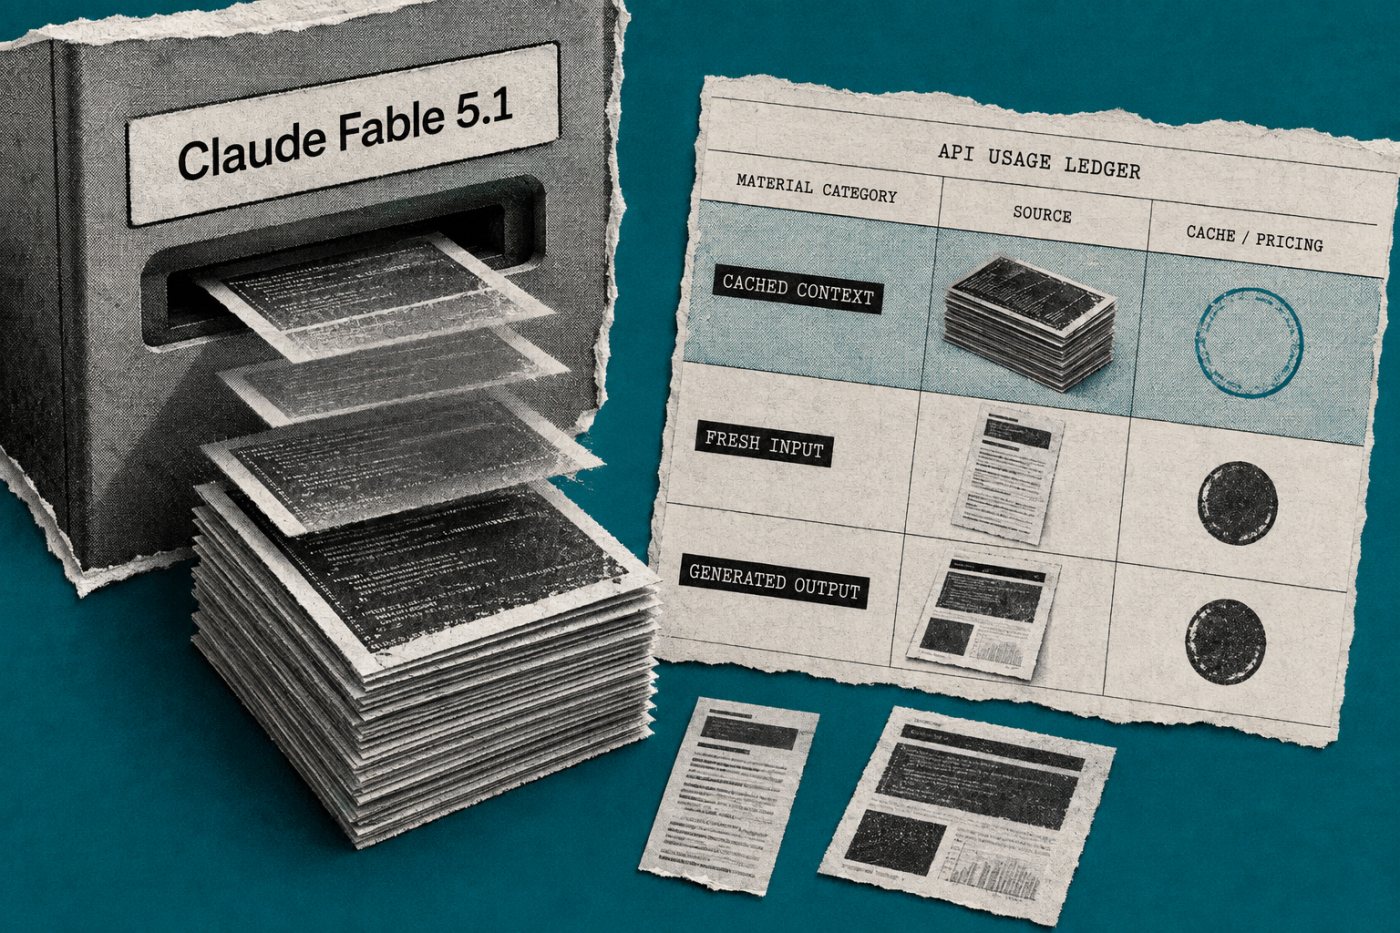
Trước khi áp dụng Claude API caching, bạn cần nắm ba yếu tố: ngưỡng token tối thiểu để cache hoạt động, cách tính giảm chi phí token và thời hạn cache (TTL) 5 phút hay 1 giờ. Mỗi model có ngưỡng token khác nhau; Fable 5.1 yêu cầu tối thiểu 512 token cho phần tiền tố được cache. Nếu system prompt và khối nội dung cố định của bạn ngắn hơn ngưỡng này thì ngay cả khi thêm cache_control, request vẫn chạy bình thường nhưng không tạo cache, không có lỗi báo về – nghĩa là bạn tưởng đã tối ưu nhưng thực tế chưa tiết kiệm gì.
Về TTL, tài liệu giá cho thấy cache write 5 phút thường đắt hơn khoảng 1,25 lần so với input chuẩn, cache write 1 giờ khoảng gấp 2 lần, còn cache read ~0,1 lần so với input chuẩn cho đa số model. Khi áp dụng, có hai mốc hòa vốn: với TTL 5 phút, chỉ cần một lần đọc cache (tổng hai lần gọi với cùng tiền tố) là chi phí bắt đầu rẻ hơn so với không dùng cache; với TTL 1 giờ, cần ít nhất hai lần đọc cache (tổng ba lần gọi) để vượt qua chi phí cao của cache write. Nói ngắn gọn: nếu bạn không chắc sẽ gọi lại cùng một tiền tố trong vòng 5 phút hoặc 1 giờ đủ số lần, cache write có thể không tự "trả vốn" và chỉ làm hóa đơn phình thêm.
| Thông số | TTL 5 phút | TTL 1 giờ |
|---|---|---|
| Chi phí tương đối cache write | ≈1,25 lần input chuẩn | ≈2 lần input chuẩn |
| Chi phí tương đối cache read | ≈0,1 lần input chuẩn | ≈0,1 lần input chuẩn |
| Số lần đọc cache để bắt đầu tiết kiệm | ≥1 lần đọc (tổng 2 request) | ≥2 lần đọc (tổng 3 request) |
Quy trình 5 bước cấu hình Claude API caching và kiểm thử Fable 5.1
Đây là phần quan trọng: làm sao bật Claude API caching trên Fable 5.1 mà không phá vỡ agent hiện có. Bạn nên tiếp cận như một cuộc trò chuyện có kiểm soát với hệ thống: tách phần tiền tố cố định, gắn cache_control đúng chỗ, thử trên workload thật, rồi mới mở rộng sang production. Lưu ý, Fable 5.1 có vài thay đổi tương thích khiến payload cũ (đặc biệt phần tool và thinking block) có thể trả về lỗi HTTP 400 nếu không điều chỉnh. Dưới đây là quy trình tuần tự mà bạn có thể đi cùng đồng đội kỹ thuật để vừa tối ưu chi phí token, vừa giữ hệ thống ổn định.
- Bước 1 – Tách tiền tố cố định và thêm cache_control: Xác định toàn bộ nội dung cố định sẽ được tái sử dụng (policy hệ thống, mô tả tool, tóm tắt codebase, tài liệu tham chiếu) và gom thành một system block duy nhất. Trong SDK, bạn có thể tạo SYSTEM = [{"type": "text", "text": STATIC_POLICY, "cache_control": {"type": "ephemeral", "ttl": "1h"}}], sao cho cache_control nằm ở cuối phần tiền tố, trước mọi nội dung biến như câu hỏi, timestamp, hay kết quả tool. Đảm bảo tổng tiền tố này vượt ngưỡng token tối thiểu của model (512 token với Fable 5.1) để cache được tạo.
- Bước 2 – Chuyển nội dung biến ra ngoài vùng cache: Mọi thứ thay đổi theo từng request – câu hỏi người dùng, kết quả tool, thời gian – cần được đặt sau phần có cache_control trong payload. Ví dụ, bạn gửi messages = [{"role": "user", "content": [{"type": "text", "text": "Kết quả tool: " + tool_output + "\nCâu hỏi: " + question}]}] cùng với SYSTEM đã cấu hình cache ở trên khi gọi client.messages.create với model Fable 5.1. Làm vậy giúp cache luôn đúng với phần ngữ cảnh cố định, còn nội dung biến được tính phí như bình thường, tránh việc vô tình tạo nhiều cache nhỏ khó tận dụng.
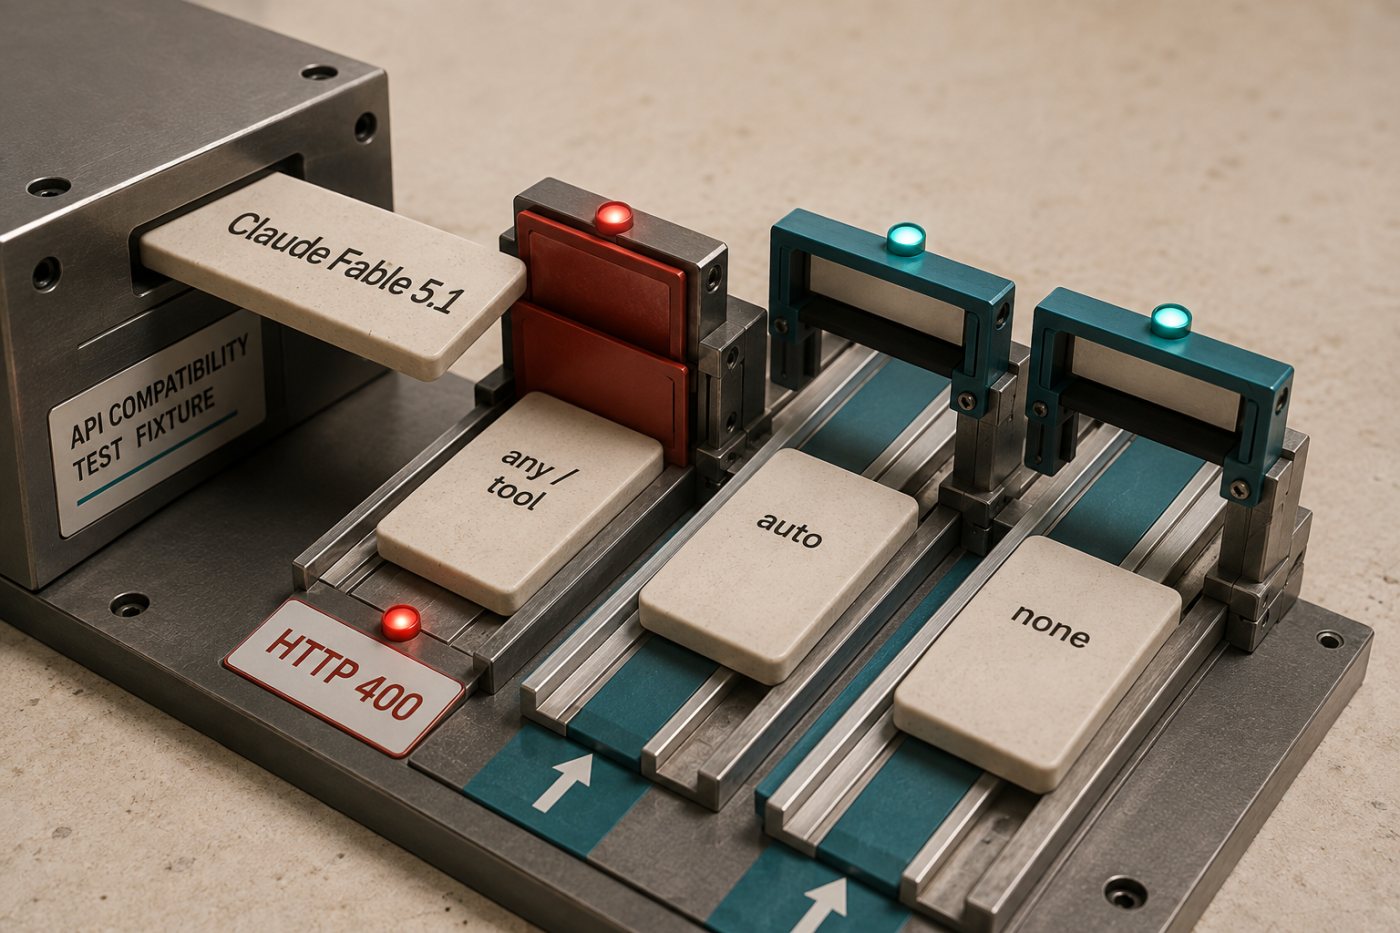
- Bước 3 – Cập nhật model ID và tool_choice tương thích Fable 5.1: Trong môi trường test, đổi ID model sang claude-fable-5-1 và kiểm tra lại mapping ID trên mỗi nhà cung cấp cloud bạn dùng. Sau đó rà toàn bộ payload tìm trường tool_choice, loại bỏ các kiểu any và tool vì Fable 5.1 sẽ từ chối chúng bằng lỗi HTTP 400; chỉ giữ hoặc chuyển sang auto và none sao cho flow gọi tool vẫn đáp ứng yêu cầu ứng dụng. Nếu bạn ép model chọn một tool cụ thể trước đây, giờ cần thiết kế lại theo hướng để model tự quyết, hoặc lập logic chọn tool ở tầng ứng dụng.
- Bước 4 – Kiểm thử với thinking block và lịch sử hội thoại thật: Trước khi chuyển hết traffic, hãy "quay lại" những cuộc hội thoại thực tế có thinking block, bao gồm chuỗi đến từ model cũ, trường hợp fallback sau khi Fable 5.1 trả về lỗi, và lịch sử mà system prompt, tool hoặc message cũ từng bị thay đổi. Với các tài khoản tạo từ 31/08/2026 trở về sau, việc chỉnh sửa system prompt, định nghĩa tool hoặc message cũ có thể khiến thinking block phát lại bị từ chối với lỗi 400. Bạn cần chắc chắn đường đi của thinking block, từ lúc sinh ra đến lúc phát lại, đều hợp lệ trước khi chuyển sang chạy lâu dài.
- Bước 5 – Đo cache hit và tính lại chi phí trên workload dài: Dùng chính payload và lịch sử hội thoại đang chạy trên production để kiểm chứng cache hoạt động. Ghi riêng các trường cache_creation_input_tokens (token dùng để tạo cache), cache_read_input_tokens (token đọc cache), token input mới và token output cho mỗi request để không nhầm giảm giá cache thành giảm giá toàn request. Sau đó tính lại chi phí cho những cuộc hội thoại dài: phân phối token thực tế, TTL bạn chọn, tỷ lệ cache miss, giới hạn output của ứng dụng, cùng số lần retry vì request bị từ chối. Với workload agent có ngữ cảnh ổn định và cache hit cao, bạn sẽ thấy mức giảm chi phí tổng lớn hơn rất nhiều so với các luồng thay đổi prompt liên tục.
Khi thực hiện đúng quy trình, lần gọi đầu tiên tạo cache sẽ hiển thị số token đã ghi trong trường cache_creation_input_tokens, và các lần gọi sau dùng cùng tiền tố sẽ có cache_read_input_tokens lớn hơn 0, chứng tỏ cache đọc đã diễn ra. Đây là dấu hiệu hệ thống caching đã vận hành ổn, bạn có thể tự tin tăng traffic test và bắt đầu chuyển dần sang production mà không bị bất ngờ về chi phí hoặc lỗi tool_choice.
Những lỗi phổ biến khi dùng cache và cách tránh
Hai nhóm lỗi thường làm Claude API caching "mất tác dụng": tiền tố không đủ dài hoặc không thực sự cố định, và cấu hình tool/thinking không tương thích Fable 5.1. Cache của Claude không dùng so sánh ngữ nghĩa mà khớp theo chuỗi bắt đầu giống hệt nhau; thay đổi bất kỳ chữ nào trong system prompt, mô tả tool hoặc block cố định trước cache_control sẽ tạo ra một tiền tố mới và một cache mới, khiến tỷ lệ cache hit giảm mạnh. Nếu team liên tục "tinh chỉnh" prompt trực tiếp trên production, chi phí không giảm bao nhiêu dù đã bật cache. Cách khắc phục là đóng băng phiên bản prompt dùng trong production, mọi thử nghiệm đưa sang môi trường riêng.
Nhóm lỗi thứ hai là liên quan đến tool_choice và thinking block sau khi nâng cấp Fable 5.1. Request vẫn gửi được nhưng bị trả về HTTP 400 nếu bạn giữ kiểu tool_choice là any hoặc tool, hay phát lại thinking block gắn với system prompt hoặc định nghĩa tool đã bị chỉnh sửa. Việc "chỉ đổi model ID mà không đổi payload" có thể khiến cả một nhánh agent dừng lại trước khi suy luận diễn ra. Bạn nên lập checklist migrasi riêng: kiểm tra tất cả tool_choice, chạy lại các chuỗi hội thoại dài, kiểm tra TTL cache có phù hợp nhịp gọi thực tế hay không, rồi mới dám bật cache cho toàn bộ traffic.
Điều nên làm
- Giữ system prompt và mô tả tool ổn định để tối đa cache hit.
- Theo dõi riêng cache_creation, cache_read, token input mới và output trong log chi phí.
Điều nên tránh
- Không dùng cache cho tiền tố dưới ngưỡng token của model.
- Không giữ tool_choice kiểu any hoặc tool khi chuyển sang Fable 5.1.
Khi nào cache thực sự giúp giảm chi phí token cho agent dài hạn?
Lợi ích kinh tế từ Claude API caching không chia đều cho mọi ứng dụng: nó phụ thuộc vào tỷ lệ token đọc lại từ cache so với token mới và token output. Một ví dụ điều kiện cho thấy nếu một lần chạy sử dụng 1 triệu token từ cache, 100 nghìn token input mới và 50 nghìn token output, chi phí thành phần input sẽ thấp hơn đáng kể so với mô hình cũ, nhưng tổng tiết kiệm chỉ khoảng trên 16% vì phần output vẫn chiếm tỷ trọng lớn. Để tiến gần mức giảm 25–45% mà nhà cung cấp ước tính cho workload agent, bạn cần thiết kế luồng sao cho phần ngữ cảnh cố định đọc đi đọc lại trong nhiều bước chiếm đa số trong tổng token input.
Nói theo góc người vận hành: cache hợp với những agent chạy lâu, cần lên kế hoạch, dùng nhiều tool, hoặc phân tích tài liệu, code trên nhiều bước – nơi system prompt, mô tả tool, tóm tắt codebase và bộ tài liệu tham chiếu gần như không đổi từ đầu đến cuối. Ngược lại, nếu bạn chủ yếu phục vụ chat một câu hỏi một câu trả lời, thường xuyên thay prompt hoặc nội dung tài liệu, cache sẽ ít khi được đọc lại đủ nhiều để bù chi phí cache write. Sau vài tuần theo dõi log cache hit và phân phối token trên production, bạn sẽ thấy rõ: với dòng workload đúng, caching Fable 5.1 xứng đáng là một lớp tối ưu chi phí quan trọng; còn với luồng ngắn, linh hoạt, hãy tập trung vào tối ưu nội dung prompt hơn là dựng cache phức tạp.