
Đọc benchmark theo việc bạn cần làm
Benchmark mô hình nhỏ là phép đo hiệu năng trên các tác vụ cụ thể, không phải một thước đo duy nhất đủ để xếp hạng mọi mô hình. Vì vậy, lựa chọn phù hợp phụ thuộc vào công việc: LFM3-1.7B nổi bật ở tác vụ nhiều bước và gọi công cụ theo bảng do Liquid AI công bố; MiniCPM-V 4.7 1B lại dẫn đầu các phép thử thị giác được chia sẻ với LFM3-Omni-2B. Hai kết quả này không mâu thuẫn: chúng so sánh hai cặp mô hình khác nhau, trên những bộ benchmark khác nhau. Với người chọn mô hình AI, kết luận hữu ích không phải “mô hình nào thắng tuyệt đối”, mà là mô hình nào phù hợp với đầu vào, năng lực và giới hạn triển khai của mình.
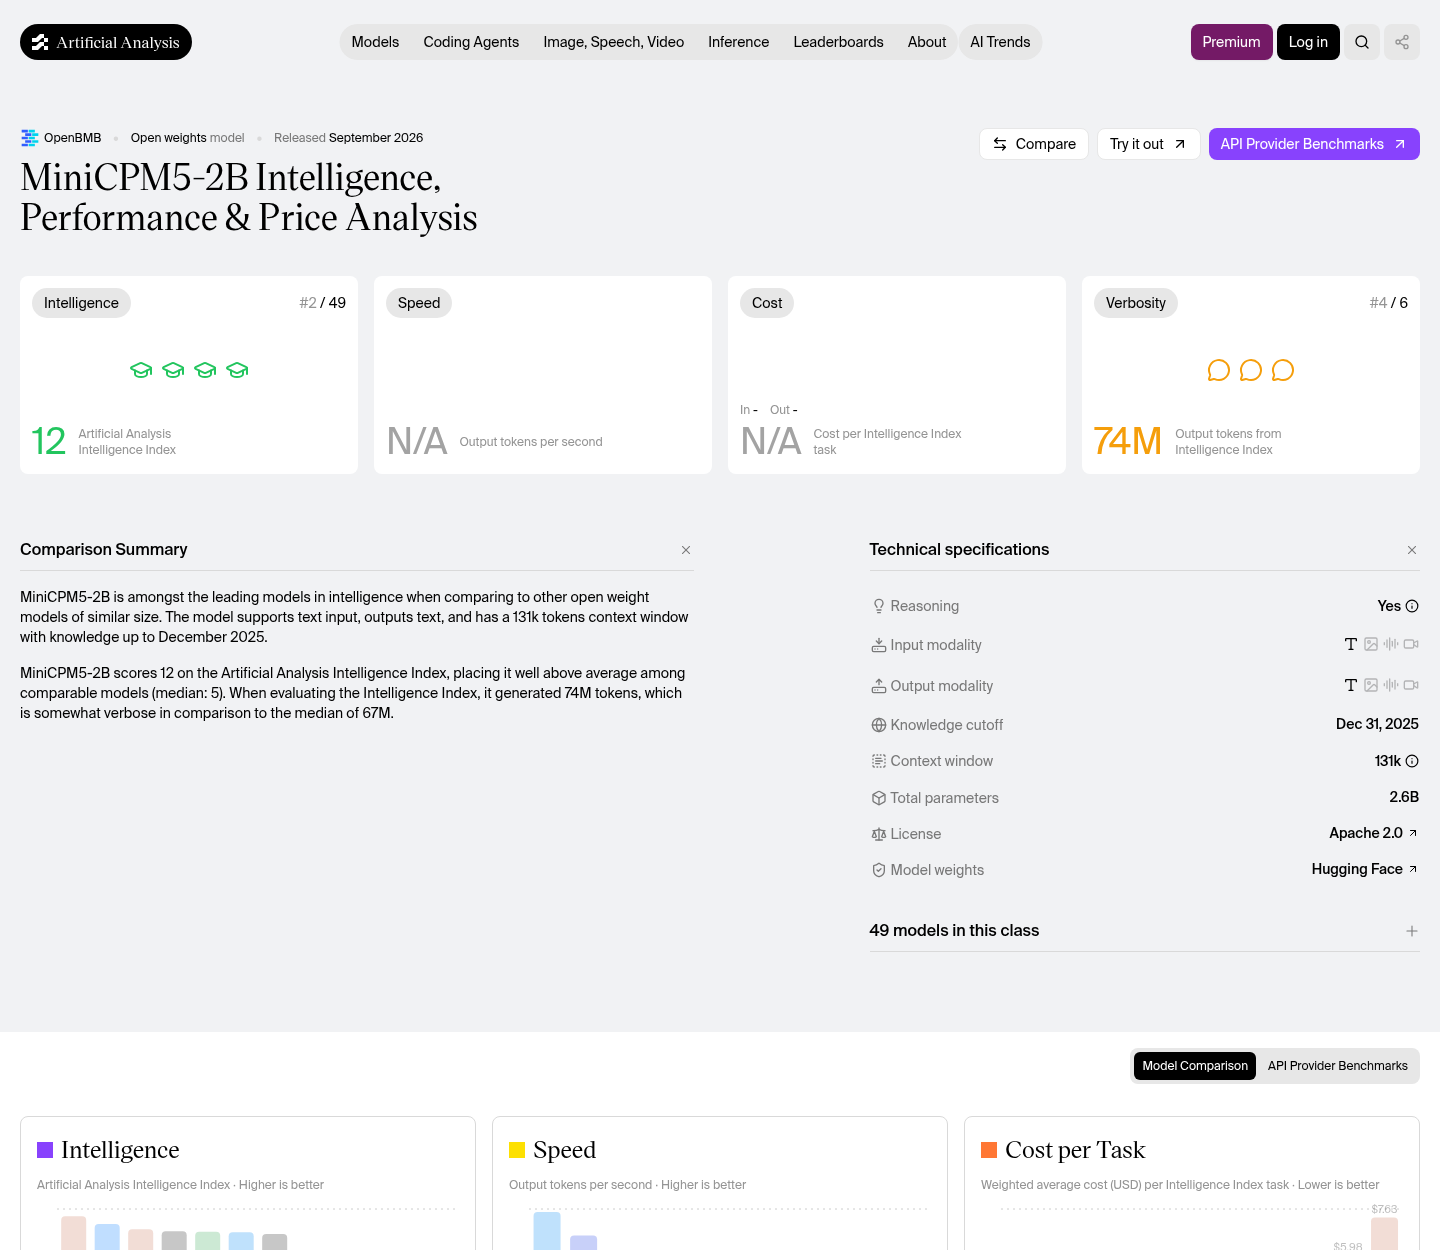
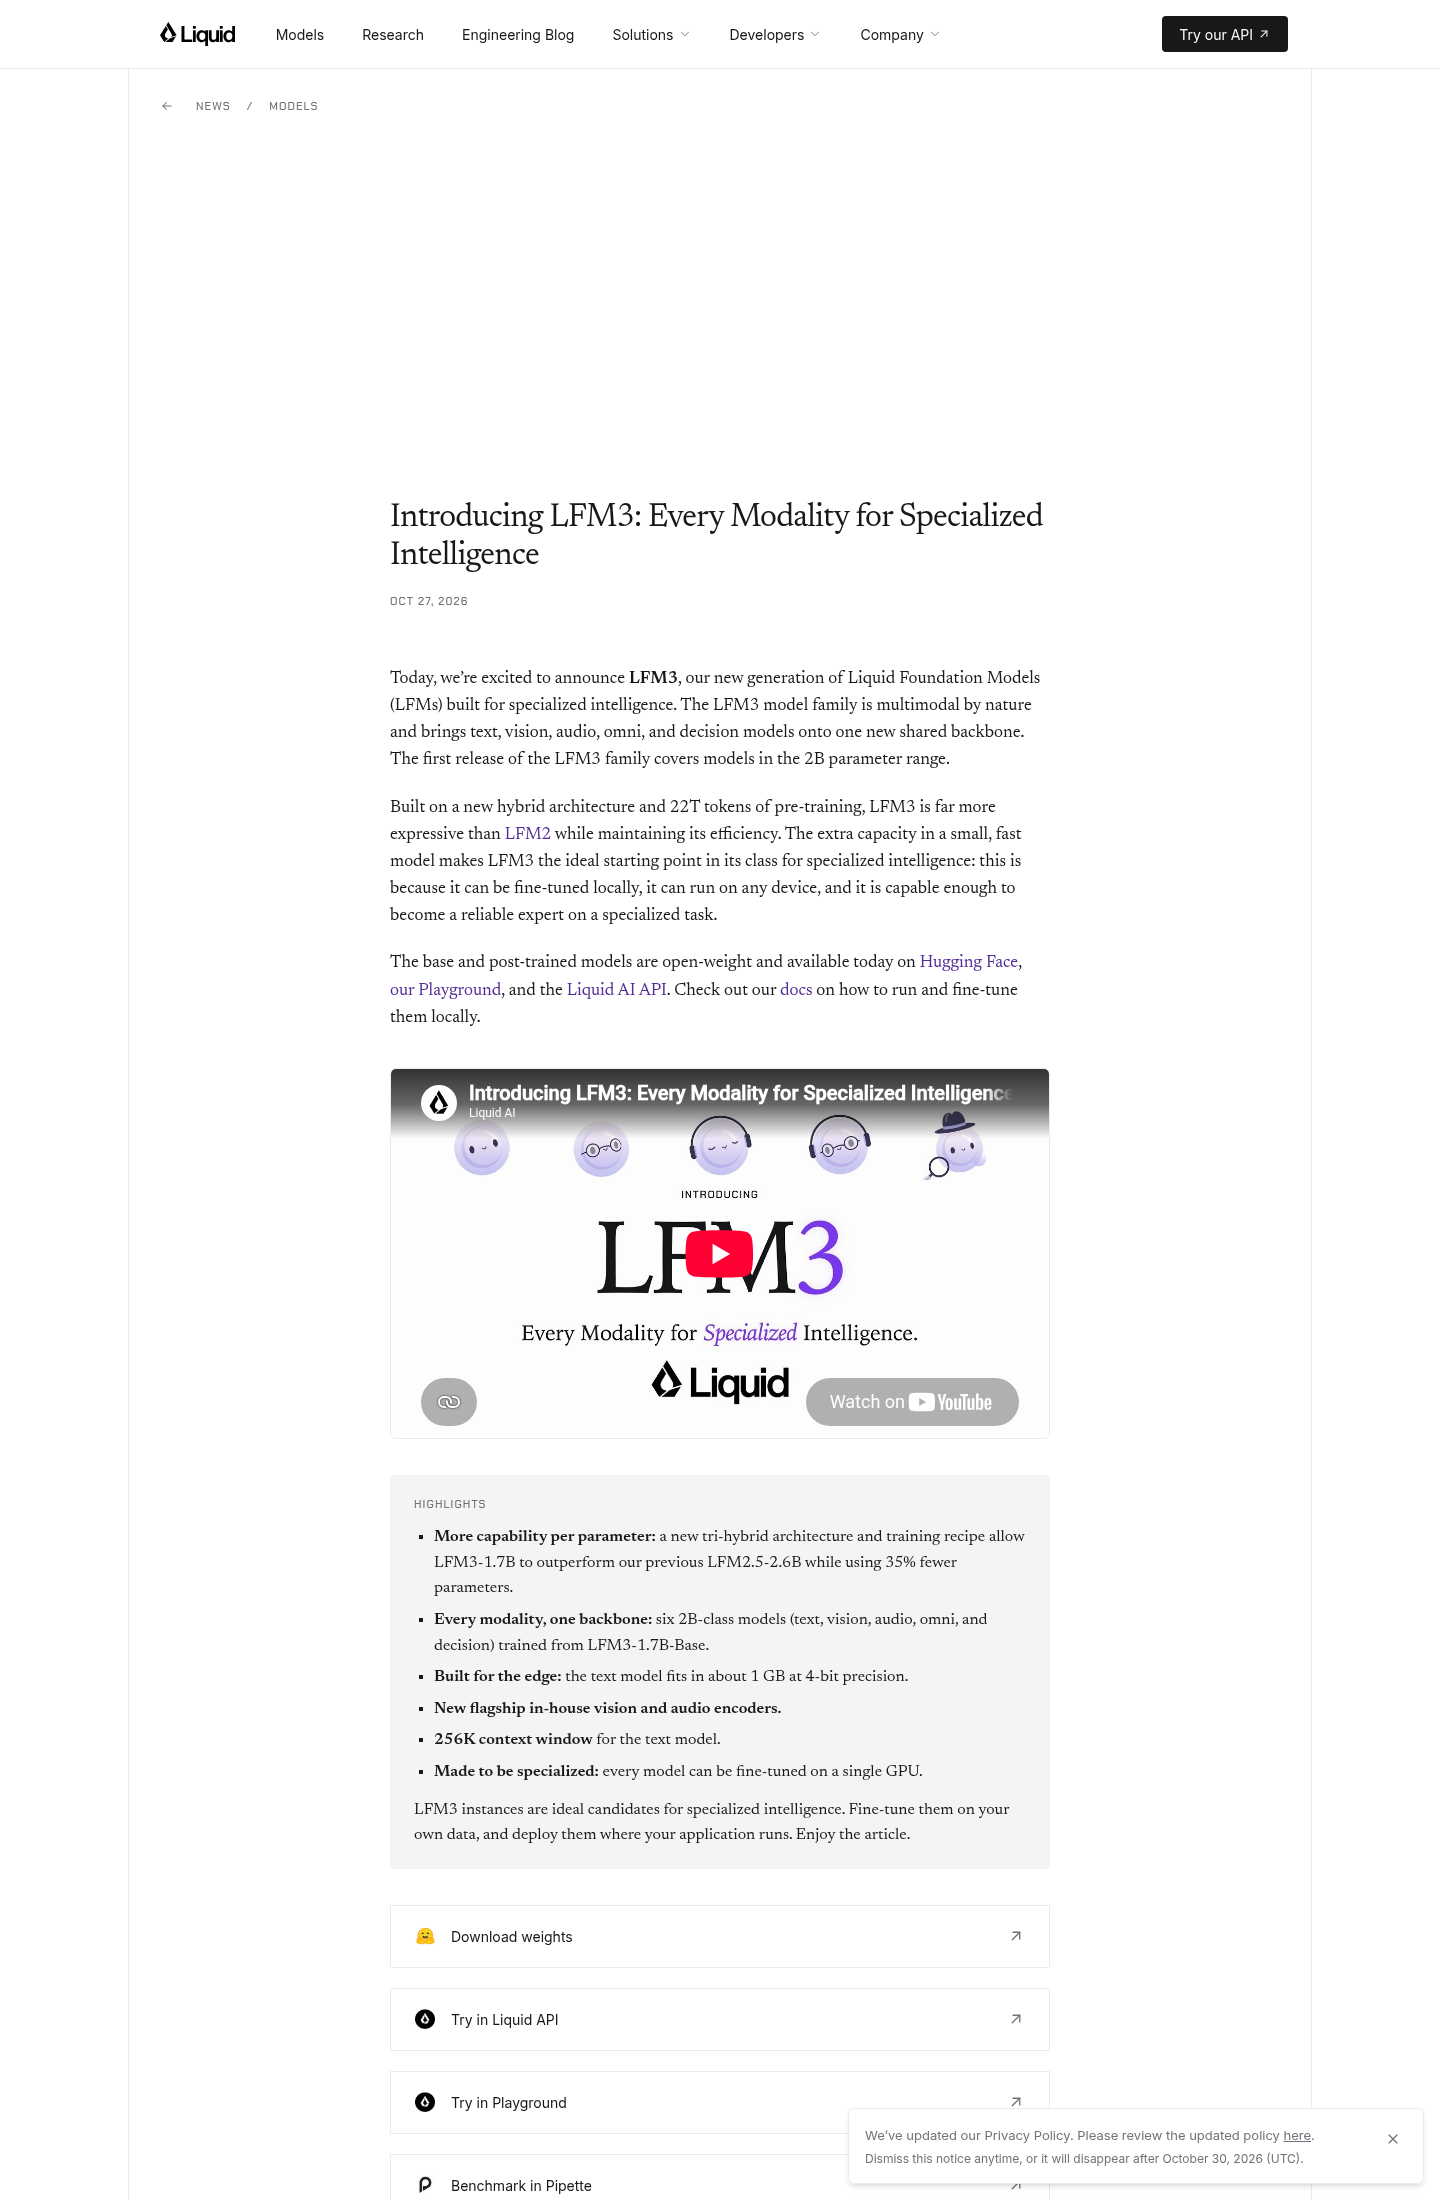
Ngày 27 tháng 10 năm 2026, Liquid AI cho biết LFM3-1.7B thắng 23 trong 27 bài kiểm chuẩn khi đối đầu MiniCPM5-2B; MiniCPM5 thắng bốn bài. Tuy nhiên, bảng điểm do một nhà cung cấp thiết kế và chạy lại cả hai mô hình không tương đương phép thử độc lập. Các bên không công bố đầy đủ cấu hình harness, chính sách thử lại hay cách dựng prompt. Ở SWE-bench Verified, chẳng hạn, số liệu MiniCPM5-2B do Liquid báo cáo là 43,40, trong khi OpenBMB công bố 46,4; đặt các con số từ những quy trình khác nhau cạnh nhau có thể đảo chiều kết luận. Hãy xem 23–4 là tín hiệu đáng chú ý, không phải phán quyết cuối cùng.
LFM3-1.7B thắng ở tác vụ nhiều bước, nhưng không phải mọi bài kiểm
LFM3-1.7B là mô hình văn bản và tác nhân 1,73 tỷ tham số; MiniCPM5-2B là mô hình suy luận dense 2,52 tỷ tham số. Trong bảng của Liquid, khoảng cách đáng kể nhất nghiêng về LFM3 ở những tác vụ tác nhân và ngữ cảnh dài: WebArena-Verified đạt 38,42 so với 9,11, AutomationBench đạt 41,29 so với 4,71, RULER 128K đạt 65,56 so với 37,96, còn BFCL V4 đạt 71,39 so với 62,65. Nếu sản phẩm cần giữ kế hoạch nhiều bước hoặc gọi công cụ, đây là lý do thực tế để thử LFM3-1.7B trước.
Dù vậy, MiniCPM5-2B thắng bốn dòng trong chính bảng đó: τ³-bench đạt 69,44 so với 68,01; GPQA Diamond đạt 65,15 so với 63,37; Humanity’s Last Exam đạt 8,20 so với 7,17; và AA-Omniscience đạt 9,13 so với 7,07. Vì thế, MiniCPM5 có thể hợp hơn với truy xuất tri thức hoặc suy luận một lượt, nhất là khi bạn muốn căn cứ vào các bài kiểm riêng đó thay vì tổng số trận thắng. Lợi thế của LFM3 trên tác vụ dài cũng không xóa được những điểm MiniCPM5 làm tốt; hãy chạy thử trên quy trình thực tế trước khi chọn.
| Hạng mục | LFM3-1.7B | MiniCPM5-2B |
|---|---|---|
| Tham số | 1,73 tỷ | 2,52 tỷ dense |
| WebArena-Verified | 38,42 | 9,11 |
| AutomationBench | 41,29 | 4,71 |
| RULER 128K | 65,56 | 37,96 |
| BFCL V4 | 71,39 | 62,65 |
| Các bài MiniCPM5 thắng trong bảng Liquid | 0 | 4: τ³-bench, GPQA Diamond, HLE, AA-Omniscience |
Trong thị giác, MiniCPM-V 4.7 1B dẫn đầu các bài dùng chung
Đối đầu thị giác là một cặp khác: MiniCPM-V 4.7 1B so với LFM3-Omni-2B. Trên các benchmark thị giác được cả hai công bố, MiniCPM-V dẫn ở cả bốn phép thử: OCRBench đạt 86,1 so với 80,6; MMStar đạt 69,5 so với 55,67; MMMU đạt 56,9 so với 42,44; MathVista đạt 74,3 so với 62,5. Với OCR tài liệu, biểu mẫu, biểu đồ và ảnh chụp màn hình, kết quả này khiến MiniCPM-V 4.7 trở thành lựa chọn đáng ưu tiên hơn trong cặp.
Một phần lợi thế đến từ thiết kế chuyên nhìn: MiniCPM-V nén token thị giác sớm và cho phép chọn mức 4× hoặc 16×; các điểm nổi bật được công bố dùng thiết lập 4×, giữ nhiều chi tiết hơn cho việc đọc tài liệu. Đổi lại, LFM3-Omni-2B phân bổ năng lực cho hình ảnh, âm thanh, video và đầu ra giọng nói; MiniCPM-V không tạo giọng nói. Vì vậy, điểm thị giác không trả lời câu hỏi nào tốt hơn cho tương tác bằng camera và micrô: trong hai mô hình, chỉ LFM3-Omni-2B có thể tham gia cuộc trò chuyện âm thanh với thiết bị. Hãy chọn theo phương thức đầu vào và đầu ra bạn thật sự cần.
Ngữ cảnh cũng làm thay đổi quyết định. MiniCPM-V 4.7 1B hỗ trợ 262.144 token, thường được gọi gọn là 256K; LFM3-Omni-2B hỗ trợ 32.768 token. Khoảng cách này có ý nghĩa với PDF dài hoặc hội thoại nhiều lượt, nhưng không thay thế đánh giá chất lượng ở từng tác vụ. Cần đọc cả cách tính tham số: MiniCPM-V được quảng bá là mô hình 1B, song số tham số dense ước tính khoảng 1,3–1,55 tỷ tùy cách tính tháp thị giác. Do cả hai bộ số đều do nhà cung cấp công bố, hướng chênh lệch có thể hữu ích hơn độ lớn chính xác; nên kiểm chứng bằng dữ liệu của chính bạn.
Buy if / Skip if
Hai cuộc so sánh này giúp khoanh vùng lựa chọn, chứ không tạo ra một bảng xếp hạng tổng thể. Kết quả thị giác của MiniCPM-V 4.7 không thể dùng để kết luận về MiniCPM5-2B; tương tự, chiến thắng 23–4 của LFM3-1.7B không nói lên rằng LFM3-Omni-2B sẽ thắng tác vụ nhìn. Cặp mô hình, bộ benchmark và quy trình đo đều khác nhau. Dùng các con số để xác định ứng viên cần thử, rồi kiểm tra trên tác vụ, phần cứng và dữ liệu của bạn.
- Buy the LFM3-1.7B if bạn cần tác vụ nhiều bước, gọi công cụ hoặc xử lý tài liệu dài và muốn ưu tiên kết quả RULER, WebArena hay AutomationBench đã công bố.
- Skip the LFM3-1.7B if công việc chính là OCR và đọc hình ảnh; trong cặp thị giác, MiniCPM-V 4.7 1B đạt điểm cao hơn trên các benchmark dùng chung.
- Buy the MiniCPM5-2B if bạn ưu tiên các bài suy luận một lượt hoặc truy xuất tri thức mà mô hình thắng trong bảng Liquid, và muốn đánh giá nó riêng trên quy trình của mình.
- Skip the MiniCPM5-2B if yêu cầu trọng tâm là nhiều bước dài hoặc tự động hóa bằng công cụ; số liệu tác nhân được nêu nghiêng mạnh về LFM3-1.7B.
- Buy the MiniCPM-V 4.7 1B if bạn cần đọc tài liệu, OCR, phân tích biểu đồ hoặc ngữ cảnh 256K, đồng thời chỉ cần đầu ra văn bản.
- Skip the MiniCPM-V 4.7 1B if bạn cần mô hình xử lý âm thanh và trả lời bằng giọng nói; hãy cân nhắc LFM3-Omni-2B, mô hình duy nhất trong cặp có năng lực đó.