
AI video call là gì và vì sao Griffin gây chấn động?
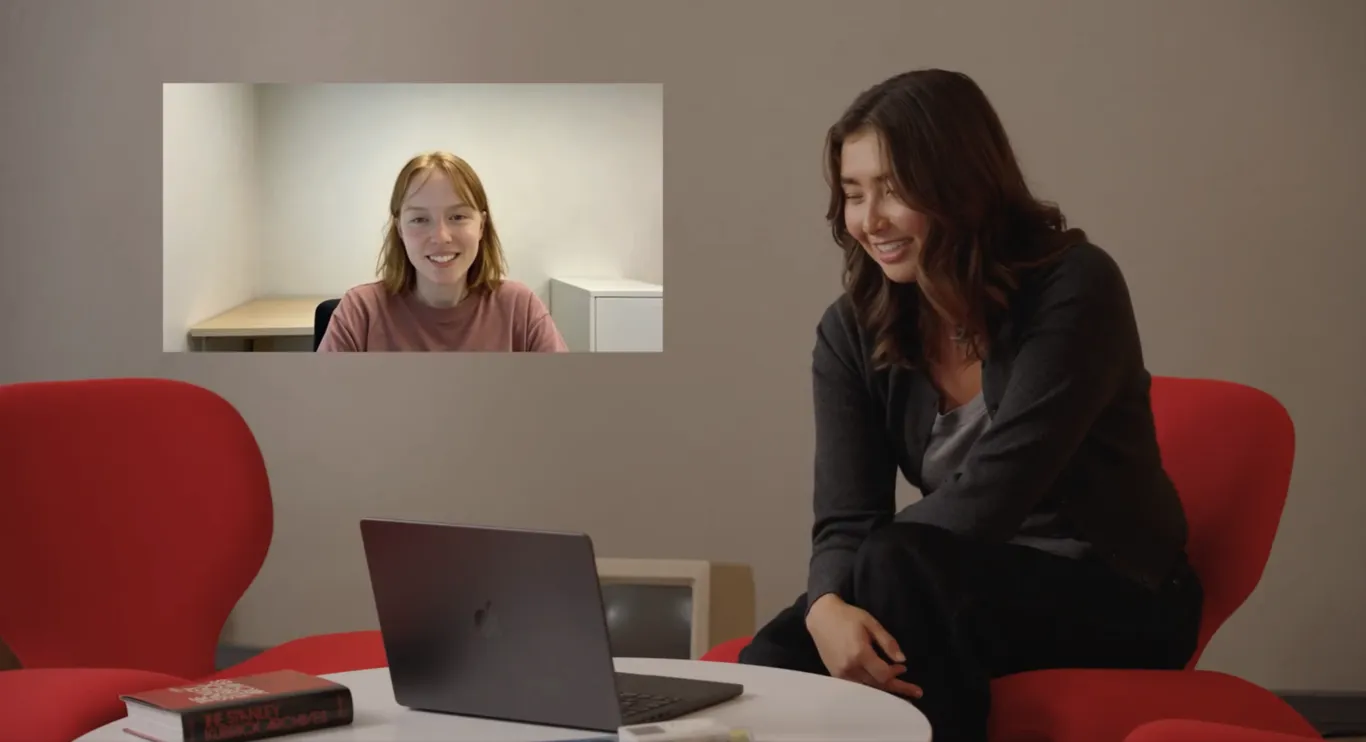
AI video call là hình thức tương tác trong đó một hệ thống trí tuệ nhân tạo xuất hiện trên video, nghe, hiểu và đáp lại người dùng theo thời gian thực bằng giọng nói, hình ảnh khuôn mặt và cử chỉ giống con người, khiến người đối diện khó phân biệt đây là máy hay người thật. Khi Tavus công bố Griffin AI – cụ thể là bản Griffin-Lite – nhiều người bất ngờ vì mô hình này đã đánh lừa được 26 trên 54 người tham gia trong các cuộc gọi video kéo dài một phút, khiến họ tin rằng đang nói chuyện với một con người thật. Công ty xem đây là mô hình đầu tiên vượt qua “bài kiểm tra Turing qua video” trong thời gian thực. Câu hỏi quan trọng không còn là “AI có thông minh không”, mà là “liệu chúng ta còn nhận ra ai đang ở đầu dây bên kia hay không?”.
Griffin AI Tavus vượt bài kiểm tra Turing video như thế nào?
Thí nghiệm với Griffin-Lite được thiết kế giống một cuộc trò chuyện đời thường: 54 người được mời nói chuyện video 1 phút với một “người lạ” về những điều họ mong chờ trong năm tới. Họ không được báo trước rằng đó có thể là AI, chỉ đánh giá độ tự nhiên, tin cậy và trôi chảy, rồi mới trả lời liệu đối phương là người hay máy. Kết quả: 26 người – tương đương 48% – tin rằng họ đã nói chuyện với người thật. Ở một thử nghiệm tương tự với hệ thống cũ của Tavus, chỉ 1 trên 41 người bị đánh lừa. Một câu nói có thể trích dẫn ở đây là: “48% người tham gia tin rằng Griffin-Lite là người thật sau một phút trò chuyện video call”. Đây không phải bài kiểm tra Turing kinh điển vốn chỉ dùng văn bản, nhưng nó cho thấy mức độ “khó phân biệt” mới trong tương tác video.

Bí mật phía sau sự tự nhiên: full-duplex, đa phương thức và khuôn mặt biết diễn
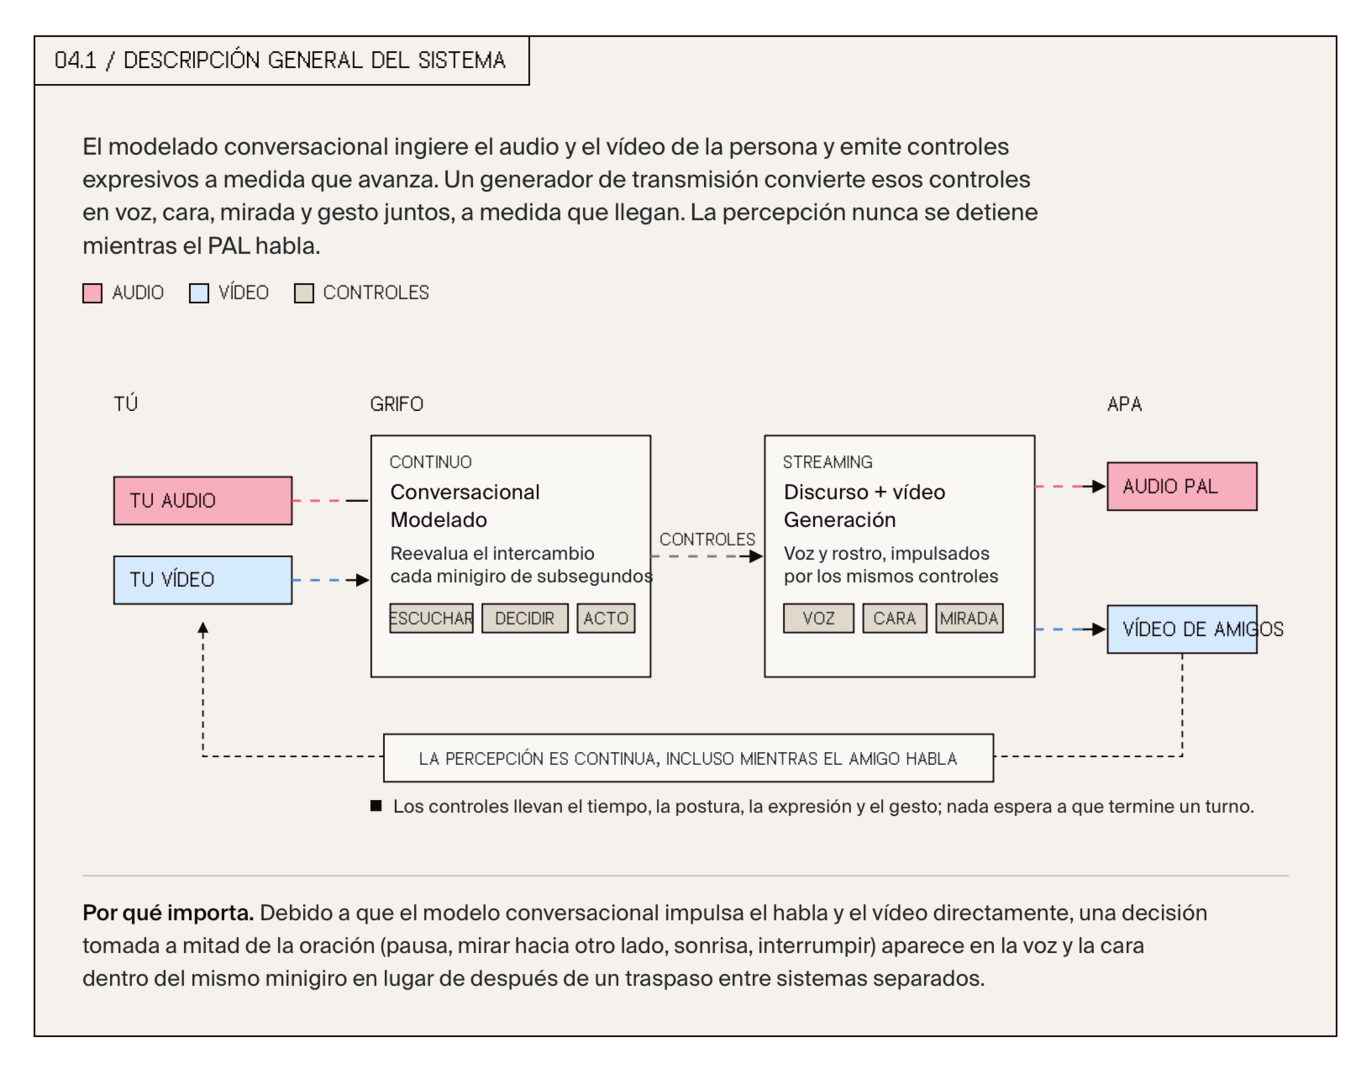
Điểm then chốt khiến Griffin trở nên thuyết phục là kiến trúc full-duplex – vừa nói, vừa nghe, vừa quan sát cùng lúc. Thay vì đợi bạn nói xong rồi mới phản hồi, hệ thống liên tục đánh giá lại cuộc hội thoại ở các lát cắt nhỏ hơn một giây, kết hợp lời nói với tín hiệu phi ngôn ngữ. Điều này cho phép Griffin gật đầu, thốt lên những tiếng “ừm-hừm” ngay khi bạn còn đang nói, hiểu một khoảng ngập ngừng là đang suy nghĩ chứ không phải kết thúc lượt lời, hoặc để bạn ngắt lời rồi vẫn tiếp tục mạch trò chuyện. Đây chính là video interaction AI đa phương thức: xử lý đồng thời văn bản ẩn trong ngôn ngữ nói, hình ảnh video bạn đang chia sẻ lên camera, cùng âm thanh và ngữ điệu. Tavus cho biết giọng nói Griffin-Lite có độ trễ tương đương thoại thực tế và có thể sao chép giọng từ khoảng 10 giây âm thanh, khiến trải nghiệm càng khó phân biệt.
Từ benchmark NVIDIA đến đời sống: AI video call sẽ làm gì cho chúng ta?
Griffin-Lite không chỉ gây ấn tượng trong phòng thí nghiệm của Tavus. Mô hình này được đưa vào VideoFDB của NVIDIA – một bộ đo lường dựa trên 237 đoạn videollamada thực với 11 kiểu tương tác khác nhau. Griffin đạt 3,83/5 điểm ở khả năng tạo hội thoại video, trong khi video của con người đạt 3,92 điểm, còn hệ thống kế tiếp (kết hợp Gemini 2.5 và Anam) chỉ đạt 2,80 điểm. Điều đó cho thấy AI này đã ở rất gần mốc “tự nhiên như người” theo đánh giá của mô hình chấm điểm. Ứng dụng mà Tavus nhắm tới khá rõ: bán hàng, đào tạo và chăm sóc khách hàng, nơi một video interaction AI có thể tư vấn, giải thích hoặc huấn luyện 24/7. Nếu triển khai rộng, đây có thể là trợ lý đào tạo nội bộ, nhân viên hỗ trợ khách hàng hay MC ảo trong giải trí. Nhưng chính sự “thuyết phục” này khiến rủi ro đạo đức phình to: từ quảng cáo quá mức cá nhân hóa cho tới thao túng cảm xúc người dùng.
Lằn ranh lừa dối và xác thực: chúng ta cần chuẩn bị gì?
Griffin-Lite hiện chỉ là phiên bản nghiên cứu, mở cho một nhóm người dùng được chọn, chưa cung cấp cho khách hàng đại trà. Tavus nói họ đang phát triển các tính năng cảnh báo và hợp tác với các tổ chức an toàn AI trước khi phát hành rộng rãi hơn, vì chính những gì làm cho Griffin tự nhiên cũng khiến người dùng quên rằng mình đang nói chuyện với máy. Ở cấp độ quy định, một số khu vực yêu cầu hệ thống tương tác trực tiếp phải thông báo rõ ràng cho người dùng rằng họ đang nói chuyện với AI, trừ khi điều đó đã quá hiển nhiên. Còn với người dùng bình thường, hệ quả thực tế là nếu các mô hình như Griffin trở nên phổ biến, việc nhìn thấy một gương mặt quen trên màn hình video call sẽ không còn là bằng chứng xác thực về người ở đầu dây bên kia nữa. Điều chúng ta cần không chỉ là công cụ xác minh, mà còn là “văn hóa hoài nghi lành mạnh”: đặt câu hỏi, yêu cầu xác thực đa bước khi cần và chấp nhận rằng trong kỷ nguyên AI video call, cảm giác “tôi nhìn thấy nên tôi tin” đã lỗi thời.