
Claude API caching là gì và vì sao doanh nghiệp nên quan tâm?
Claude API caching là cơ chế lưu lại phần ngữ cảnh đầu vào cố định đạt một ngưỡng tối thiểu token, sau đó tái sử dụng lại bằng cache_control để những lần gọi sau chỉ trả phí đọc rẻ hơn nhiều so với token đầu vào thông thường, giúp giảm đáng kể chi phí cho các quy trình xử lý tài liệu lặp lại và tác vụ agent dài, nơi cùng một hệ thống policy, tóm tắt repository hay bộ tài liệu tham chiếu được dùng đi dùng lại.
Luận điểm quan trọng: Claude API caching không phải “bật lên là rẻ”. Nếu doanh nghiệp không hiểu rõ ngưỡng token tối thiểu, cách đặt cache_control và tần suất tái sử dụng, hệ thống rất dễ rơi vào trạng thái vừa không giảm chi phí token, vừa thêm độ phức tạp. Claude API yêu cầu phần tiền tố (prefix) cố định phải vượt qua ngưỡng tối thiểu khác nhau theo từng model; nếu không, yêu cầu vẫn chạy bình thường nhưng hoàn toàn không có cache nào được tạo. Điều này khiến nhiều đội ngũ tưởng rằng mình đã “tối ưu hóa chi phí AI”, trong khi thực tế mọi lời gọi vẫn tính giá như cũ.
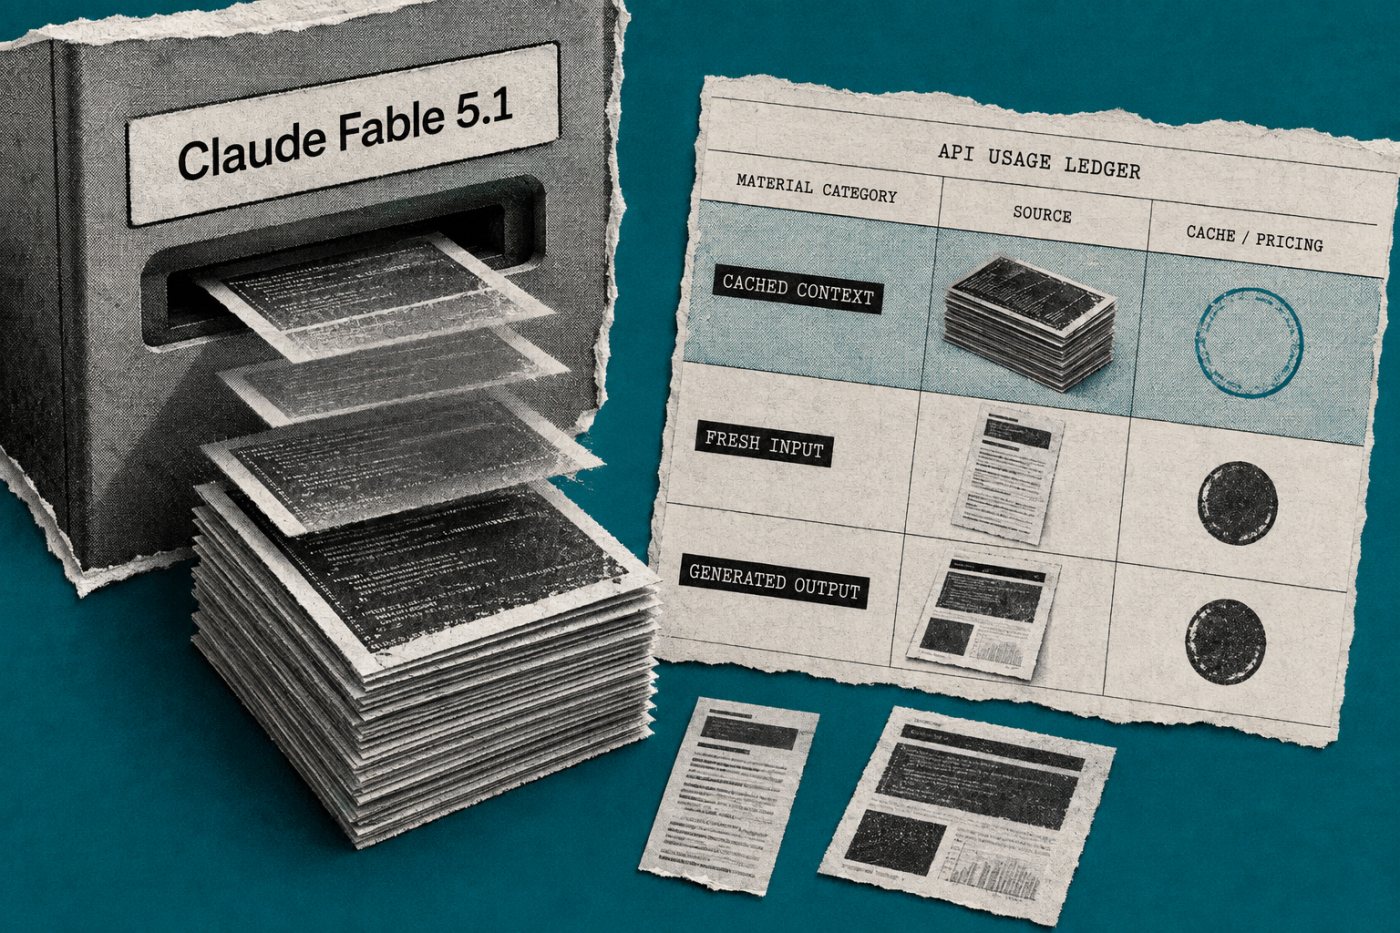
Cách Claude API caching hoạt động: ngưỡng token và cache_control
Về mặt kỹ thuật, Claude API caching dựa trên tiền tố đầu vào giống hệt nhau, không dựa trên “tương đồng ngữ nghĩa” hay bất kỳ phép so sánh mờ nào; hệ thống chỉ khớp lại cùng chuỗi bắt đầu. Để kích hoạt, phần tiền tố cố định cần được đặt cache_control ở đúng vị trí: đây là ranh giới mà mọi nội dung phía trước phải giữ nguyên, trong khi nội dung phía sau (câu hỏi người dùng, kết quả tool, timestamp…) được coi là phần hậu tố biến đổi. Một triển khai điển hình với Python SDK là tạo SYSTEM chứa STATIC_POLICY kèm cache_control với ttl mong muốn, rồi gửi messages của người dùng phía sau.
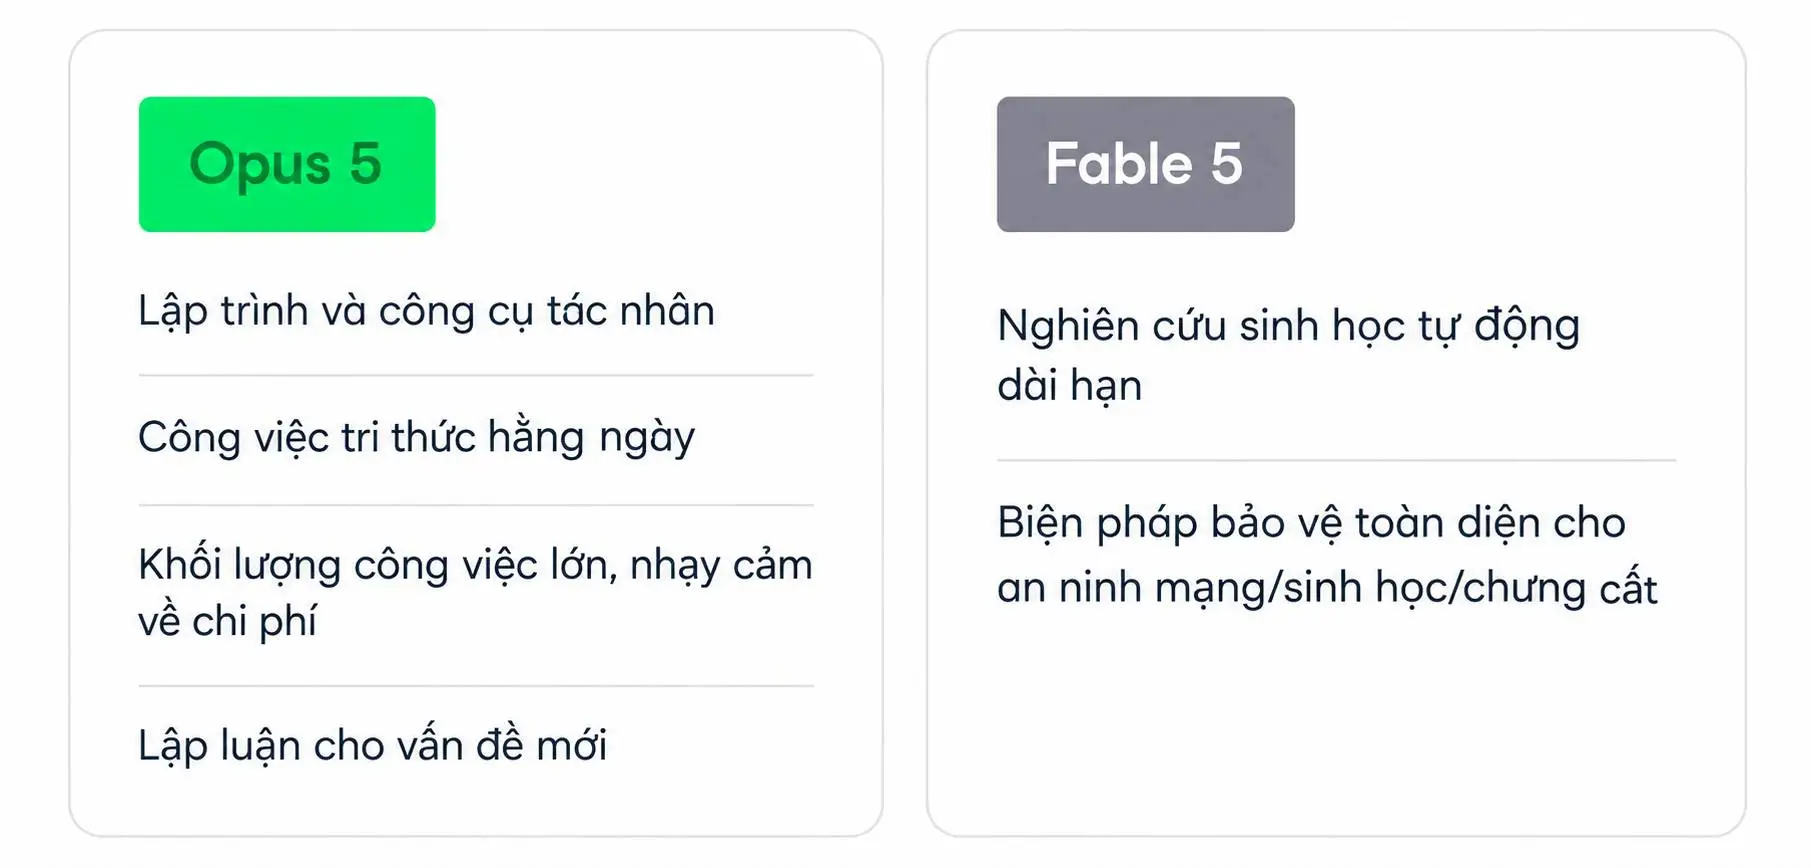
Điểm nhiều nhóm bỏ qua là ngưỡng token tối thiểu theo từng model. Tài liệu cho biết Claude Fable 5.1, Mythos 5.1, Opus 5 và Fable 5 yêu cầu ít nhất 512 token; Opus 4.8, Sonnet 5, Sonnet 4.6 và Sonnet 4.5 cần 1.024; Opus 4.7 là 2.048; còn Opus 4.6, Opus 4.5 và Haiku 4.5 cần tới 4.096 token trong phần tiền tố để được cache. Nếu doanh nghiệp chỉ gửi một system prompt khoảng vài trăm token cho Sonnet 4.6, cache sẽ không bao giờ hình thành dù đã thêm cache_control, nhưng API cũng không báo lỗi — một cái bẫy khó nhận ra nếu không đo lường kỹ cache_creation_input_tokens và cache_read_input_tokens.
Giảm chi phí token tới 90%: hiểu đúng bài toán break-even
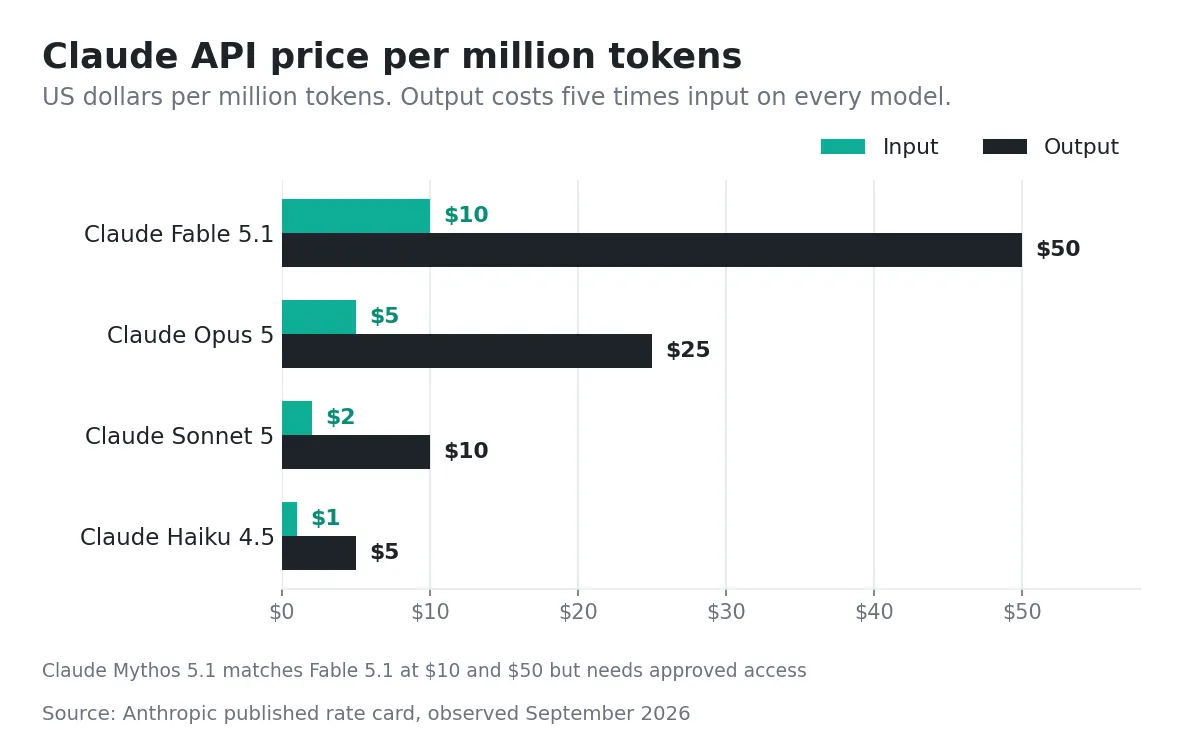
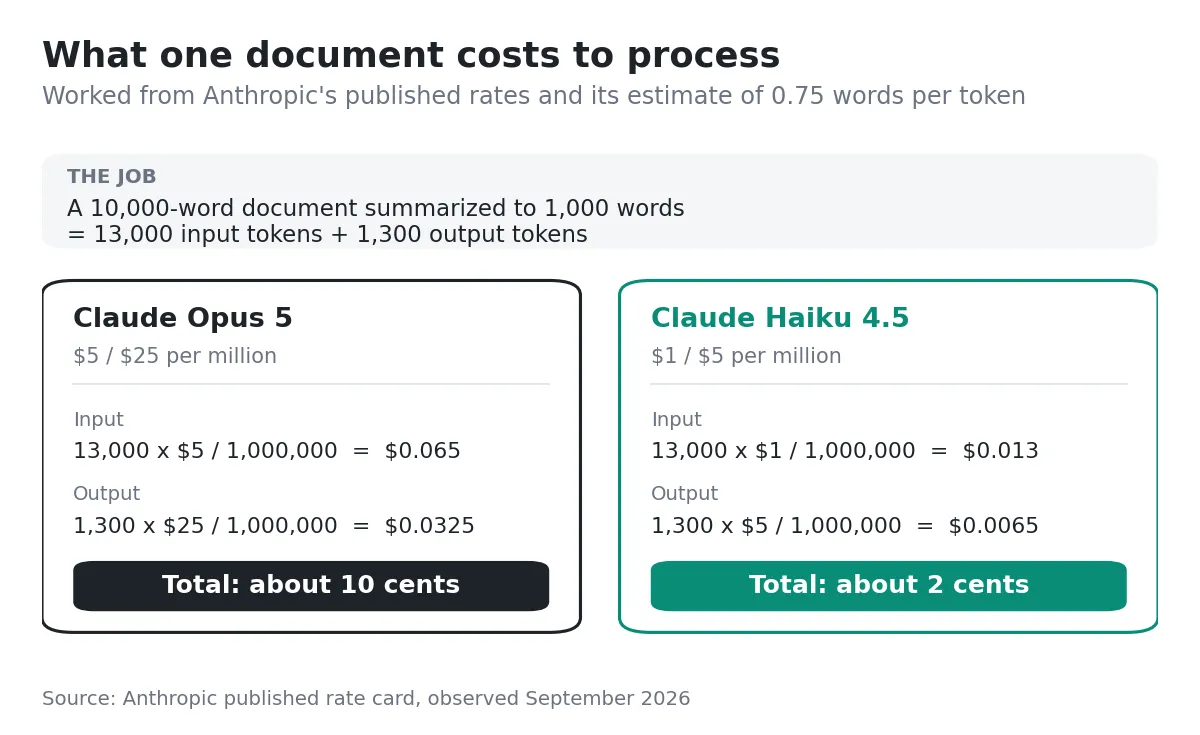
Lợi ích kinh tế của Claude API caching nằm ở chỗ token đọc từ cache rẻ hơn rất nhiều so với token đầu vào chuẩn: bảng giá chính thức cho thấy phí đọc cache thường chỉ bằng 0,1 lần giá token input tiêu chuẩn, tức giảm 90% cho phần được tái sử dụng. Với Claude Fable 5.1, phí đọc cache còn được giảm thêm so với Fable 5, khi chi phí đọc cache giảm 75% so với phiên bản trước. Nhờ vậy, các workflow xử lý tài liệu nặng có cùng phần ngữ cảnh lớn (ví dụ tài liệu tham chiếu 10.000 token) có thể cắt mạnh chi phí khi đọc lại nhiều lần.
Tuy nhiên, cache không miễn phí: ghi cache trong 5 phút thường có hệ số 1,25 so với token input thường, còn ghi cache 1 giờ là 2 lần, trong khi đọc cache là 0,1 lần. Nếu gọi N lần với cùng một tiền tố C token, chi phí không caching là N × C × P; với cache 5 phút là C × P × [1,25 + 0,1 × (N−1)], còn với 1 giờ là C × P × [2 + 0,1 × (N−1)]. Phân tích này cho thấy với TTL 5 phút, chỉ cần một lần đọc (tức tổng cộng hai lần gọi) đã bắt đầu tiết kiệm; còn TTL 1 giờ cần ít nhất hai lần đọc mới hoà vốn. Trong ví dụ với 10.000 token tiền tố trên Sonnet 4.6, chỉ riêng phần prefix đã tiết kiệm hơn 30% khi dùng cache 5 phút so với không cache.
Claude Fable 5.1 và lợi thế cho tác vụ agent dài
Claude Fable 5.1 được thiết kế cho các tác vụ agent nhiều bước, kéo dài hàng giờ và trải trên nhiều ứng dụng, nơi cùng một bundle ngữ cảnh được đọc lại liên tục. Điểm khác biệt kinh tế của Fable 5.1 không nằm ở giá token input hay output, mà ở việc phần ngữ cảnh đã xử lý và được cache sẽ được đọc lại với mức phí thấp hơn đáng kể. "Phí đọc cache giảm 75% so với Fable 5" là một con số rất đáng chú ý cho mọi workflow agent nặng.
Trong các kịch bản như phát triển tính năng trên toàn codebase, review hiệu năng, nghiên cứu chuyên sâu hay phân tích chuỗi tài liệu doanh nghiệp, hệ thống thường phải lặp lại cùng một tập policy, summary repository hoặc tài liệu tham chiếu qua hàng chục bước agent. Khi đó, tỷ lệ token đọc từ cache so với token input mới càng lớn, mức giảm chi phí thực tế càng tiến gần các mức ước tính mà nhà cung cấp ghi nhận cho workload agent dày đặc. Nhưng doanh nghiệp không thể chỉ dựa vào con số trung bình: cần đo chi tiết tỷ lệ token mới, token cache và token output trong thực tế để quyết định TTL, cấu trúc prompt và mức tối ưu hóa chi phí AI hợp lý cho mỗi pipeline.
Sai lầm phổ biến và cách cấu hình cache cho xử lý tài liệu nhanh
Hai sai lầm phổ biến nhất khi triển khai Claude API caching là: một, coi cache như tìm giống nhau theo nghĩa mà quên rằng hệ thống chỉ khớp chính xác chuỗi bắt đầu; bất kỳ thay đổi nào trong đoạn system hay định nghĩa tool trước cache_control đều tạo ra tiền tố mới. Hai, không kiểm tra xem tiền tố có vượt ngưỡng token tối thiểu của model hay không, dẫn đến cache không bao giờ được tạo dù mọi thứ “trông có vẻ đúng”. Một số nhóm còn cố gắng nhồi thêm văn bản vô nghĩa để đủ ngưỡng token, thay vì gom các policy, ví dụ, định nghĩa công cụ và tài liệu tham chiếu cần thiết vào một tiền tố ổn định — cách làm này bị khuyến cáo là không nên.
Để tránh lãng phí token ở các prompt ngắn, doanh nghiệp nên chấp nhận rằng không phải lời gọi nào cũng cần cache: nếu trong 5 phút không có ít nhất một lần đọc, hoặc trong 1 giờ không có ít nhất hai lần đọc, chi phí ghi cache sẽ không tự bù lại. Cách cấu hình hợp lý cho xử lý tài liệu nhanh là tách rõ phần system/tool ổn định (đặt cache_control ở cuối) và phần messages biến đổi, đảm bảo mọi tài liệu cần lặp lại đều nằm trước ranh giới cache. Khi áp dụng đúng, các đánh giá độc lập trên hơn 500 phiên agent với system prompt 10.000 token cho thấy chi phí API có thể giảm từ 41% đến 80% và thời gian đến token đầu tiên giảm 13% đến 31%, một mức cải thiện khó bỏ qua cho bất kỳ stack AI doanh nghiệp nào.