
M3.1 Flash là gì và vì sao đây là bước ngoặt về chi phí
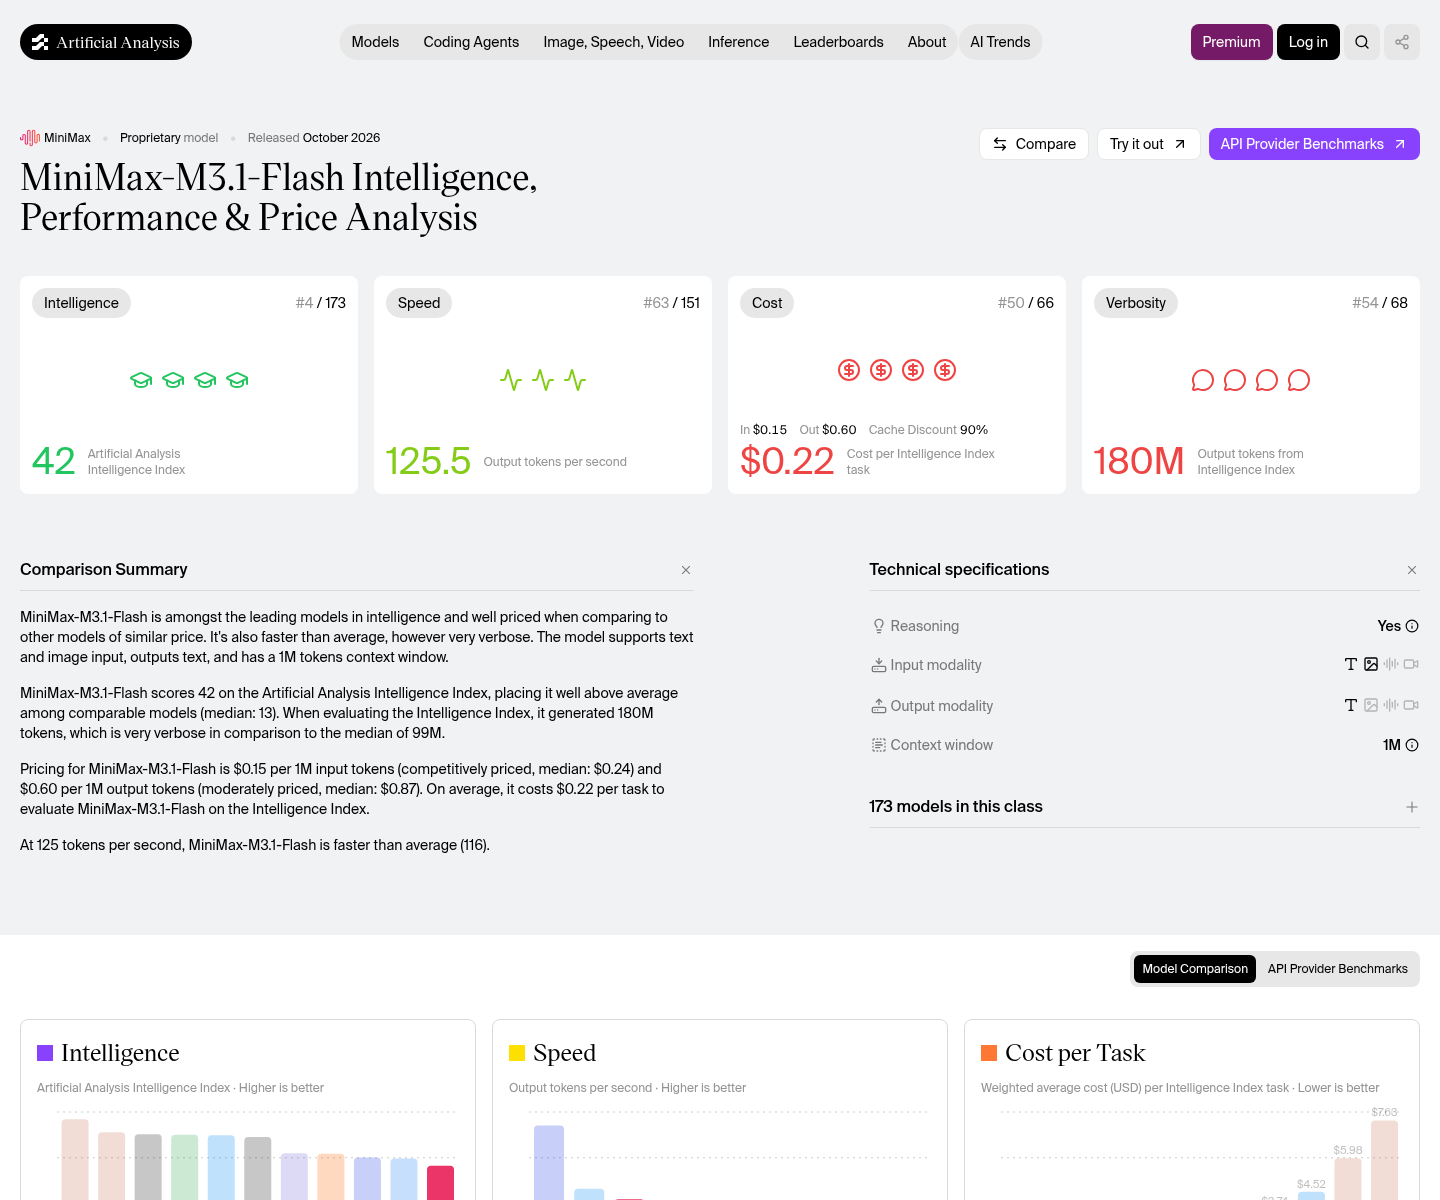
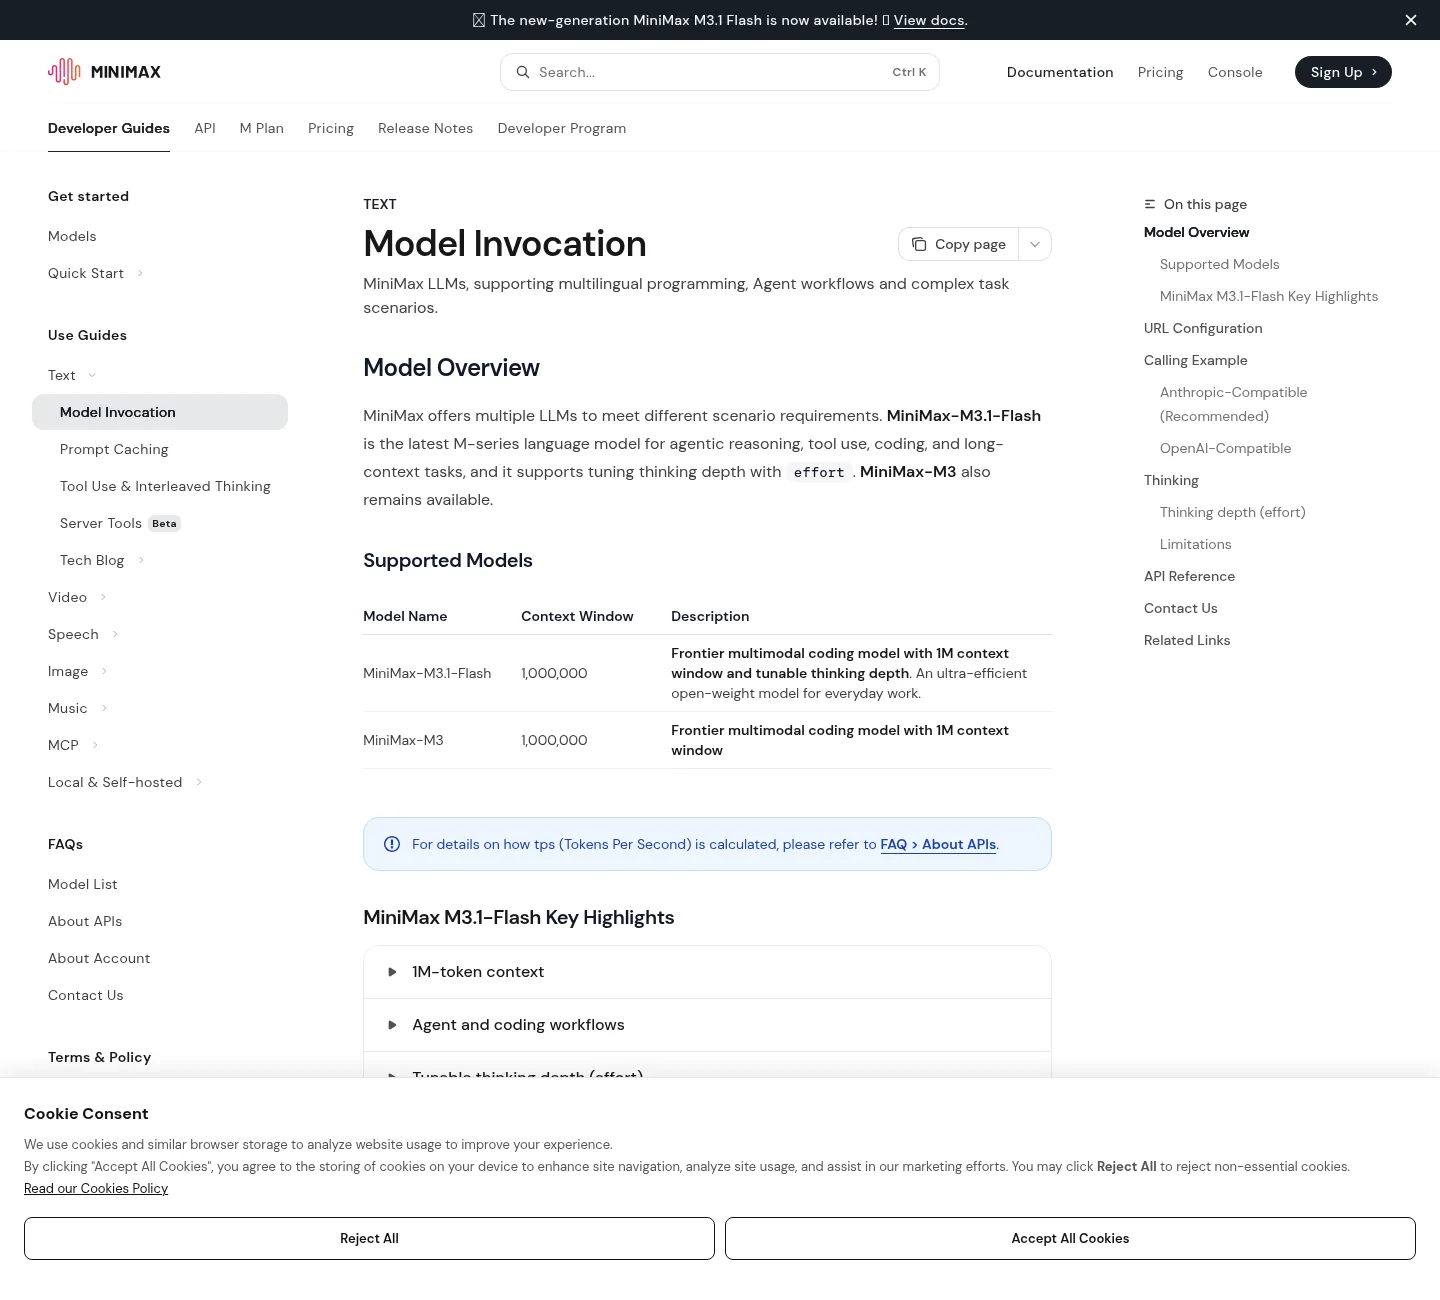
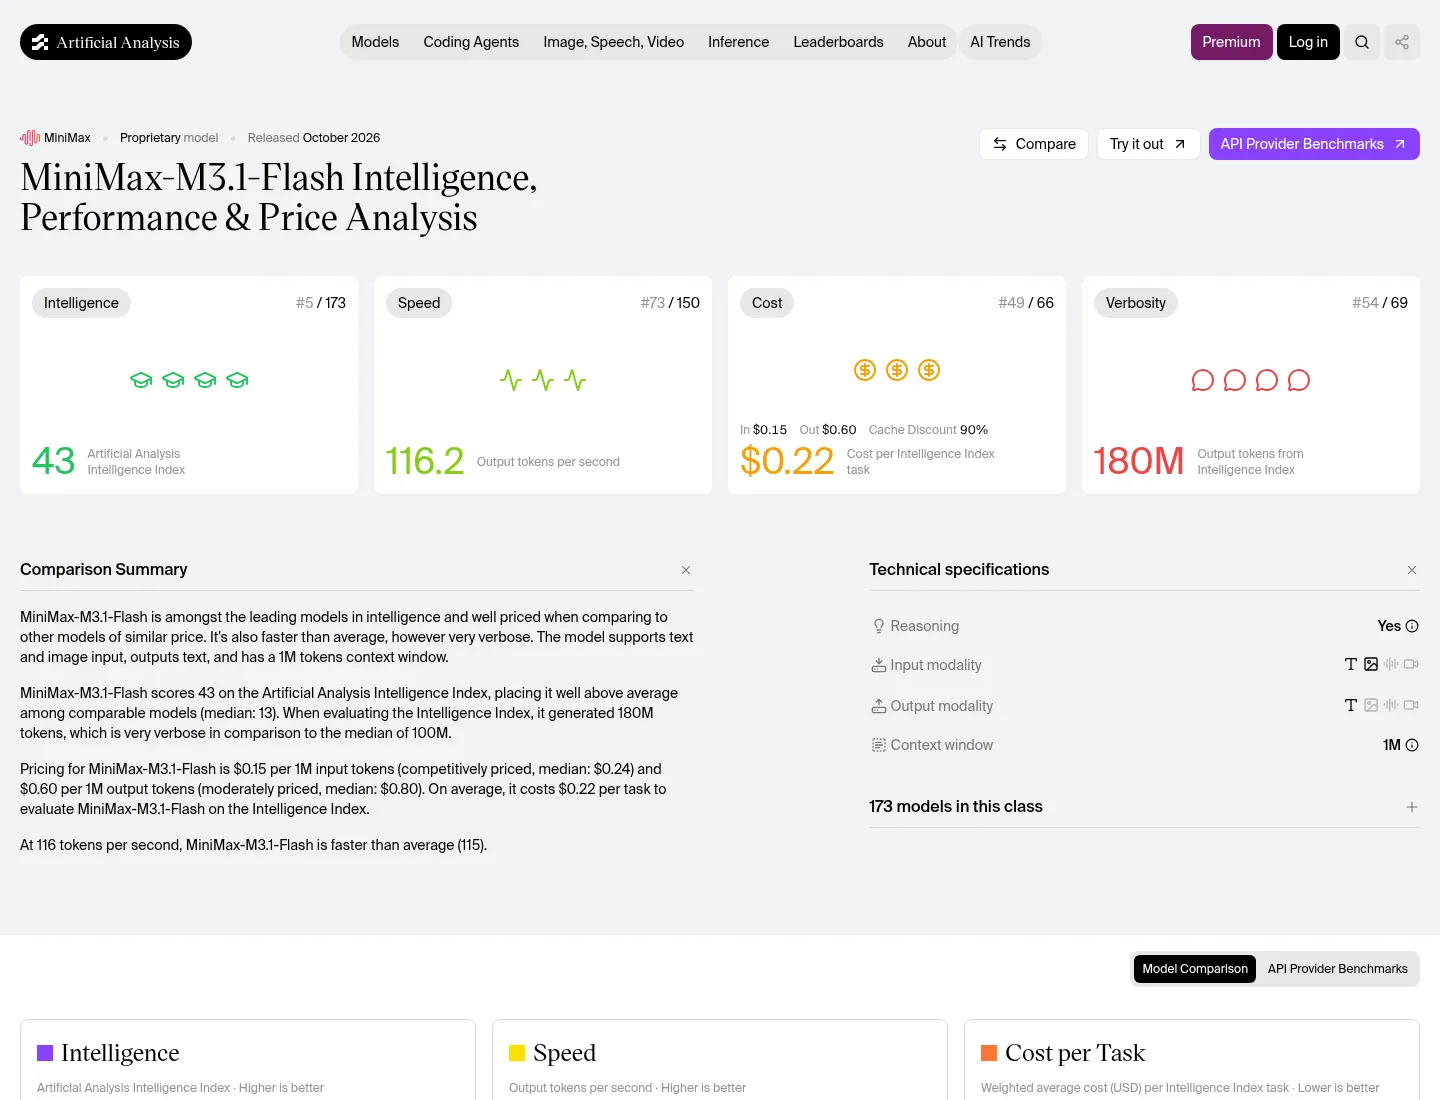
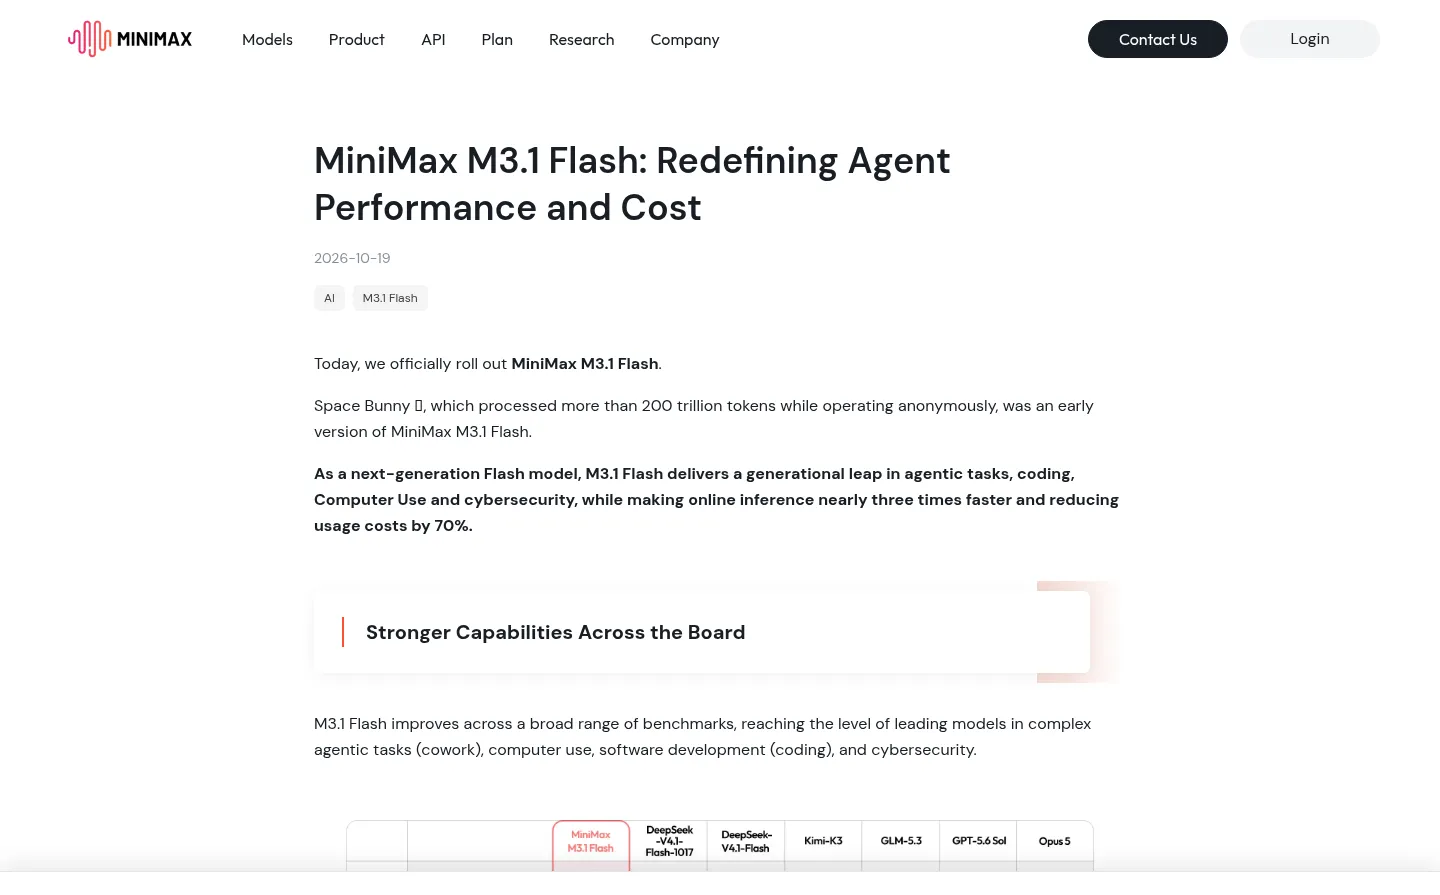
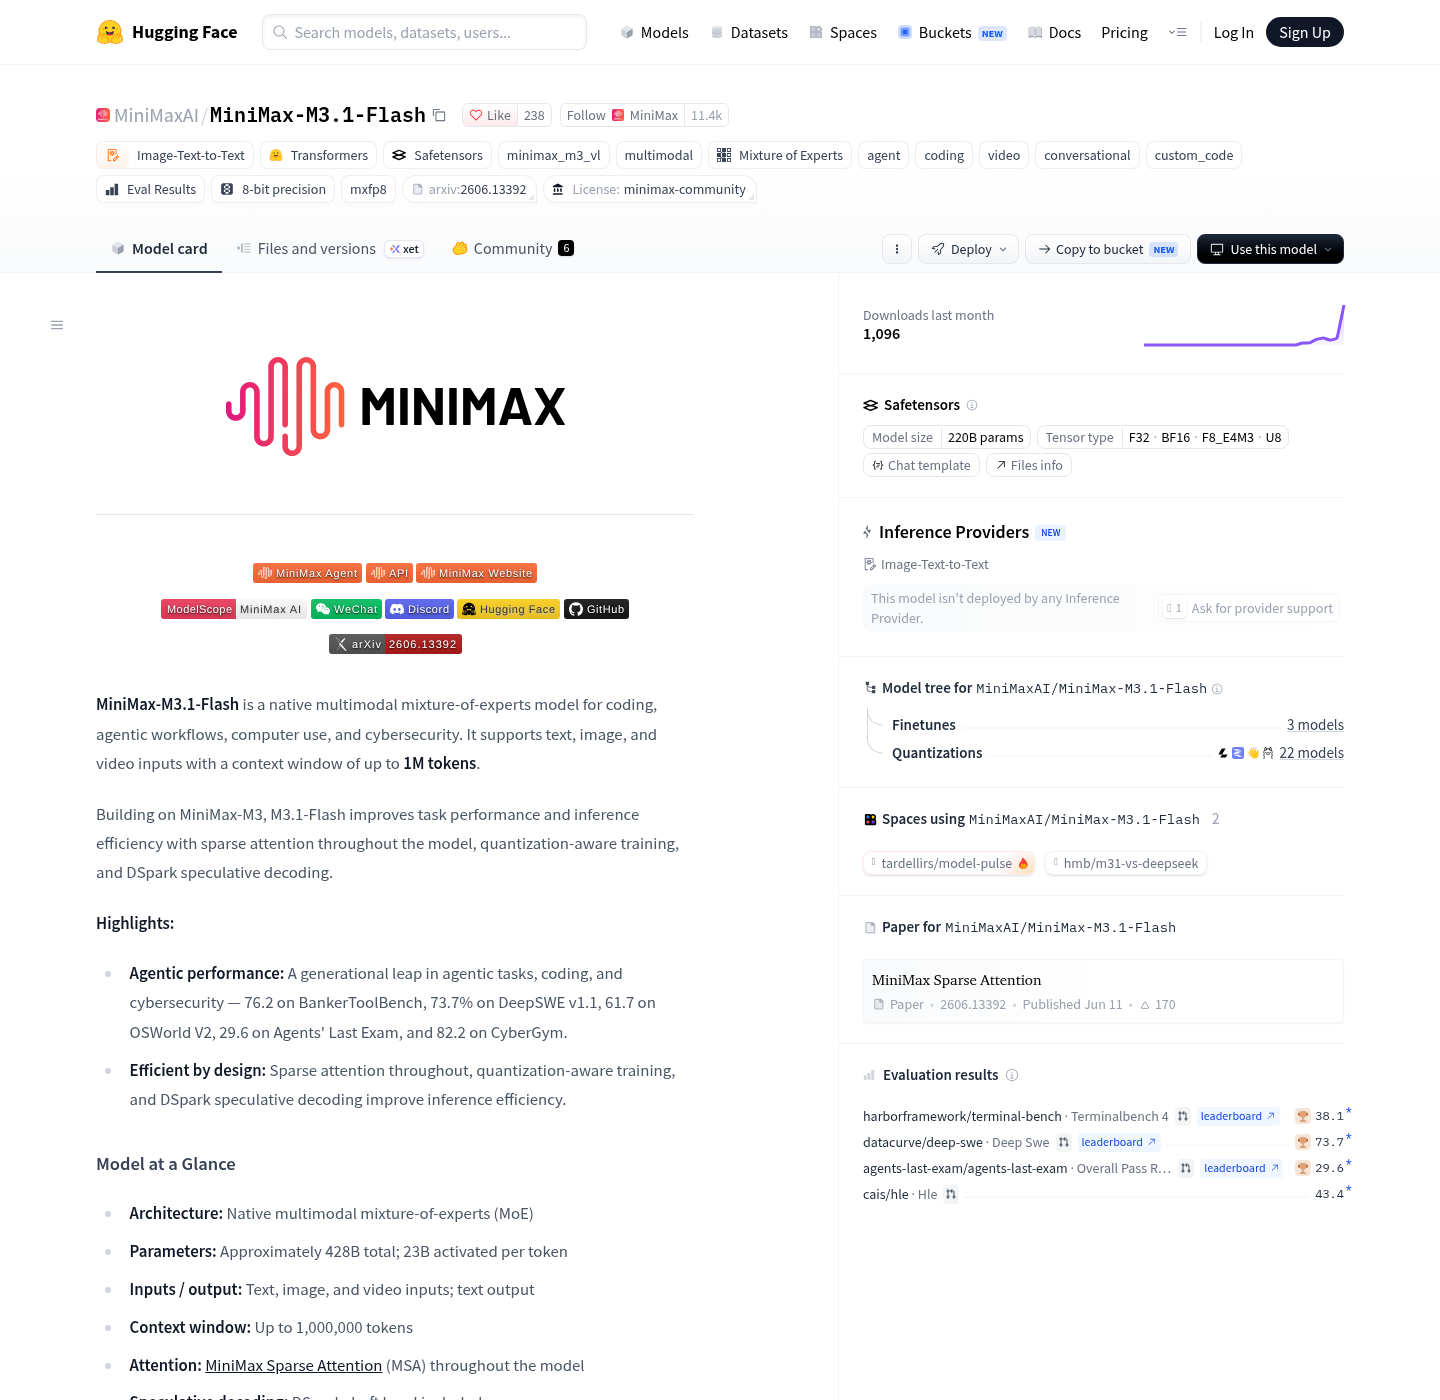
MiniMax M3.1 Flash là một mô hình ngôn ngữ lớn (LLM) tối ưu cho AI agent, được thiết kế để vừa tăng tốc độ suy luận gần gấp ba lần thế hệ trước, vừa giảm tới 70% chi phí cho các tác vụ agent, từ đó hạ đáng kể rào cản tài chính khi doanh nghiệp vừa và nhỏ muốn triển khai tự động hóa dựa trên trí tuệ nhân tạo. MiniMax, công ty AI của Trung Quốc, đã giới thiệu M3.1 Flash như phiên bản kế nhiệm của M3, ra mắt trước đó vào tháng 6, với mục tiêu rõ ràng là tấn công thị trường AI agent bằng lợi thế giá và hiệu năng. Theo thông tin công bố, M3.1 Flash sử dụng kiến trúc hỗn hợp chuyên gia (Mixture-of-Experts) với tổng cộng 428 tỷ tham số, trong đó 23 tỷ tham số hoạt động trên mỗi token, cho phép mô hình giữ được chất lượng suy luận trong khi vẫn tiết kiệm tài nguyên tính toán. Câu chuyện không chỉ là một bản nâng cấp kỹ thuật; đây là nỗ lực định nghĩa lại mặt bằng chi phí AI agent trên toàn thị trường.
Giảm 70% chi phí AI agent: Ý nghĩa kinh tế cho doanh nghiệp nhỏ
Điểm gây chú ý nhất của MiniMax M3.1 Flash là tuyên bố giảm 70% chi phí cho các tác vụ AI agent so với thế hệ trước, đồng thời tăng tốc độ suy luận gần gấp ba. Với hơn 200 token đầu ra mỗi giây trong sử dụng thông thường và tốc độ trung vị khoảng 170 token mỗi giây, mô hình này không chỉ rẻ hơn mà còn xử lý khối lượng công việc lớn nhanh hơn. Điều đó dịch sang ngôn ngữ kinh doanh là: cùng một ngân sách, doanh nghiệp có thể chạy nhiều phiên agent hơn, xử lý nhiều yêu cầu khách hàng hơn, hoặc thử nghiệm nhiều kịch bản tự động hóa hơn. Đối với startup và doanh nghiệp vừa và nhỏ vốn bị bó buộc bởi chi phí hạ tầng AI, một mô hình LLM tiết kiệm như M3.1 Flash mở ra khả năng đưa agent vào các quy trình vận hành thay vì chỉ dừng ở vài tính năng thử nghiệm trên website. Nói cách khác, chi phí AI agent giảm mạnh là điều kiện cần để AI bước từ “demo” sang “sản xuất” trong môi trường doanh nghiệp Việt.
Serverless preview: Cơ chế thử nghiệm hai tuần và bài toán rủi ro
M3.1 Flash ra mắt ngày 19 tháng 10 dưới dạng API được host, và bốn ngày sau, các bản xem trước serverless xuất hiện cùng thời điểm trọng số mô hình được đưa lên Hugging Face. Ít nhất một triển khai được công bố rõ ràng là bài kiểm tra nhu cầu kéo dài hai tuần, không phải sản phẩm có cam kết lâu dài. Bản xem trước serverless cho phép doanh nghiệp gọi mô hình theo từng token với giá niêm yết, không cần hợp đồng, không có công suất dự trữ, không có mức sàn thông lượng và không có cam kết nào cho tháng sau. Về bản chất, đây là một tín hiệu nhu cầu được khoác áo sản phẩm: bên vận hành đo lưu lượng thật trước khi mua thêm GPU, còn doanh nghiệp có cơ hội kiểm thử hiệu năng và chi phí AI agent trong điều kiện gần với thực tế. Quan trọng hơn, vì trọng số 428 tỷ tham số có thể tải xuống, bản xem trước không biến người dùng thành “con tin” của một mô hình đóng; luôn tồn tại lối thoát tự triển khai, dù tốn kém hơn.
Tác động dài hạn: Từ thử nghiệm đến chuẩn chi phí mới cho AI agent
Bản xem trước serverless chỉ kéo dài hai tuần và việc tiếp tục phụ thuộc vào nhu cầu, nhưng nếu M3.1 Flash đạt mức sẵn sàng chung trên các nền tảng suy luận, việc chuyển đổi từ giai đoạn thử nghiệm sang vận hành lâu dài sẽ khá đơn giản về mặt tích hợp. Hiện người dùng đã có thể truy cập M3.1 Flash thông qua API riêng, dịch vụ thuê bao và ứng dụng viết mã, trong khi MiniMax cho biết sẽ tiếp tục công bố trọng số mô hình và giới thiệu thêm phiên bản Pro hiệu năng cao hơn. Điều này cho thấy chiến lược rõ ràng: dùng một mô hình LLM tiết kiệm để đặt lại kỳ vọng thị trường về chi phí AI agent, rồi mở rộng dần hệ sinh thái sản phẩm xung quanh nó. Với doanh nghiệp Việt, thông điệp thực tế là: đã đến lúc đưa chi phí AI agent vào bảng kế hoạch ngân sách như một hạng mục có thể dự đoán, thay vì một khoản thử nghiệm khó kiểm soát. Ai chấp nhận thử sớm trong giai đoạn serverless preview sẽ có lợi thế hiểu mô hình, tối ưu quy trình và đi trước đối thủ khi chi phí AI trở thành cuộc chơi cạnh tranh.