
V4.1-Flash-1017: mô hình AI nhỏ gọn được sinh ra để chạy nhanh
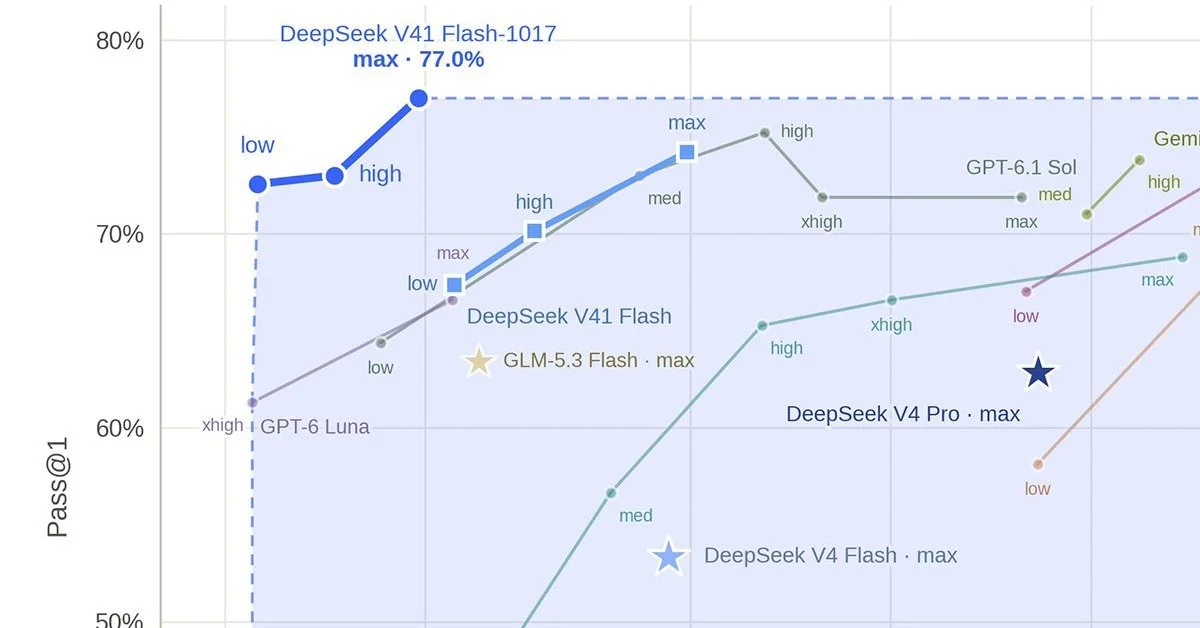
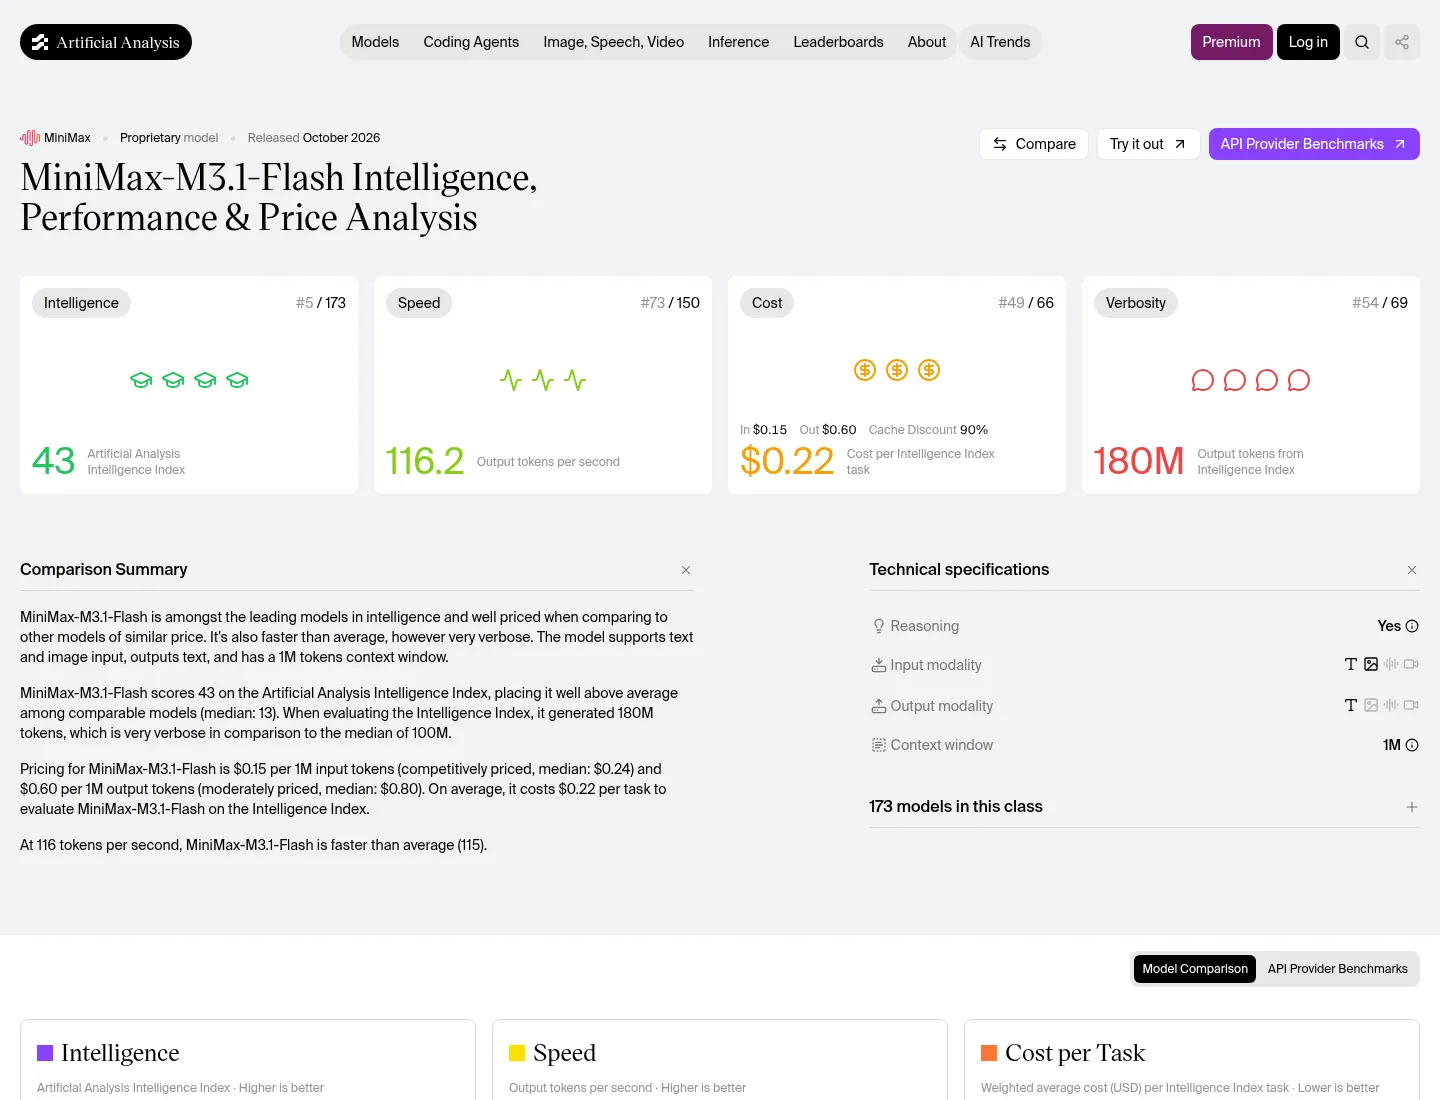
DeepSeek V4.1-Flash-1017 là bản cập nhật của mô hình DeepSeek V4.1-Flash, được thiết kế như một mô hình AI nhỏ gọn ưu tiên tốc độ xử lý, phản hồi ngắn gọn và khả năng chạy trên hạ tầng giới hạn tài nguyên, thay vì chỉ tập trung vào sức mạnh tính toán tối đa. Đây không phải một bản nâng cấp mang tính phô trương, mà là bước đi chiến lược: DeepSeek chọn tối ưu hóa tốc độ xử lý và hiệu suất để cạnh tranh trong phân khúc AI gọn nhẹ, nơi mỗi mili giây trễ và mỗi watt điện đều là chi phí. Theo thông tin công bố, V4.1-Flash-1017 là bản cập nhật nhỏ của V4.1-Flash – mô hình ra mắt đầu tháng 9 – nhưng lại đạt điểm benchmark cao hơn, hoàn thành tác vụ nhanh hơn và đưa ra phản hồi ngắn gọn hơn. Điều này cho thấy DeepSeek đang theo đuổi triết lý “nhỏ nhưng sắc”, thay vì chạy đua kích thước mô hình.
Benchmark cao hơn, phản hồi ngắn hơn: DeepSeek chọn hiệu quả thay vì dài dòng
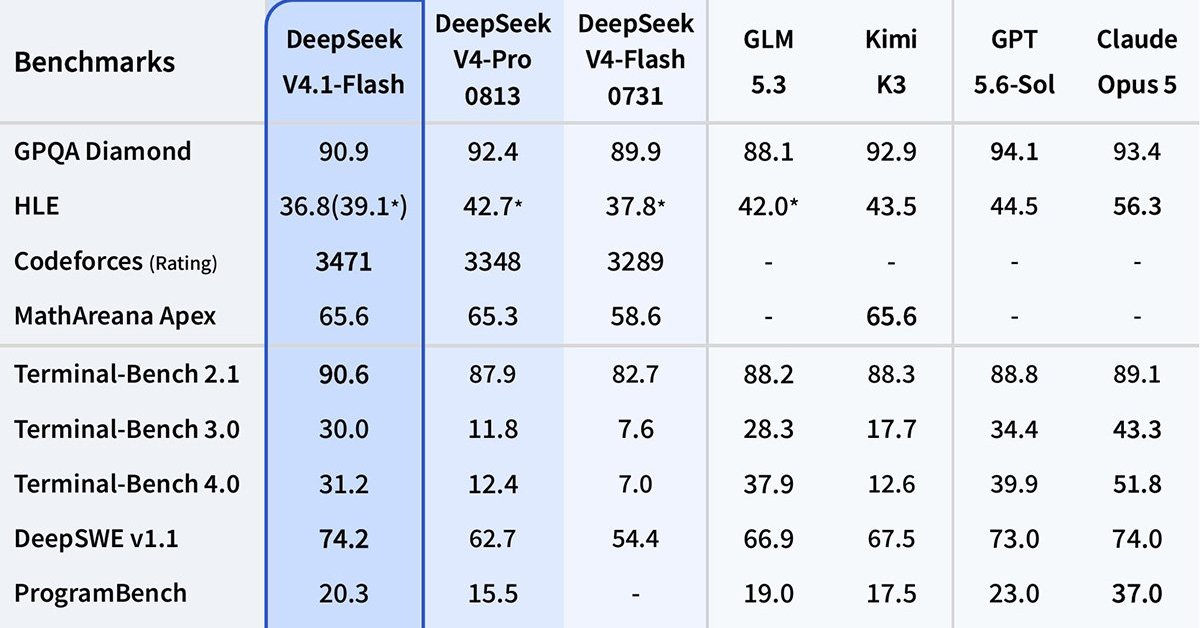
Điểm đáng chú ý ở V4.1-Flash-1017 không nằm ở tên gọi mới, mà ở việc DeepSeek dám tuyên bố mô hình này nhanh hơn và gọn nhẹ hơn bản trước. Báo cáo kỹ thuật cho thấy checkpoint V4.1-Flash-1017 đạt điểm HLE 42,6 và DeepSWE 77,0, phản ánh khả năng xử lý tác vụ thực tế được cải thiện so với thế hệ trước. Câu nói có thể trích dẫn ở đây là: “Checkpoint V4.1-Flash-1017 đạt điểm HLE 42,6 và DeepSWE 77,0”, cho thấy DeepSeek không chỉ nói chung chung về hiệu năng mà đưa ra số liệu cụ thể. Quan trọng hơn, hãng nhấn mạnh mô hình hoàn thành tác vụ nhanh hơn và phản hồi ngắn gọn hơn. Đó là lựa chọn có chủ ý: trong bối cảnh người dùng mệt mỏi với câu trả lời dài lê thê, một mô hình ưu tiên tốc độ và súc tích sẽ hấp dẫn hơn cho chatbot, trợ lý công việc và các ứng dụng di động AI cần phản hồi tức thời.
Truy cập ngay trên web, app và tự lưu trữ: DeepSeek muốn phá thế phụ thuộc API
DeepSeek không giữ V4.1-Flash-1017 trong phòng thí nghiệm. Người dùng có thể sử dụng ngay mô hình này trên web, ứng dụng DeepSeek và nền tảng dành cho nhà phát triển. Đây là bước đi khôn ngoan: nếu đã tối ưu hóa tốc độ xử lý, mô hình phải được đưa thẳng vào tay người dùng để chứng minh giá trị. Nhưng chiến lược của DeepSeek còn đi xa hơn. Thông qua DeepInfer framework – bộ khung suy luận nội bộ được mở mã nguồn dưới giấy phép Apache 2.0 – bất kỳ tổ chức nào cũng có thể chạy DeepSeek-V4.1-Flash trên hạ tầng của riêng mình, dưới chính sách bảo mật riêng, mà không cần gửi dữ liệu lên API bên thứ ba. Điều này trực tiếp thách thức cách tiếp cận “đóng cửa” của các nhà cung cấp lớn: thay vì buộc doanh nghiệp phụ thuộc vào dịch vụ đám mây, DeepSeek trao cho họ quyền tự quyết về hạ tầng và chi phí.
DeepInfer: quân bài mở nguồn gây sức ép lên OpenAI và Anthropic
Việc DeepSeek công khai DeepInfer – framework suy luận dùng cho dịch vụ sản xuất của chính hãng – là bước leo thang rõ ràng trong cuộc cạnh tranh với các mô hình mã đóng từ Mỹ. DeepInfer được mô tả là “framework suy luận hiệu năng cao vận hành các dịch vụ sản xuất quy mô lớn của DeepSeek” và bản phát hành mở nguồn cung cấp khả năng suy luận offline với các tính năng cốt lõi để phục vụ ở quy mô lớn. Theo một bài tường thuật, động thái này được xem là DeepSeek “tăng áp lực” lên OpenAI và Anthropic bằng cách trao cho cộng đồng bộ máy phục vụ mô hình, chứ không chỉ là trọng số nghiên cứu. DeepSeek từng giải thích họ phải mất thời gian tách framework khỏi hạ tầng nội bộ vì nó gắn chặt với công cụ quản lý cụm, khiến việc phát hành công khai không khả thi nếu không chỉnh sửa đáng kể. Khi đã làm xong, họ tuyên bố mục tiêu là giúp cộng đồng giảm chi phí tính toán, giảm tiêu thụ năng lượng và khiến AI trở nên dễ tiếp cận hơn.
Cuộc đua AI nhỏ gọn: lợi thế cho ứng dụng di động và thiết bị biên
Chuỗi phát hành liên tiếp của DeepSeek – từ V4.1-Flash đầu tháng 9 đến V4.1-Flash-1017 và DeepInfer – đang làm nóng cuộc cạnh tranh giữa các mô hình open-weight của Trung Quốc và các mô hình mã đóng đến từ Mỹ. Dù DeepSeek không nói thẳng về đối thủ, việc mở mã nguồn framework suy luận và tối ưu hóa mô hình cho tốc độ, phản hồi ngắn gọn cho thấy họ nhắm vào phân khúc nơi tài nguyên tính toán bị giới hạn nhưng nhu cầu AI lại tăng nhanh. DeepInfer hiện mới hỗ trợ một mô hình duy nhất là DeepSeek-V4.1-Flash, song hãng đã khẳng định mã suy luận cho các mô hình tương lai sẽ tiếp tục được bổ sung vào kho mã này theo thời gian. Điều đó biến DeepInfer thành nền tảng dài hạn, không phải động thái một lần. Tuy vậy, việc tự lưu trữ vẫn đòi hỏi kỹ năng hệ thống thực thụ, chứ không phải thao tác cài đặt đơn giản. Ai chấp nhận đầu tư công sức sẽ đổi lại quyền kiểm soát, chi phí thấp hơn và khả năng đưa mô hình AI nhỏ gọn vào gần người dùng hơn – từ ứng dụng di động AI đến các thiết bị biên tiết kiệm tài nguyên.