
Thế hệ nhà nghiên cứu AI Việt Nam bước ra từ lớp học đa ngành
Nhà nghiên cứu AI Việt Nam trẻ hôm nay là những sinh viên xuất phát từ các nền tảng học thuật rất khác nhau, từ chuyên văn đến kỹ thuật, nhưng cùng gặp nhau ở khả năng kết hợp tư duy phân tích, năng lực công nghệ và ý thức về những vấn đề thực tế để xây dựng giải pháp xử lý dữ liệu AI, âm thanh, hình ảnh và văn bản gắn với nhu cầu đời sống và nghiên cứu hiện đại. Chính sự đa ngành này đang định nghĩa lại cách chúng ta nhìn vào nhân lực AI. Những câu chuyện của Nguyễn Thị Hồng Trang và Nguyễn Phương Anh cho thấy AI không còn là sân chơi khép kín cho dân thuần kỹ thuật, mà là không gian mở cho tư duy liên ngành, nơi kỹ năng đọc hiểu, phân tích, lập luận và khả năng mô hình hóa dữ liệu gặp nhau. Gốc văn, gốc công nghệ hay gốc khoa học xã hội đều có đất để bám rễ trong lĩnh vực trí tuệ nhân tạo.
Từ chuyên văn đến cuộc thi AI sinh viên: Hồng Trang và Q-AI Harness
Hình mẫu dễ gây bất ngờ nhất là Nguyễn Thị Hồng Trang, nữ sinh từng theo chuyên văn suốt những năm THCS và THPT, sau đó tự chọn lối rẽ sang công nghệ thông tin ở bậc đại học. Việc chuyển sang AI không phải cú rẽ vội mà là kế hoạch đã hình thành từ lớp 10, khi cô vẫn song song nuôi dưỡng đam mê toán, lý, hóa bên cạnh văn học. Quan trọng hơn, Trang không nhìn văn và công nghệ như hai thế giới đối lập. Cô nhấn mạnh thứ mình mang theo từ những năm học văn là khả năng đọc hiểu, phân tích và lập luận – kỹ năng trở nên thiết yếu trong bối cảnh AI tạo ra lượng thông tin đồ sộ, vừa hữu ích, vừa nhiễu. Trong cuộc thi AI sinh viên Vietnamese Student HackAIthon ở bảng Innovator, Trang phát triển Q-AI Harness, một hệ thống trả lời câu hỏi trắc nghiệm tiếng Việt đa lĩnh vực dựa trên mô hình mở kích thước nhỏ, và giành giải nhất bảng C cùng giải thưởng 95 triệu đồng.
Giải pháp xử lý dữ liệu AI: kiểm soát ảo giác và thiết kế vai trò
Điểm đáng nói ở Q-AI Harness không chỉ là việc thắng một cuộc thi AI sinh viên, mà ở cách một sinh viên chuyên văn cũ xử lý bài toán kỹ thuật: làm thế nào để mô hình nhỏ vẫn trả lời chính xác trên tập câu hỏi kiểm tra không biết trước nội dung. Trang chọn hướng thiết kế hệ thống với nhiều vai trò trên cùng một mô hình, để nó lần lượt phân tích, phân loại, tra cứu, giải quyết và đưa ra đáp án. Đó là cách tư duy cấu trúc rất giống viết một bài luận: chia phần, xác định chức năng, kiểm soát giọng điệu. Quan trọng hơn, cô chủ động đối diện vấn đề "ảo giác" của AI – những câu trả lời nghe thuyết phục nhưng sai – bằng cách bổ sung ngữ cảnh đầu vào, đặt quy tắc đầu ra cho từng trường hợp và xây dựng kho tri thức cho mô hình tra cứu khi thiếu kiến thức. Đây là một giải pháp xử lý dữ liệu AI giàu tính thực dụng, cho thấy tư duy ngôn ngữ và logic không chỉ giúp viết văn mà còn giúp đặt câu hỏi, định nghĩa ràng buộc cho hệ thống trí tuệ nhân tạo.
Phương Anh và BALM: khi mô hình đa phương thức gặp dữ liệu thiếu không đều
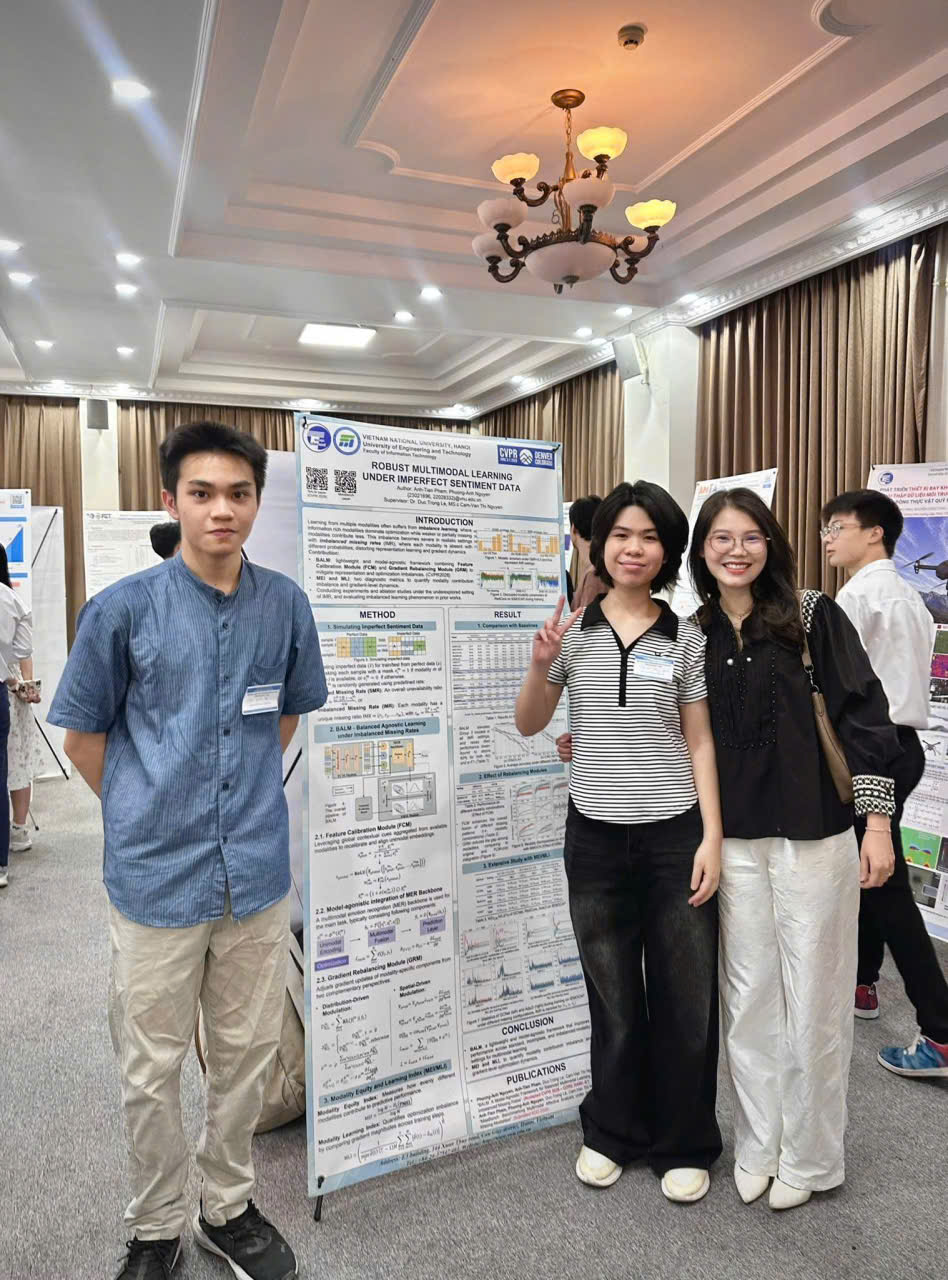
Trong khi Hồng Trang giải bài toán ảo giác trên dữ liệu câu hỏi tiếng Việt, Nguyễn Phương Anh lại cùng nhóm ở Trường Đại học Công nghệ đi thẳng vào vấn đề ít được nói tới nhưng cực kỳ thực tế: mô hình đa phương thức sẽ học ra sao nếu âm thanh, hình ảnh, văn bản bị thiếu với những tỷ lệ khác nhau ngay từ giai đoạn huấn luyện. AI đa phương thức vốn được kỳ vọng kết hợp nhiều loại tín hiệu – giọng nói, biểu cảm, câu chữ – nhưng phần lớn thí nghiệm trước đây giả định mỗi phương thức có xác suất thiếu giống nhau, tạo môi trường cân bằng giả. Nhóm của Phương Anh, gồm sinh viên Phạm Anh Tiến và hai giảng viên hướng dẫn TS. Lê Đức Trọng, ThS. Nguyễn Thị Cẩm Vân, phát triển BALM – một mô-đun độc lập giúp điều chỉnh sự mất cân bằng trong quá trình học của mô hình đa phương thức dưới điều kiện "tỷ lệ thiếu không cân bằng" (IMR). Công trình được công bố tại CVPR, với Phương Anh đứng tên tác giả đầu, có phương pháp rõ, kết quả thử nghiệm trên hai bộ dữ liệu chuẩn và mã nguồn mở cho cộng đồng kiểm tra.
BALM được thiết kế như một giải pháp xử lý dữ liệu AI ở tầng học, không phải tiện ích trang trí. Thành phần hiệu chỉnh đặc trưng FCM dùng thông tin từ các dữ liệu vẫn quan sát được để điều chỉnh biểu diễn mỗi phương thức, nhằm giảm khoảng cách giữa các mẫu có kiểu thiếu dữ liệu khác nhau. Thành phần thứ hai, GRM, đi thẳng vào quá trình tối ưu: nó theo dõi sự chênh lệch giữa dự đoán riêng của từng modality với dự đoán tổng hợp đa phương thức, và sử dụng thông tin về gradient để giảm tình trạng một phương thức mạnh lấn át phần còn lại. Theo mô tả trong công trình, trong các thử nghiệm thiếu dữ liệu nghiêm trọng trên CMU-MOSEI, chỉ số F1 của mô hình dùng BALM có trường hợp thấp hơn mức trung bình đối chứng 0,70 điểm phần trăm. Đây là một câu trả lời thuyết phục cho câu hỏi: liệu chúng ta có thể dạy mô hình đa phương thức học cân bằng trong thế giới dữ liệu thiếu không đều.
Khi nghiên cứu trẻ chạm vào bài toán thực: từ phòng thi đến bệnh viện
Điểm chung của hai câu chuyện là mức độ gắn với vấn đề thực tế. Hồng Trang không dừng ở việc giải bài toán của cuộc thi AI sinh viên; cô nói rõ mong muốn tiếp tục nâng cấp Q-AI Harness, mở rộng ứng dụng sang y tế, sinh học và hướng tới một trợ lý tri thức tiếng Việt toàn diện. Phương Anh và nhóm UET lại nhìn thấy giới hạn ngay trong chính công trình của mình: BALM mới được thử nghiệm trên bộ dữ liệu chuẩn, phần thiếu dữ liệu được mô phỏng bằng thao tác che nhân tạo, chưa chạm tới các nguồn thiếu phát sinh tự nhiên trong bệnh viện, phương tiện tự hành, robot hay hệ thống giám sát vận hành. Điều đáng giá là họ không huyễn hoặc kết quả mà khẳng định cần tiếp tục đánh giá, tối ưu trước khi nghĩ đến ứng dụng hoàn chỉnh, đồng thời chia sẻ dữ liệu, mã nguồn, kinh nghiệm để sinh viên khóa sau kế thừa. Sự trung thực về giới hạn cho thấy thế hệ nhà nghiên cứu AI Việt Nam không mải mê thành tích, mà ý thức rõ khoảng cách từ bài báo, cuộc thi đến sản phẩm dùng được trong đời sống.
Nhìn rộng hơn, những câu chuyện này cho thấy vì sao nền tảng đa ngành lại thành lợi thế trong AI. Trang đi từ chuyên văn sang kỹ thuật nhưng giữ nguyên thói quen kiểm soát luồng thông tin, dùng khả năng đọc hiểu, phân tích để thiết kế prompt, vai trò, kho tri thức cho hệ thống. Phương Anh xuất hiện không phải như gương mặt đại diện cho "nữ sinh công nghệ" mà với vị trí tác giả đầu của một công trình có phương pháp, thử nghiệm, mã nguồn, được cộng đồng có thể đối chiếu. Khi kỹ năng lập luận của dân xã hội gặp khả năng mô hình hóa dữ liệu của dân kỹ thuật, chúng ta nhận được những giải pháp sáng tạo: một hệ thống trả lời trắc nghiệm tiếng Việt chủ động chống ảo giác, một mô-đun cân bằng quá trình học của mô hình đa phương thức khi dữ liệu thiếu không đều. Đây là tín hiệu đáng mừng: AI ở Việt Nam đang dần được xây dựng bởi những người không ngại xuất phát điểm khác biệt, nhưng cùng chia sẻ trách nhiệm kéo công nghệ lại gần đời sống.