
Chi phí mỗi tác vụ: vì sao lập trình bằng AI đang đổi luật chơi
Mô hình AI lập trình rẻ là những hệ thống suy luận được tối ưu để hoàn thành tác vụ lập trình với số token ít nhất có thể, từ đó giảm chi phí vận hành cho đội ngũ phát triển và startup khi họ phải trả tiền theo lượng token mô hình đọc và sinh ra trong suốt vòng đời một tác vụ phức tạp. Khi số mô hình AI lập trình tăng nhanh, chi phí mỗi tác vụ đang trở thành thước đo quan trọng hơn cả tên tuổi nhà cung cấp. DeepSeek công bố mô hình mới có thể hoàn thành một tác vụ lập trình thông thường với chi phí rất thấp so với các đối thủ cùng bảng so sánh, trong khi Fortytwo và Cloudflare lại chọn cách tối ưu hóa API suy luận và cấu trúc mô hình để giảm chi phí token ngay từ thiết kế.
DeepSeek: nói ít để rẻ hơn, nhưng chưa đủ dữ liệu độc lập
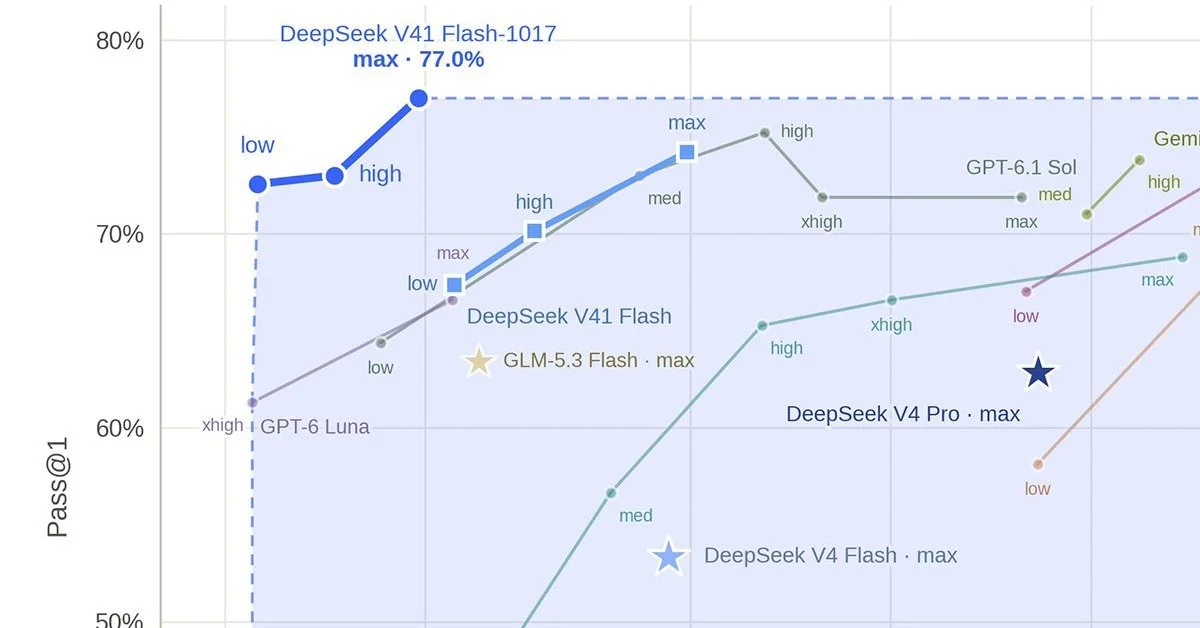
DeepSeek chọn chiến lược cực kỳ thực dụng: cắt bớt lời. Bản cập nhật V4.1-Flash-1017 được huấn luyện để tạo câu trả lời ngắn hơn, nghĩa là mỗi từ mô hình không viết ra cũng là một từ người dùng không phải trả tiền. Đây là cách giảm chi phí token trực diện nhất: ít token hơn, hóa đơn thấp hơn. Theo biểu đồ do chính DeepSeek công bố, mô hình mới hoàn thành một tác vụ lập trình tiêu chuẩn với chi phí thấp hơn rất nhiều so với các mô hình thương mại phổ biến khác. Điều này đặc biệt quan trọng với các tác nhân AI phải xử lý cả kho mã nguồn, tự kiểm thử, sửa lỗi rồi thử lại, có thể tạo ra hàng trăm câu trả lời trong một công việc; khi đó, mô hình có chi phí mỗi tác vụ thấp hơn gấp nhiều lần sẽ biến một thói quen vốn tốn kém thành khoản nhỏ trên hóa đơn.
Không chỉ rẻ, DeepSeek còn báo cáo điểm DeepSWE 77,0%, cao hơn các mô hình mà hãng so sánh. Đây là một câu trích dẫn đáng nhớ: "Mô hình mới của DeepSeek đạt 77,0% DeepSWE, vượt qua cả Opus 5 và GPT-5.6 Sol". Họ đạt được điều này nhờ một dạng học tăng cường với phản hồi tự thân, cho phép mô hình tự chấm sản phẩm của mình thay vì phụ thuộc vào người đánh giá hoặc mô hình chấm điểm riêng. Tuy nhiên, có hai điểm yếu mà các đội kỹ thuật không nên bỏ qua: các con số nổi bật này do DeepSeek công bố, chưa có phòng nghiên cứu độc lập nào kiểm nghiệm bản cập nhật, và điểm số trên một bài đánh giá cũng không nói lên nhiều điều về việc mã nguồn có dễ bảo trì hay không. Nói cách khác, đây là một mô hình AI lập trình rẻ đầy hứa hẹn, nhưng vẫn cần thời gian để cộng đồng xác thực.
Fortytwo Engine: giảm 24,7% token nhờ suy luận tập thể
Nếu DeepSeek tối ưu bằng cách "nói ít", Fortytwo lại chọn cách suy nghĩ thông minh hơn. Fortytwo Engine là một API suy luận sử dụng các mô hình AI phối hợp với nhau để cải thiện khả năng suy luận đồng thời giảm lượng văn bản cần tạo ra để hoàn thành một tác vụ. Công nghệ Swarm Decoder cho phép nhiều mô hình cùng tham gia định hình một lộ trình suy luận chung trong khi lộ trình đó đang được tạo ra, đánh giá hướng nào có triển vọng hơn trước khi hoàn tất câu trả lời. Mục tiêu là ngăn sai lầm chồng chất và cắt bỏ phần suy luận lãng phí, thay vì để mô hình đi hết một con đường sai rồi mới chọn câu trả lời tốt nhất. Đây là một dạng tối ưu hóa API suy luận ở cấp kiến trúc: giảm chi phí token không chỉ bằng việc rút ngắn câu trả lời, mà bằng việc tránh sinh ra những token không cần thiết ngay từ đầu.
Kết quả mà Fortytwo báo cáo khá ấn tượng: mô hình đầu tiên được hỗ trợ, Qwen 3.8 27B, sử dụng ít hơn 24,7% số token trong 450 lần chạy các tác vụ kỹ thuật phần mềm DeepSWE so với khi chạy riêng lẻ cùng mô hình đó, đồng thời giải quyết được tỷ lệ tác vụ cao hơn. Trong đánh giá nội bộ, Engine đạt 47,8 điểm so với 42,2 điểm của mô hình nền, trong khi lượng token sử dụng trung bình giảm từ 16,3 triệu xuống 12,3 triệu cho mỗi lần chạy. Nói cách khác, họ chứng minh rằng suy luận tập thể có thể vừa cải thiện chất lượng, vừa giảm chi phí AI công cụ lập trình. Điểm đáng chú ý là Fortytwo giữ giá mỗi token ở mức giá của mô hình nền, tập trung tối ưu chi phí mỗi tác vụ hoàn thành thành công. Nếu hoạt động đánh giá chéo liên tục ngăn được đủ lượng suy luận lãng phí để bù chi phí phát sinh, các đội phát triển có thêm một con đường nữa để tối ưu hóa chi phí vận hành, bên cạnh việc chọn mô hình tốt hơn hoặc phần cứng nhanh hơn.
Cloudflare Clairic: cắt bỏ sinh văn bản, tập trung trích xuất giá trị
Cloudflare bước vào cuộc chơi theo một hướng khác: thay vì mô hình ngôn ngữ lớn sinh văn bản, họ giới thiệu Clairic, mô hình đầu tiên trong dòng System One trích xuất. Clairic được xây dựng để trích xuất các giá trị có kiểu dữ liệu từ đầu vào phi cấu trúc, thực hiện trích xuất, tính toán, ước tính và dự báo thay vì tạo văn bản. Về bản chất, đây là một cách giảm chi phí token bằng cách không sinh token đầu ra: mô hình chỉ đọc, không nói. Cloudflare cho biết Clairic đạt độ chính xác cao hơn, độ trễ thấp hơn và chi phí thấp hơn so với các mô hình ngôn ngữ lớn truyền thống. Trên nền Workers AI, Clairic có cửa sổ ngữ cảnh lớn, hỗ trợ hình ảnh và chỉ tính phí trên token đầu vào, vì mô hình không tạo token đầu ra.
Cách hoạt động của Clairic cũng khác hẳn các chatbot lập trình quen thuộc. Mỗi yêu cầu kết hợp một state, văn bản cần đọc cùng tối đa bốn hình ảnh, với một bản đồ các trường có kiểu dữ liệu; mô hình trả lời tất cả trường trong một lượt xử lý xuôi song song, không qua bước suy luận sinh văn bản. Mỗi câu trả lời vô hướng kèm theo xác suất giá trị không có trong đầu vào và điểm tin cậy; nếu đầu vào không đủ, mô hình trả về null thay vì bịa đặt. Đây là một thiết kế phù hợp với các tác vụ lập trình thiên về trích xuất cấu hình, thông số, log hoặc số liệu từ tài liệu dài, nơi sinh văn bản là lãng phí. Tuy vậy, Cloudflare gọi điểm cuối hiện tại là một mốc phát triển ban đầu và nêu ra một số hạn chế, nên Clairic hiện giống một công cụ chuyên dụng để cắm vào pipeline hơn là thay thế trực tiếp các mô hình AI lập trình rẻ dạng tổng quát.
Token, chi phí và lựa chọn cho đội phát triển
Điểm chung giữa DeepSeek, Fortytwo và Cloudflare là họ đều coi chi phí mỗi tác vụ là thước đo trung tâm khi mô hình AI lập trình ngày càng nhiều. DeepSeek tập trung vào việc nói ít để giảm chi phí token, Fortytwo tối ưu hóa API suy luận bằng suy luận tập thể để cắt bỏ 24,7% token lãng phí, còn Cloudflare thiết kế một mô hình trích xuất không sinh văn bản để loại bỏ hoàn toàn chi phí đầu ra. Với các đội phát triển và startup, token efficiency không còn là chi tiết kỹ thuật mà là yếu tố quyết định chi phí vận hành: bất kỳ ai giao cho một tác nhân AI xử lý kho mã nguồn và trả phí theo token đều sẽ cảm nhận trực tiếp tác động này.
Vậy mô hình nào rẻ nhất? Câu trả lời thực tế là: rẻ hay không phụ thuộc vào kiểu tác vụ và cách bạn tích hợp. DeepSeek có vẻ là mô hình AI lập trình rẻ hấp dẫn cho các tác vụ coding tổng quát, miễn là bạn chấp nhận dựa vào số liệu do hãng tự công bố. Fortytwo Engine phù hợp với những ai muốn tối ưu hóa chi phí AI công cụ lập trình ở cấp API, tận dụng khả năng tương thích với OpenAI Chat Completions để chuyển đổi dần mà không phải viết lại toàn bộ client. Clairic lại là lựa chọn tốt cho các pipeline cần trích xuất giá trị có cấu trúc từ tài liệu và log, nơi mỗi token sinh thêm là một token lãng phí. Chiến lược khôn ngoan nhất lúc này không phải chọn một mô hình duy nhất, mà là kết hợp: dùng mô hình sinh văn bản khi cần, và chuyển sang các mô hình tối ưu token cho những đoạn việc lặp lại, tốn chi phí nhất.