
GPT-Live-1.1 là gì và vì sao bản nâng cấp giọng nói này quan trọng
GPT-Live-1.1 là thế hệ mô hình giọng nói mới của OpenAI dành cho ChatGPT Voice và API, kết hợp khả năng tổng hợp giọng nói nhân tạo, hỗ trợ AI đa ngôn ngữ và công nghệ prompt-to-voice để người dùng mô tả, tạo và tái sử dụng giọng nói theo nhu cầu thương hiệu hoặc trải nghiệm hội thoại riêng. Bản chất của lần nâng cấp này không chỉ là âm thanh nghe tự nhiên hơn, mà là cách OpenAI tái thiết kế toàn bộ lớp giọng nói như một lớp sản phẩm có thể cấu hình, thử nghiệm và phân tầng theo nhóm người dùng khác nhau.
Ngày 15 tháng 10, OpenAI công bố GPT-Live-1.1 với “giọng nói mới, ngữ điệu tốt hơn và ít phải 'checking...' hơn” trên X. Cùng ngày, cả GPT-Live-1.1 và mô hình thứ hai GPT-Live-1.1 Quip được triển khai trong ChatGPT Voice cho tất cả người dùng. Đây là bước đi rõ ràng nhắm vào trải nghiệm đại chúng: đợt triển khai này trước hết là một thay đổi ở bề mặt dành cho người tiêu dùng. Nói cách khác, OpenAI đang dùng giọng nói như cửa ngõ để người dùng cảm nhận sự khác biệt giữa các tầng sản phẩm, thay vì chỉ phân biệt bằng tốc độ hay giới hạn token.
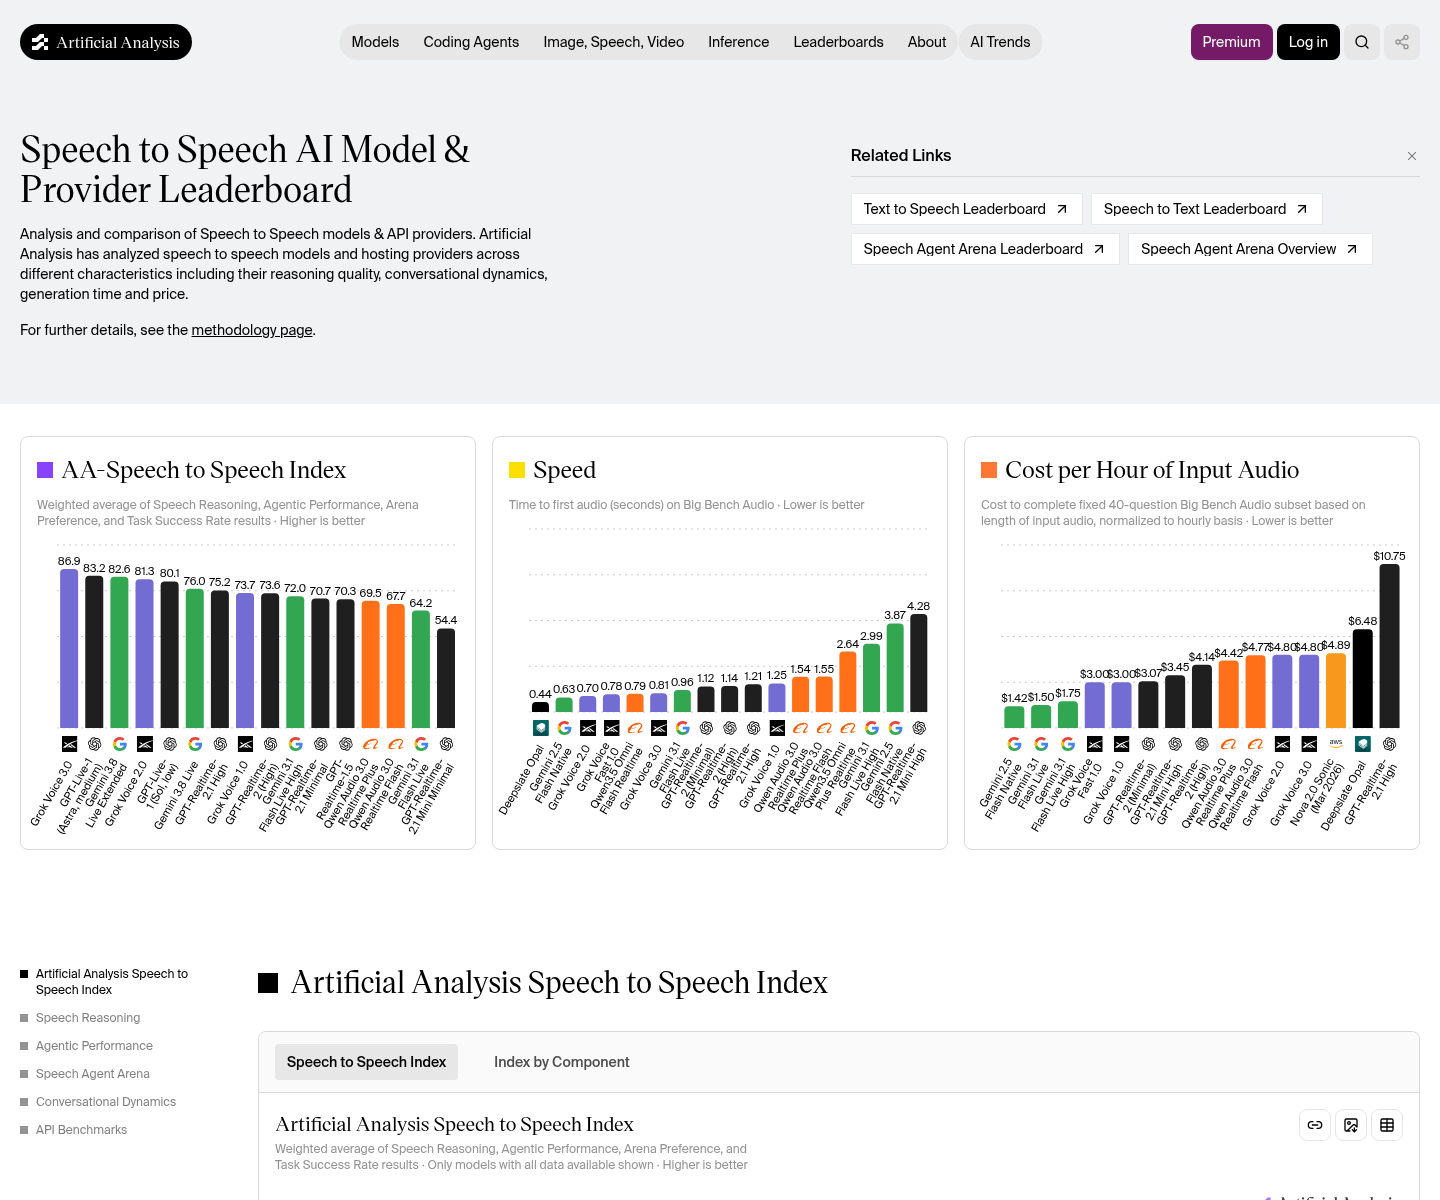
Điểm đáng chú ý là GPT-Live vẫn là một hệ thống hai mô hình: GPT-Live-1.1 kế nhiệm GPT-Live-1, còn GPT-Live-1.1 Quip kế nhiệm GPT-Live-1 mini. Việc phân tầng này không chỉ là chi tiết kỹ thuật; nó quyết định ai sẽ nghe được chất lượng giọng nói tốt hơn, ai phải chấp nhận một phiên bản “nhẹ” hơn. Nếu bạn nghĩ mình đang đánh giá cùng một mô hình khi so sánh tài khoản Free và Plus, bạn đang nhầm: hệ thống coi chúng là hai mô hình được đánh giá riêng biệt xuyên suốt.
Sáu ngôn ngữ mới và cách GPT-Live-1.1 định nghĩa lại AI đa ngôn ngữ
GPT-Live-1.1 giọng nói không chỉ là chuyện tiếng Anh nghe tự nhiên hơn; nó là một bước dịch chuyển chiến lược sang AI đa ngôn ngữ với trọng tâm là giọng nói nhân tạo bản địa hóa. Trong đợt triển khai ngày 15 tháng 10, OpenAI bổ sung mười ba tùy chọn giọng nói mới: mỗi thứ tiếng Pháp, Đức, Hindi, Nhật, Hàn và Tây Ban Nha Mexico có hai giọng, cộng thêm Bubbie bằng tiếng Anh. Điều này biến GPT-Live từ một sản phẩm “Anh ngữ trung tâm” thành một nền tảng có thể phục vụ nhiều thị trường cùng lúc, với sắc thái vùng miền rõ ràng hơn.
Ở tầng người dùng, thay đổi này rất cụ thể: GPT-Live-1.1 là mô hình giọng nói mặc định cho người dùng gói Plus và các gói cao hơn, trong khi GPT-Live-1.1 Quip là mặc định cho mọi người dùng còn lại. Nghĩa là cùng một tính năng ChatGPT Voice, nhưng trải nghiệm âm thanh sẽ khác nhau tùy gói. Đây là một cách “định giá bằng cảm giác”: người dùng trả phí không chỉ mua thêm tính năng, mà mua cả cảm giác hội thoại mượt hơn, ít “checking…” hơn.
Ở tầng nhà phát triển, việc bổ sung sáu ngôn ngữ mới mở ra cơ hội thử nghiệm sản phẩm giọng nói ở các thị trường phi tiếng Anh mà không phải xây dựng từ đầu. Một câu trích dẫn đáng nhớ từ tài liệu là: “Nếu bạn đã phát hành một sản phẩm Live trên một giọng đặt trước, chín phần bổ sung là cơ hội miễn phí để kiểm tra xem người dùng không nói tiếng Anh của bạn có thực sự đang được phục vụ hay không”. Điều này cho thấy OpenAI coi thư viện preset giọng nói như một công cụ A/B test trải nghiệm toàn cầu, chứ không chỉ là danh sách lựa chọn mang tính trang trí.
Prompt-to-voice: khi mô tả bằng lời trở thành preset giọng nói
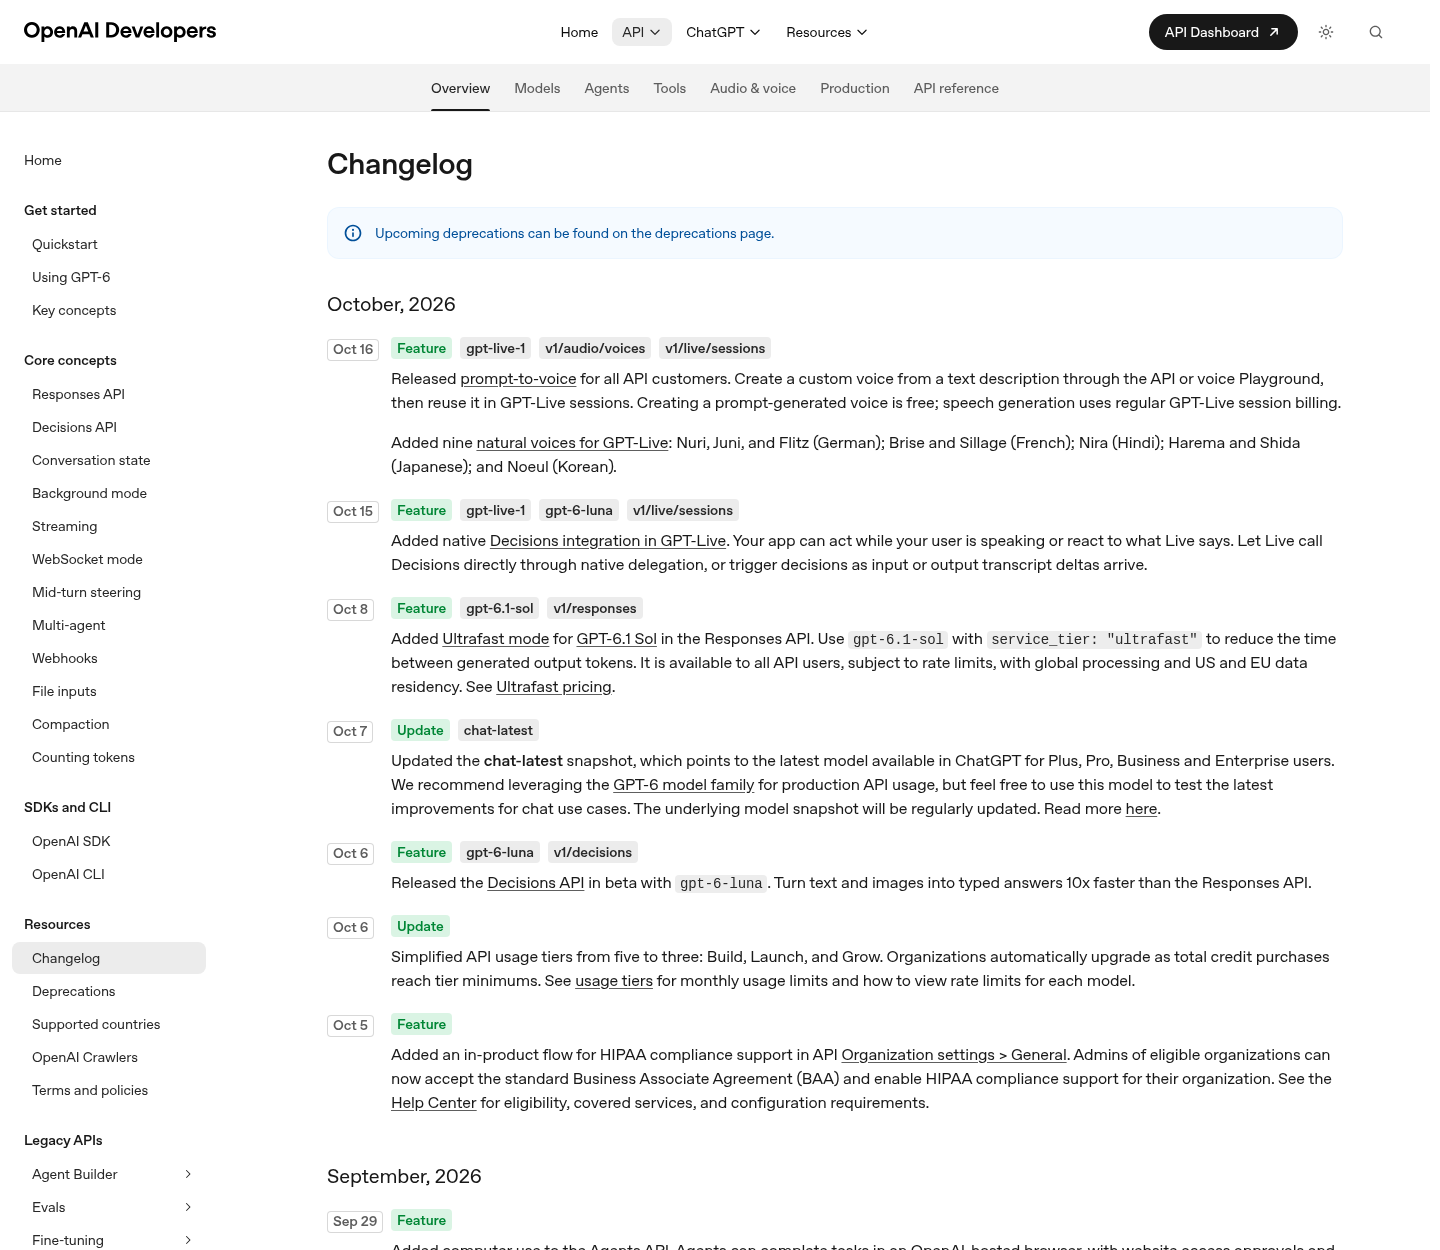
Nếu GPT-Live-1.1 là bước mở rộng chiều ngang (nhiều ngôn ngữ, nhiều tầng người dùng), thì prompt-to-voice OpenAI là bước mở rộng chiều sâu: cho phép mỗi tổ chức “đúc” giọng nói nhân tạo của riêng mình. Ngày 16 tháng 10, OpenAI ra mắt prompt-to-voice cho tất cả khách hàng API và bổ sung chín giọng nói tự nhiên nhắm đến năm thị trường phi tiếng Anh. Từ đây, việc chọn giọng không còn là chọn một chuỗi cố định; đó là viết một mô tả bằng ngôn ngữ tự nhiên và để hệ thống tạo ra một giọng mới.
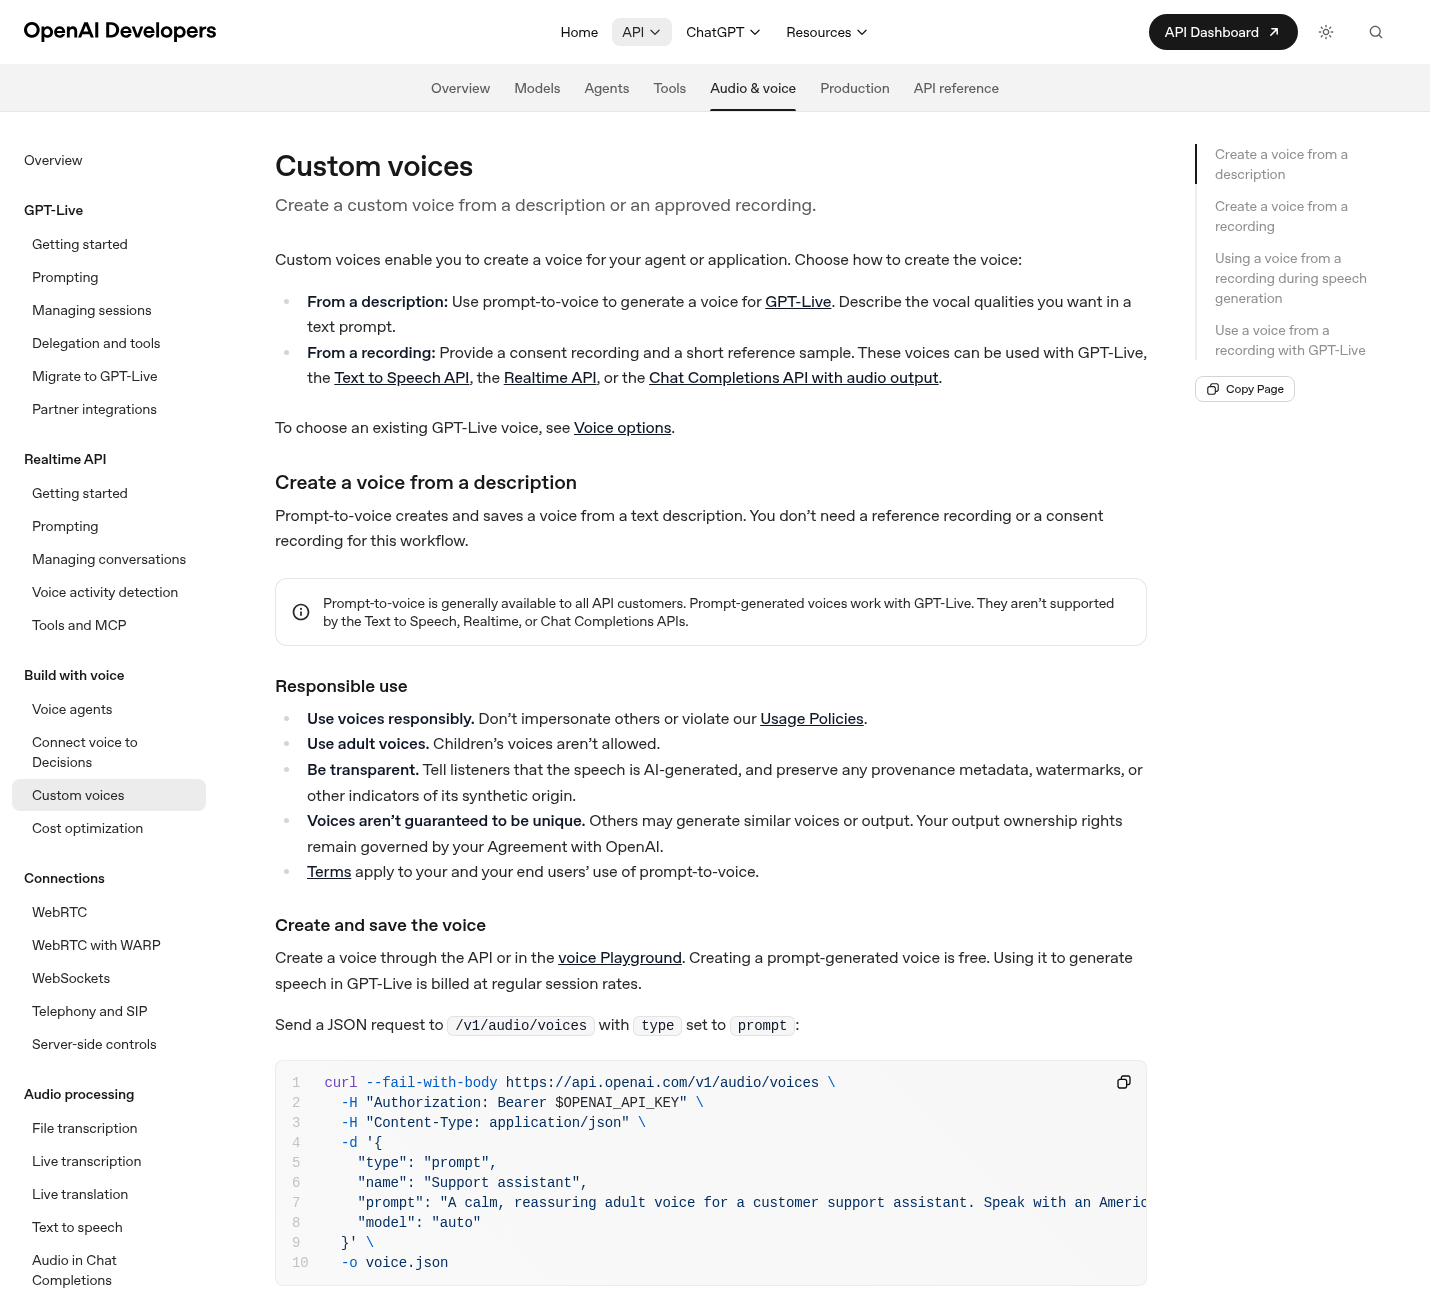
Prompt-to-voice cho phép tạo giọng nói tùy chỉnh từ mô tả văn bản, thông qua API hoặc Playground giọng nói, rồi tái sử dụng trong các phiên GPT-Live. Các phẩm chất có thể điều khiển đều được diễn đạt bằng ngôn ngữ thường: giọng, tuổi, cách thể hiện, cao độ, âm sắc, kết cấu, độ to, tốc độ nói và tính khác biệt. Không có thanh trượt số, không có tham số kỹ thuật; prompt chính là API. Đây là một lựa chọn mang tính quan điểm: OpenAI ưu tiên khả năng diễn đạt linh hoạt hơn là khả năng tái lập chính xác.
Về chi phí, việc tạo một giọng nói được tạo bằng prompt là miễn phí; chỉ khi dùng nó để tổng hợp giọng nói trong phiên GPT-Live hoặc nghe thử trong Playground thì mới được tính như một phiên thông thường. Thiết kế phản hồi API cũng nói lên triết lý sản phẩm: phản hồi không chứa âm thanh, chỉ có siêu dữ liệu và prompt gốc. Nghĩa là bạn không “nghe thử” ngay tại thời điểm tạo; bạn phải dùng nó trong ngữ cảnh thực, và mỗi lần thử là một phiên có chi phí. Điều này buộc các đội sản phẩm phải coi mô tả giọng nói như tài sản cần quản lý phiên bản, tương tự system prompt.
Chín preset quốc tế mới và thư viện giọng nói đang dày lên
Song song với prompt-to-voice, OpenAI mở rộng thư viện preset giọng nói như một “menu mặc định” cho những ai chưa cần hoặc chưa muốn tùy biến sâu. Chín giọng nói tự nhiên mới được thêm vào: Nuri, Juni và Flitz (tiếng Đức); Brise và Sillage (tiếng Pháp); Nira (tiếng Hindi); Harema và Shida (tiếng Nhật); Noeul (tiếng Hàn). Đây là các preset giọng nói nhắm thẳng tới năm thị trường phi tiếng Anh, giúp sản phẩm giọng nói có thể “bản địa hóa nhanh” mà không cần prompt phức tạp.
Chín bổ sung mới này được thêm lên trên một thư viện mà hướng dẫn giọng nói Live hiện liệt kê sâu tới hai mươi mốt mục, cùng với marin là mặc định. Với tiếng Anh, thư viện còn chi tiết hơn: Quartz và Ripple là của Úc; Vesper là của Anh; Willow và Stone là của Ireland; Gleam và Meridian là của Bắc Mỹ; Beacon là của Philippines; Delta và Cinder là của miền Nam Hoa Kỳ, trong đó bốn giọng được đánh dấu là Generated thay vì Natural. Sự phân loại Natural/Generated này cho thấy OpenAI đang thử nghiệm cả giọng thu tự nhiên lẫn giọng tổng hợp hoàn toàn, nhưng vẫn đặt chúng cạnh nhau trong cùng một danh sách preset.
Một chi tiết dễ bị bỏ qua nhưng quan trọng: hướng dẫn lưu ý rằng “ảnh hưởng vùng miền” mô tả phong cách nói của một giọng đọc, chứ không phải là ràng buộc cứng về những ngôn ngữ mà giọng đó có thể nói. Nghĩa là một preset gắn nhãn tiếng Đức vẫn có thể đọc tiếng Anh hoặc ngược lại. Điều này mở ra các tổ hợp thú vị: một trợ lý nói tiếng Anh với âm sắc Đức, hoặc một chatbot hỗ trợ khách hàng toàn cầu dùng cùng một giọng cho nhiều ngôn ngữ, tạo cảm giác nhất quán thương hiệu hơn là “mỗi ngôn ngữ một nhân vật”.
Hai mô hình, một trải nghiệm: GPT-Live-1.1 và Quip đang đẩy người dùng đi đâu
Đằng sau lớp giọng nói đầy màu sắc là một quyết định kiến trúc mang tính chính trị sản phẩm: phân tầng người dùng bằng mô hình. GPT-Live-1.1 là mô hình giọng nói mặc định cho người dùng Plus và các gói cao hơn, trong khi GPT-Live-1.1 Quip là mặc định cho mọi người dùng còn lại. Quip được mô tả là phiên bản kế nhiệm của GPT-Live-1 mini, nghĩa là nó được tối ưu cho chi phí và khả năng mở rộng hơn là chất lượng tối đa. Kết quả: phần lớn người dùng sẽ trải nghiệm Quip, không phải GPT-Live-1.1 đầy đủ.
Điều này đặt ra một câu hỏi khó chịu nhưng cần thiết: liệu OpenAI đang tạo ra một “tầng giọng nói” hai chuẩn, nơi người dùng miễn phí nghe một kiểu, người dùng trả phí nghe một kiểu khác? Câu trả lời thực tế là có, và họ làm điều đó một cách công khai thông qua thẻ hệ thống. Tuy nhiên, ở góc độ chiến lược, đây cũng là cách hợp lý để thử nghiệm nhanh các cải tiến giọng nói trên nhóm người dùng sẵn sàng trả tiền, trước khi (nếu) phổ cập xuống các tầng thấp hơn.
Khi đặt tất cả mảnh ghép lại với nhau — GPT-Live-1.1 giọng nói, prompt-to-voice OpenAI, thư viện preset giọng nói dày lên và hai mô hình Live song song — bức tranh hiện ra khá rõ: OpenAI đang biến giọng nói thành lớp giao diện chính của hệ sinh thái GPT, nơi mỗi doanh nghiệp có thể chọn giữa preset quốc tế, giọng tùy chỉnh mô tả bằng prompt, và các tầng chất lượng khác nhau theo gói. Đây không còn là câu chuyện “AI biết nói”, mà là cuộc đua xem ai biến giọng nói nhân tạo thành trải nghiệm hội thoại đáng tin, đa ngôn ngữ và đủ linh hoạt để mang dấu ấn thương hiệu riêng.