
Kết nối quang AI: điểm nghẽn mới của kỷ nguyên GPU
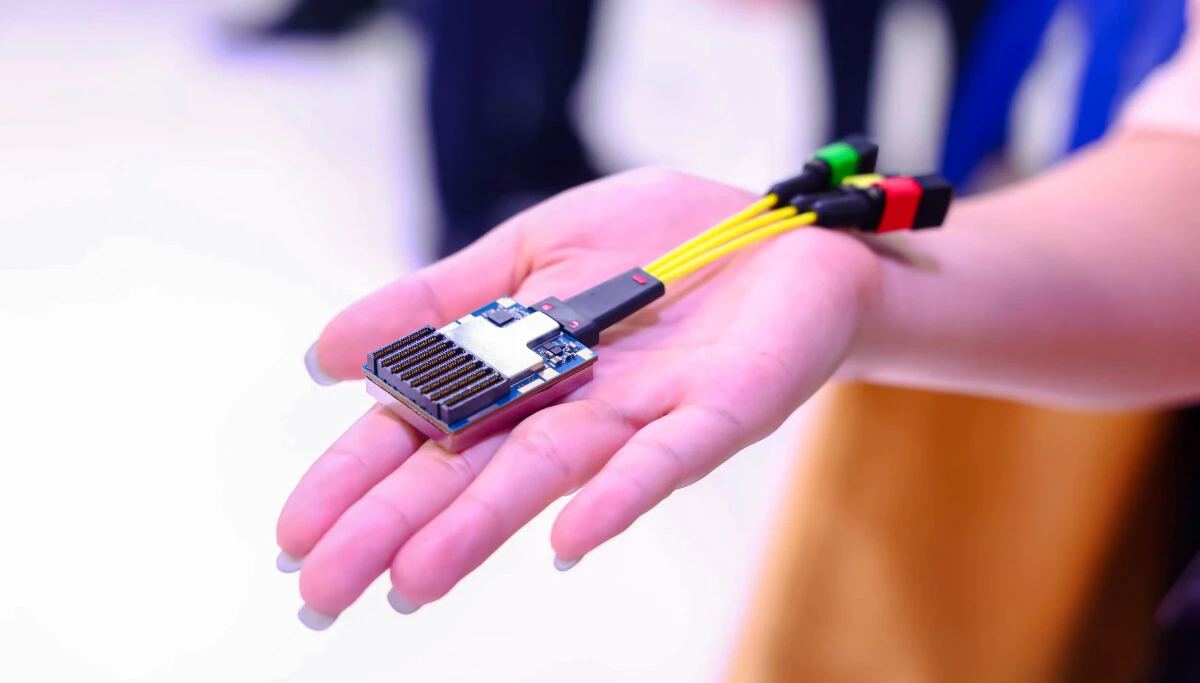
Kết nối quang AI là kiến trúc hạ tầng mạng dùng tín hiệu ánh sáng để truyền dữ liệu giữa GPU và các tài nguyên tính toán trong trung tâm dữ liệu, được thiết kế nhằm thay thế hoặc giảm vai trò của kết nối đồng truyền thống khi các cụm AI mở rộng lên hàng chục nghìn nút với nhu cầu băng thông ở mức terabit mỗi giây và độ trễ cực thấp. Khi số lượng GPU hoặc bộ tăng tốc AI trong một cụm tăng từ hàng nghìn lên hàng chục nghìn, thậm chí hàng trăm nghìn chip, lượng dữ liệu phải trao đổi giữa các chip tăng nhanh đến mức hệ thống kết nối có thể trở thành điểm nghẽn. Nói cách khác, băng thông giữa các chip đã trở thành tài nguyên quan trọng không kém năng lực tính toán của chính GPU trong hạ tầng mạng AI.
Đây là lý do ngành bán dẫn và hạ tầng AI đang chuyển mạnh sang kết nối quang học, trong đó tín hiệu dữ liệu được truyền bằng ánh sáng thay vì tín hiệu điện. Trong huấn luyện và suy luận phân tán, nhiều GPU phải trao đổi dữ liệu liên tục; khi băng thông kết nối không theo kịp hoặc một tuyến bị gián đoạn, bộ xử lý phải chờ dữ liệu dù công suất tính toán vẫn còn. Thương vụ đầu tư vào các doanh nghiệp mạng quang cho thấy có thêm bộ xử lý chưa đủ nếu mạng không thể chuyển dữ liệu và thích ứng với lỗi ở quy mô cụm. Bối cảnh này là “vì sao bây giờ”: kết nối đã trở thành nút thắt thật sự của AI.
IEEE P802.3dj và cuộc đua 1.6 Tbps trong hạ tầng mạng AI
Trong bức tranh kết nối quang AI, chuẩn IEEE 1.6 Tbps đang đóng vai trò trục xương sống. Các mạng luôn được thúc đẩy bởi nhu cầu tăng tốc độ và băng thông, và trong thời đại AI, động lực đó đang tăng tốc lộ trình lên kết nối 1,6 terabit. Công việc bắt đầu từ 2020 và trở thành nhóm nghiên cứu chính thức, sau đó là Task Force IEEE P802.3dj, hiện đã bước vào giai đoạn bỏ phiếu và rà soát chính thức, với khả năng hoàn tất trong năm nay. Điều quan trọng là nhu cầu không chờ chuẩn: phần cứng 1,6T đã được mang ra thử nghiệm tương tác tại các sự kiện chuyên ngành, với switch, module và cáp từ hơn chục nhà cung cấp khác nhau.
Song song, một thỏa thuận triển khai 1600ZR được công bố như giao diện quang kết hợp có thể mang trọn kết nối Ethernet 1,6 terabit trên một bước sóng duy nhất, ở khoảng cách tương đương giữa các tòa nhà trong khuôn viên hoặc trên phạm vi đô thị. Điều này cho thấy IEEE P802.3dj không chỉ là lý thuyết mà đang định hình lớp vật lý cho hạ tầng mạng AI từ trong rack tới liên kết campus. Khi hạ tầng mạng AI buộc phải đi lên 1,6T để theo kịp cụm GPU, chuẩn mở sẽ là vũ khí cân bằng thế lực giữa các nhà cung cấp thiết bị, thay vì để một vài hệ sinh thái độc quyền quyết định cuộc chơi.
Huawei, NPO và tham vọng viết lại kiến trúc kết nối quang AI
Nếu IEEE P802.3dj là khung luật chơi, các nhà cung cấp thiết bị lại đang tranh nhau định nghĩa cách triển khai. Huawei đang muốn đưa quang học đến gần chip hơn thông qua kiến trúc Hi-ONE, một dạng quang học gần đóng gói (NPO), nhằm rút ngắn khoảng cách điện giữa chip AI và bộ phận quang học từ khoảng 1 m xuống khoảng 5 cm. Huawei trình diễn module NPO băng thông tới 7,2–8 Tb/s mỗi module trong các tài liệu kỹ thuật và sự kiện chuyên ngành, đồng thời cho biết có thể mở rộng khoảng cách truyền quang lên tới 100 m. Hệ thống dự kiến được cung cấp từ quý IV/2026.
Điểm chiến lược nằm ở chỗ NPO được Huawei quảng bá như lựa chọn thực tế hơn so với công nghệ quang học đồng đóng gói (CPO) ở thời điểm hiện tại. TrendForce dự báo công nghệ quang học đồng đóng gói (CPO) sẽ ngày càng phổ biến trong trung tâm dữ liệu AI và có thể đạt tỷ lệ thâm nhập khoảng 35% vào năm 2030. Tuy vậy, CPO yêu cầu đóng gói tiên tiến, chi phí cao và khó bảo trì khi phần quang hỏng được gắn chung substrate với ASIC. Huawei nêu quan điểm rằng NPO dễ sản xuất hàng loạt và dễ bảo trì hơn, trong khi vẫn loại bỏ DSP riêng trong module bằng cách tích hợp chức năng vào ASIC, giúp giảm độ trễ từ 100 ns xuống 10 ns và tiết kiệm khoảng 60% điện năng.
Công nghệ CPO, chuyển mạch GPU và case iPronics
Song song với NPO, công nghệ CPO (co-packaged optics) vẫn là biểu tượng của tham vọng kéo quang học sát lõi xử lý nhất có thể: động cơ quang nằm trên cùng substrate với ASIC của switch. TrendForce dự báo CPO sẽ chiếm khoảng 35% trung tâm dữ liệu AI vào năm 2030, trong khi các nền tảng AI Ethernet mới kết hợp chuyển mạch với quang học đồng đóng gói để phục vụ các “AI factory” quy mô rất lớn. Nói cách khác, CPO là câu trả lời triệt để cho bài toán giảm độ trễ và điện năng của lớp kết nối, đặc biệt ở tầng switch spine/leaf nối các cụm GPU. Nhưng CPO không giải quyết một mình toàn bộ bài toán hạ tầng mạng AI; nó vẫn cần các lớp chuyển mạch thông minh để thích ứng với tải và lỗi ở quy mô cụm.
Đây là chỗ iPronics bước vào với chuyển mạch mạch quang, tức lớp kết nối vật lý giữa các tài nguyên tính toán. Công ty phát triển nền tảng OCS trên quang tử silicon nhằm thiết lập đường quang trực tiếp giữa các điểm cần kết nối và có thể thay đổi cấu hình khi tải công việc hoặc trạng thái phần cứng biến động. Mục tiêu gần nhất là mở rộng hoạt động và tăng tốc triển khai thương mại iPronics ONE, nền tảng OCS dành cho kết nối trong và giữa các rack. Điều đáng chú ý là sự hiện diện của Nvidia dù iPronics không sản xuất GPU; vốn đang dịch chuyển sang “chuyển mạch GPU” ở tầng quang: nếu mạng không chuyển được dữ liệu và tự thích ứng với lỗi, cụm GPU dù mạnh vẫn bị lãng phí.
Tương lai hạ tầng mạng AI: luật Moore mới của băng thông?
Các động thái chuẩn hóa IEEE 1.6 Tbps, chiến lược NPO của Huawei và cuộc chơi CPO–OCS của nhiều nhà cung cấp cùng chỉ về một hướng: băng thông mạng sẽ tăng nhanh không kém tốc độ tiến bộ của GPU. Hạ tầng mạng AI đang chuyển từ tư duy “phụ trợ” sang “đồng đẳng” với tính toán, khi băng thông giữa các chip trở thành yếu tố quyết định hiệu suất cụm. Thương vụ iPronics cho thấy vốn đầu tư không chỉ tìm tới GPU, mà nhắm vào giới hạn khác của trung tâm dữ liệu AI: khả năng chuyển dữ liệu và thích ứng với lỗi ở quy mô lớn.
IEEE P802.3dj đang phát triển chuẩn kết nối 1,6 terabit để giải quyết nhu cầu băng thông của AI, trong khi các nhà cung cấp như Huawei đẩy mạnh quang học đóng gói và gần đóng gói để thay thế kết nối đồng truyền thống. Câu hỏi không còn là liệu kết nối quang AI có trở thành mặc định, mà là mô hình nào – CPO, NPO hay các kiến trúc chuyển mạch quang tái cấu hình – sẽ đóng vai trò “luật Moore” mới, định nghĩa nhịp độ tăng gấp đôi băng thông theo chu kỳ. Những ai kiểm soát được chuẩn mở lẫn kiến trúc quang đóng gói sẽ kiểm soát luôn nhịp phát triển của cả hệ sinh thái AI.