
Từ trả lời lý thuyết đến xử lý bằng chứng thật
BioBasicsBench là bộ chuẩn gồm 100 nhiệm vụ đánh giá khả năng tác tử AI diễn giải dữ liệu thí nghiệm thô, phát hiện sai sót và xử lý các công việc thường nhật trong phòng thí nghiệm sinh học. OpenAI giới thiệu bộ chuẩn này ngày 6 tháng 11 năm 2026, phối hợp với Ligo, công ty thiết kế enzyme. Điểm đáng chú ý không nằm ở việc AI trả lời thêm một loạt câu hỏi kiến thức, mà ở chỗ nó phải làm việc với bằng chứng lộn xộn như nhà khoa học vẫn gặp hằng ngày. Bộ chuẩn bao quát năm lĩnh vực: phương pháp nghiên cứu protein, tạo ảnh và đo tế bào, định lượng và xét nghiệm, axit nucleic, cùng nhân dòng phân tử. AI phòng thí nghiệm chỉ có ích khi đọc được tình huống thực tế, chứ không chỉ diễn đạt trôi chảy kiến thức trong sách.
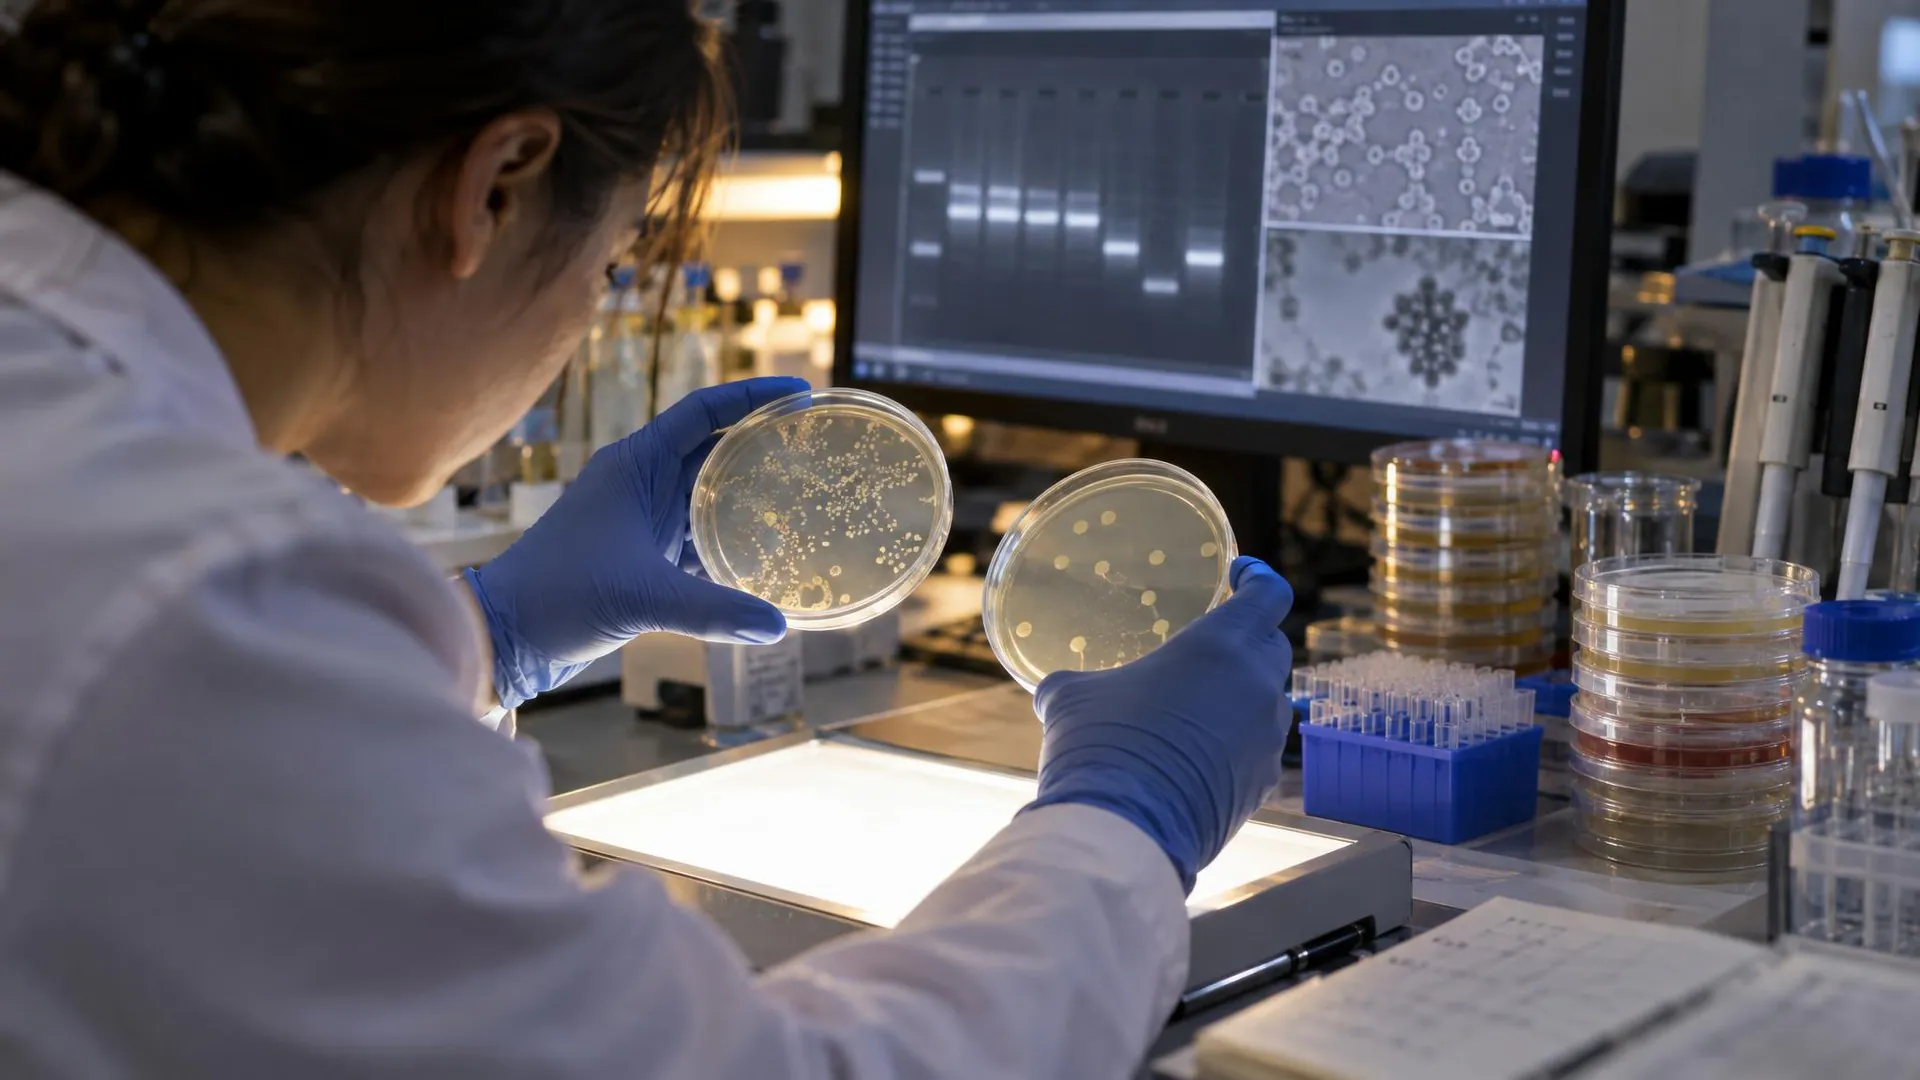
Nhiệm vụ trải từ đọc khối lượng phân tử DNA trên ảnh gel đến phân tích xét nghiệm chi tiết. Đầu vào có thể gồm ảnh gel và blot, đĩa khuẩn lạc, ảnh hiển vi, dữ liệu giải trình tự, tệp xuất từ máy đọc đĩa, ghi chép phòng thí nghiệm và video thao tác. Từng nhiệm vụ được xây dựng từ thí nghiệm thực tế, kèm tiêu chí chấm do chuyên gia soạn và qua các vòng rà soát khoa học. Cách thiết kế này thuyết phục hơn những bài kiểm tra chỉ dùng biểu đồ đẹp, vì nó đặt tác tử trước nhiều dạng dữ liệu thí nghiệm vốn không phải lúc nào cũng rõ ràng.
Điểm số cho thấy tiến bộ, chưa chứng minh độ tin cậy
Ở mức suy luận xhigh, GPT-6 Astra đạt trung bình 66,7% số điểm tối đa, so với 43,8% của GPT-5.6 Sol. Đây là khoảng cách đáng kể trong cùng một bộ chuẩn, nhưng 66,7% cũng nhắc rằng còn nhiều nhiệm vụ chưa được xử lý trọn vẹn. Astra tạo trung bình 4.704 token đầu ra mỗi nhiệm vụ, trong khi Sol tạo 9.099 token. Việc dùng ít token hơn mà đạt điểm cao hơn là một kết quả đáng chú ý, song độ dài câu trả lời không thể thay thế việc kiểm tra xem kết luận có đúng và có căn cứ hay không. Điểm tổng hợp hữu ích để so sánh mô hình; nó không phải giấy chứng nhận rằng AI đã sẵn sàng đưa ra phán đoán đáng tin trong phòng thí nghiệm.
BioBasicsBench chấm từng tiêu chí riêng, từ kết luận và phép đo đến lập luận hỗ trợ, đồng thời ghi nhận khi bằng chứng chưa đủ. Cách chấm này giúp phân biệt một câu trả lời đúng tình cờ với phân tích có thể kiểm chứng. Tuy nhiên, kết quả trên bộ chuẩn vẫn chỉ phản ánh các nhiệm vụ đã chọn và tiêu chí đã viết. Muốn đánh giá tác tử AI trong nghiên cứu sinh học, cần chú ý không chỉ điểm trung bình mà cả kiểu lỗi, khả năng nhận ra giới hạn dữ liệu và mức nhất quán khi gặp tình huống mới.
Sai một đối chứng, lệch cả hướng nghiên cứu
Lý do bộ chuẩn này cần thiết nằm ở khoảng cách giữa bằng chứng trình bày trong bài báo và công việc thường ngày. Thí nghiệm có thể thất bại, ảnh có thể mơ hồ, còn các quan sát có thể mâu thuẫn; những bộ đánh giá dựa trên hình ảnh và biểu đồ đã tuyển chọn thường bỏ qua phần khắc phục sự cố ấy. Nếu tác tử đọc nhầm ảnh hoặc bỏ qua lỗi ở đối chứng, nhà nghiên cứu có thể rút ra kết luận sai rồi mất thời gian vào thí nghiệm không trả lời được câu hỏi. Vì vậy, hỗ trợ khoa học không thể chỉ là đưa ra một đáp án có vẻ hợp lý. Tác tử phải đối chiếu các kiểm soát thí nghiệm, giữ được những quan sát quan trọng trong kết luận và biết dừng lại khi dữ liệu không đủ.
Đó là tiêu chuẩn thực tế quan trọng hơn một điểm số cao: tác tử phải đưa quan sát chính xác vào kết luận, kiểm tra đối chứng và không khẳng định điều mà bằng chứng không thể hỗ trợ. BioBasicsBench tạo một bước tiến hữu ích vì đưa những yêu cầu đó vào phép thử có chấm điểm, nhưng chưa thể tự nó xác nhận độ tin cậy của AI trong mọi phòng thí nghiệm. Kết luận hợp lý là lạc quan có điều kiện: bộ chuẩn đo được những kỹ năng gần với thực hành hơn, còn việc giao cho AI vai trò hỗ trợ nghiên cứu vẫn đòi hỏi con người rà soát dữ liệu và phán đoán.