
AI thực tế cần hơn mô hình: cần dữ liệu và phép thử sát công việc
AI vật lý là lĩnh vực phát triển các hệ thống AI có thể nhận biết môi trường và điều khiển máy móc trong thế giới thật; năng lực của nó phụ thuộc không chỉ vào mô hình mà còn vào dữ liệu vận hành và cách kiểm chứng quyết định. Hai sáng kiến được công bố trong tháng 11 cho thấy nỗ lực đưa AI ra khỏi những bài kiểm tra gọn gàng: Serve Robotics mở công cụ phục vụ các đội robot, còn OpenAI cùng Ligo xây bộ chuẩn dựa trên thí nghiệm phòng lab.
Điểm đáng chú ý không phải là tuyên bố AI đã sẵn sàng làm việc độc lập, mà là sự mở rộng của hạ tầng để tạo dữ liệu và kiểm tra năng lực trong bối cảnh thực tế. Ngày 5 tháng 11 năm 2026, Serve Robotics công bố Physical AI Services, cung cấp công cụ kết nối robot, tuyển chọn dữ liệu và tạo dữ liệu huấn luyện từ thế giới thực cho các công ty phát triển AI vật lý. Ngày hôm sau, OpenAI giới thiệu BioBasicsBench, gồm 100 nhiệm vụ đánh giá khả năng diễn giải dữ liệu thí nghiệm của tác tử AI.
Đây là bước tiến có ý nghĩa vì những hệ thống AI thường thất bại không phải trước câu hỏi mẫu, mà trước ngoại lệ, dữ liệu lộn xộn và tín hiệu mơ hồ. Nhưng mở dữ liệu hay dựng bài kiểm tra mới chỉ tạo điều kiện để đo tiến bộ; điều đó chưa chứng minh được độ tin cậy khi AI phải hành động trong môi trường thật.
Serve biến kinh nghiệm vận hành thành dữ liệu huấn luyện robot
Serve Robotics đang thương mại hóa hạ tầng được phát triển khi mở rộng chính đội robot của mình. Công ty cho biết đã triển khai hơn 2.000 robot tại hơn 40 thành phố và 27 bệnh viện; dịch vụ mới hiện vận hành hàng nghìn phương tiện trong một tá ngành công nghiệp. Quy mô đó tạo ra một lợi thế tiềm năng: không chỉ có robot mà còn có quy trình kết nối, theo dõi và xử lý dữ liệu phát sinh khi máy hoạt động.
Bộ công cụ gồm Serve Link để kết nối máy móc với mô hình, giám sát và hệ thống huấn luyện; công cụ này hỗ trợ quản lý tác vụ, theo dõi trạng thái thiết bị, hỗ trợ từ xa và thu thập các trường hợp khó. Serve Data Curator xử lý lượng lớn dữ liệu cảm biến, giúp kỹ sư tìm kiếm tình huống, điều tra sự cố và chọn ví dụ cho bộ dữ liệu huấn luyện robot. Các ví dụ được tuyển chọn có thể dùng cho cả huấn luyện lẫn đánh giá, nối dữ liệu ngoài thực địa với các vòng phát triển mô hình tiếp theo.
Giá trị thực tiễn nằm ở việc khách hàng có thể dùng sẵn lớp hạ tầng kết nối và tuyển chọn dữ liệu, thay vì tự dựng mọi thứ trước khi tập trung vào máy móc của mình. Tuy vậy, kinh nghiệm từ robot giao hàng trên vỉa hè không tự động chuyển nguyên vẹn sang thiết bị xây dựng, khai thác mỏ hay vận tải. Câu hỏi quan trọng là dữ liệu và quy trình của Serve giúp ích đến đâu trong những môi trường khác biệt đó.
BioBasicsBench đưa những tình huống khó trong phòng lab vào bài kiểm tra
BioBasicsBench nhắm vào một khoảng trống trong các đánh giá AI khoa học: biểu đồ và hình ảnh được chọn lọc từ bài báo thường không phản ánh công việc thường nhật, nơi có thí nghiệm thất bại, hình ảnh khó đọc, kết quả mâu thuẫn và nhu cầu khắc phục sự cố. Bộ chuẩn gồm 100 nhiệm vụ yêu cầu tác tử AI diễn giải bằng chứng, nhận ra lỗi và thừa nhận khi dữ liệu chưa đủ để kết luận.
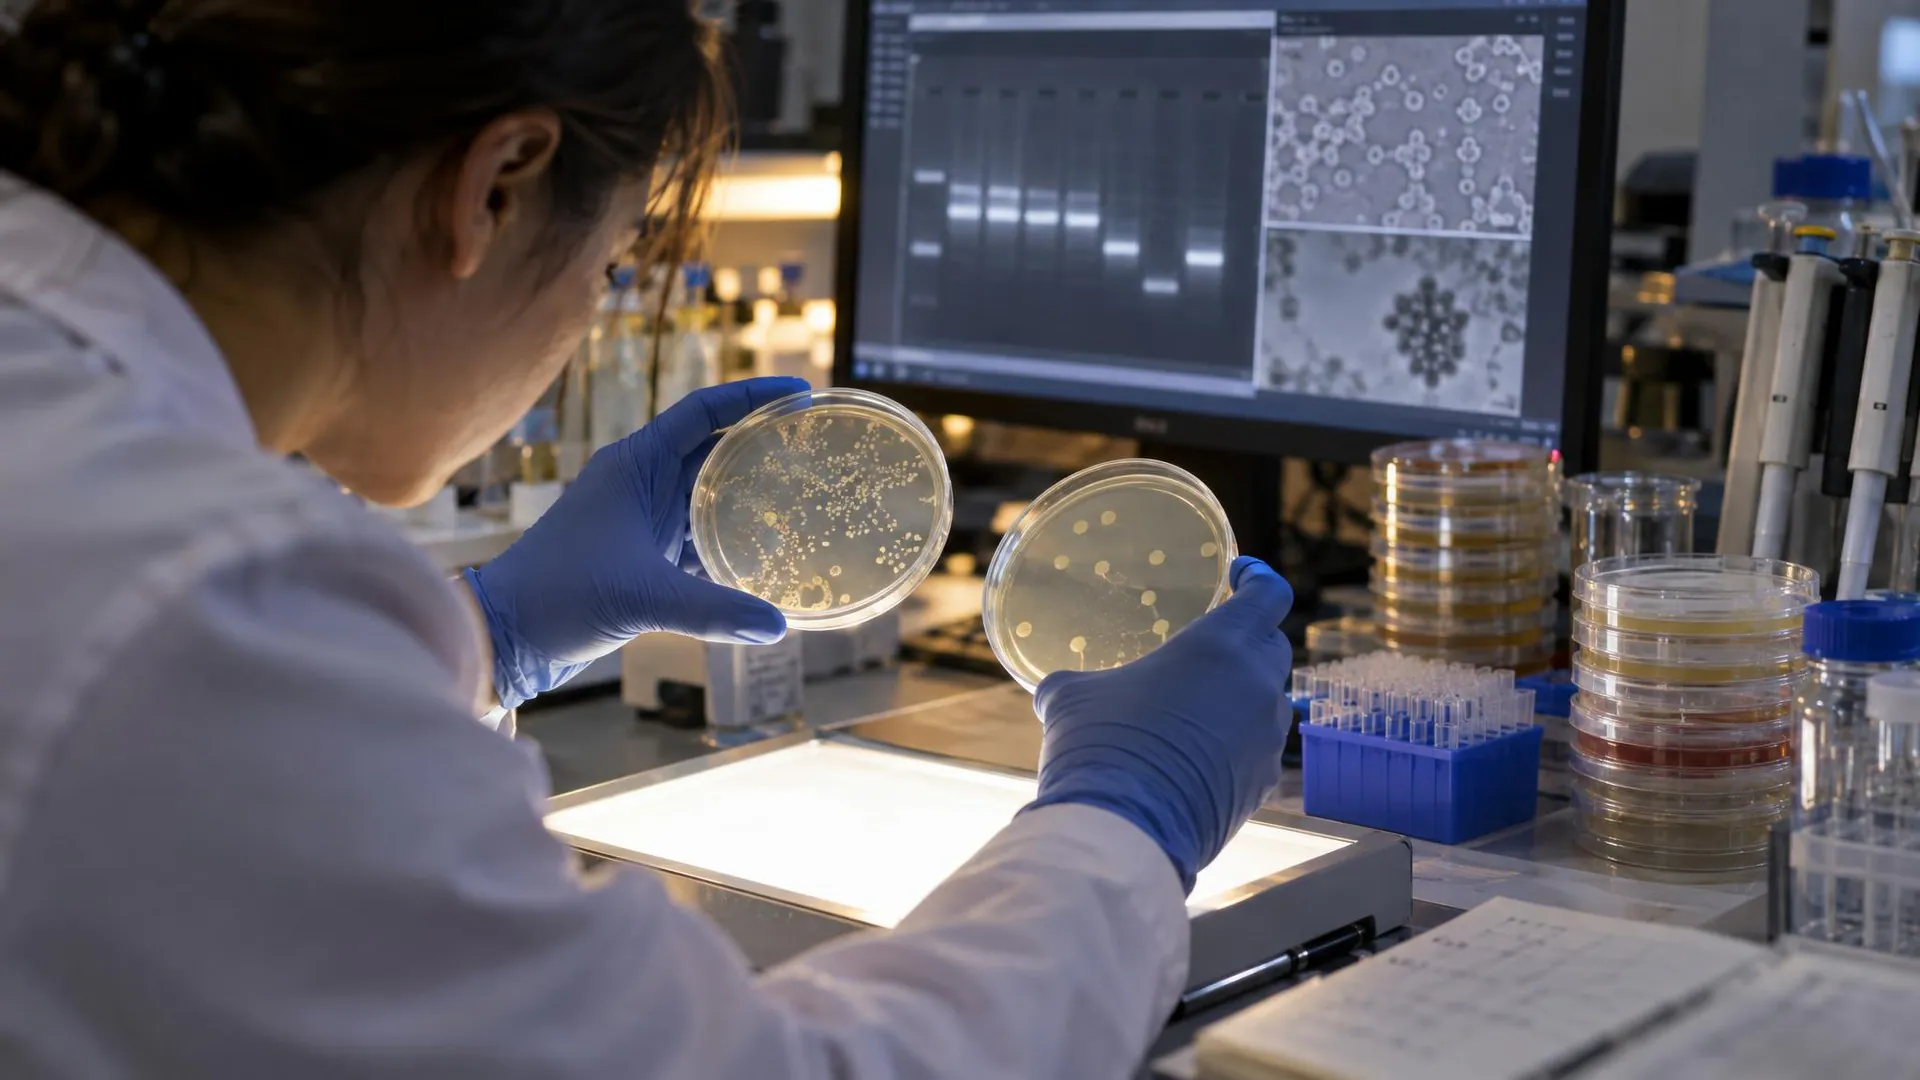
Đầu vào gồm hình ảnh gel và blot, đĩa nuôi cấy khuẩn lạc, chuỗi ảnh hiển vi, dữ liệu giải trình tự, tệp từ máy đọc đĩa, ảnh chụp tại bàn thí nghiệm và video quy trình. Các nhiệm vụ do nhà khoa học xây dựng từ thí nghiệm của họ, sau đó được rà soát và chấm theo tiêu chí có cấu trúc. Nhờ vậy, dữ liệu phòng thí nghiệm trong bài kiểm tra không chỉ là hình ảnh minh họa đẹp mắt, mà còn chứa những dấu hiệu cần đọc cùng bối cảnh thực nghiệm.
Ở mức suy luận xhigh, GPT-6 Astra đạt 66,7% điểm trung bình, với khoảng tin cậy 95% từ 60,3% đến 73,1%; GPT-5.6 Sol đạt 43,8%, với khoảng từ 37,6% đến 50,0%. Đánh giá bao gồm 37 cấu hình mô hình và mức suy luận, mỗi cấu hình làm mỗi nhiệm vụ năm lần, tạo thành 18.500 kết quả. Quy mô kiểm tra đáng kể, nhưng điểm số chỉ đo hiệu suất trên bộ nhiệm vụ đã thiết kế, không phải giấy chứng nhận năng lực làm thí nghiệm an toàn.
Khoảng cách giữa điểm chuẩn và độ tin cậy vẫn còn
Các ví dụ trong BioBasicsBench cho thấy khác biệt giữa đọc được dữ liệu và suy luận đúng từ dữ liệu. Trong một tình huống, Astra nhận ra nhãn kháng sinh trên đĩa đối chứng không khớp với thí nghiệm và bác bỏ đĩa đó; ở nhiệm vụ khác, mô hình nhận diện chồng ảnh theo trục z thay vì gán hiện tượng cho nguyên nhân sinh học. Đây là những năng lực hữu ích, nhưng bộ chuẩn cũng ghi nhận sai lầm có thể dẫn đến chọn nhầm plasmid hoặc bỏ qua quan sát trái chiều.
Bài học rộng hơn áp dụng cho cả robot lẫn phòng thí nghiệm: dữ liệu nhiều hơn và môi trường kiểm thử sát thực tế hơn có thể làm lộ điểm yếu, nhưng không tự biến một hệ thống thành đáng tin cậy. Với robot, cần chứng minh rằng hạ tầng và dữ liệu có thể chuyển giao giữa các loại máy, địa hình và điều kiện mạng. Với tác tử nghiên cứu, mô hình phải đưa quan sát chính xác vào kết luận cuối, kiểm tra đối chứng và không khẳng định điều mà bằng chứng không hỗ trợ.
Bước tiếp theo vì thế nên là các vòng đánh giá liên tục, trong đó lỗi thực tế định hướng dữ liệu được thu thập và nhiệm vụ cần kiểm tra. Serve cho biết hiệu suất mô hình có thể giúp các nhóm chọn ví dụ để tuyển chọn, thu thập hoặc mô phỏng trong những đợt huấn luyện sau. OpenAI cũng cho biết theo dõi sự phát triển của năng lực này sẽ hỗ trợ đánh giá hệ quả về an toàn sinh học và an ninh sinh học.
Hai sáng kiến không chứng minh AI đã sẵn sàng vận hành độc lập; chúng cho thấy cách kiểm chứng đang tiến gần hơn tới công việc thật. Đó là hướng đi đáng khuyến khích, miễn là ngành công nghệ không đánh đồng quyền truy cập dữ liệu hay điểm chuẩn cao với bằng chứng về độ tin cậy. Thước đo cuối cùng phải là khả năng xử lý ngoại lệ, giải thích giới hạn và đưa ra quyết định đúng trong điều kiện triển khai thực tế.