
Mô hình AI nhỏ gọn là gì và bức tranh MoE vs nén
Mô hình AI nhỏ gọn là các mô hình ngôn ngữ được thiết kế để tối ưu giữa số tham số hoạt động, kích thước trọng số và độ trễ, nhằm chạy hiệu quả trên AI thiết bị biên, máy tính cá nhân hoặc hạ tầng chi phí thấp mà vẫn giữ được đủ chất lượng cho tác vụ suy luận, tác nhân và xử lý ngữ cảnh dài. Trong thế hệ mới, có hai hướng tiếp cận nổi bật: kiến trúc MoE thưa thớt, nơi chỉ một phần chuyên gia được kích hoạt mỗi token, và nén trọng số 1-bit, nơi toàn bộ mạng dense được mã hóa lại để giảm kích thước tệp nhiều lần. Bài viết này đi thẳng vào câu hỏi quyết định: với các workload cụ thể, bạn nên chọn Dory 1.0 4B, LFM2.5-2.6B-Base, Solar Mini 4 hay Bonsai 27B 1-bit, và khi nào nên chấp nhận chi phí của Qwen3.8-27B BF16.
| Spec | A | B |
|---|---|---|
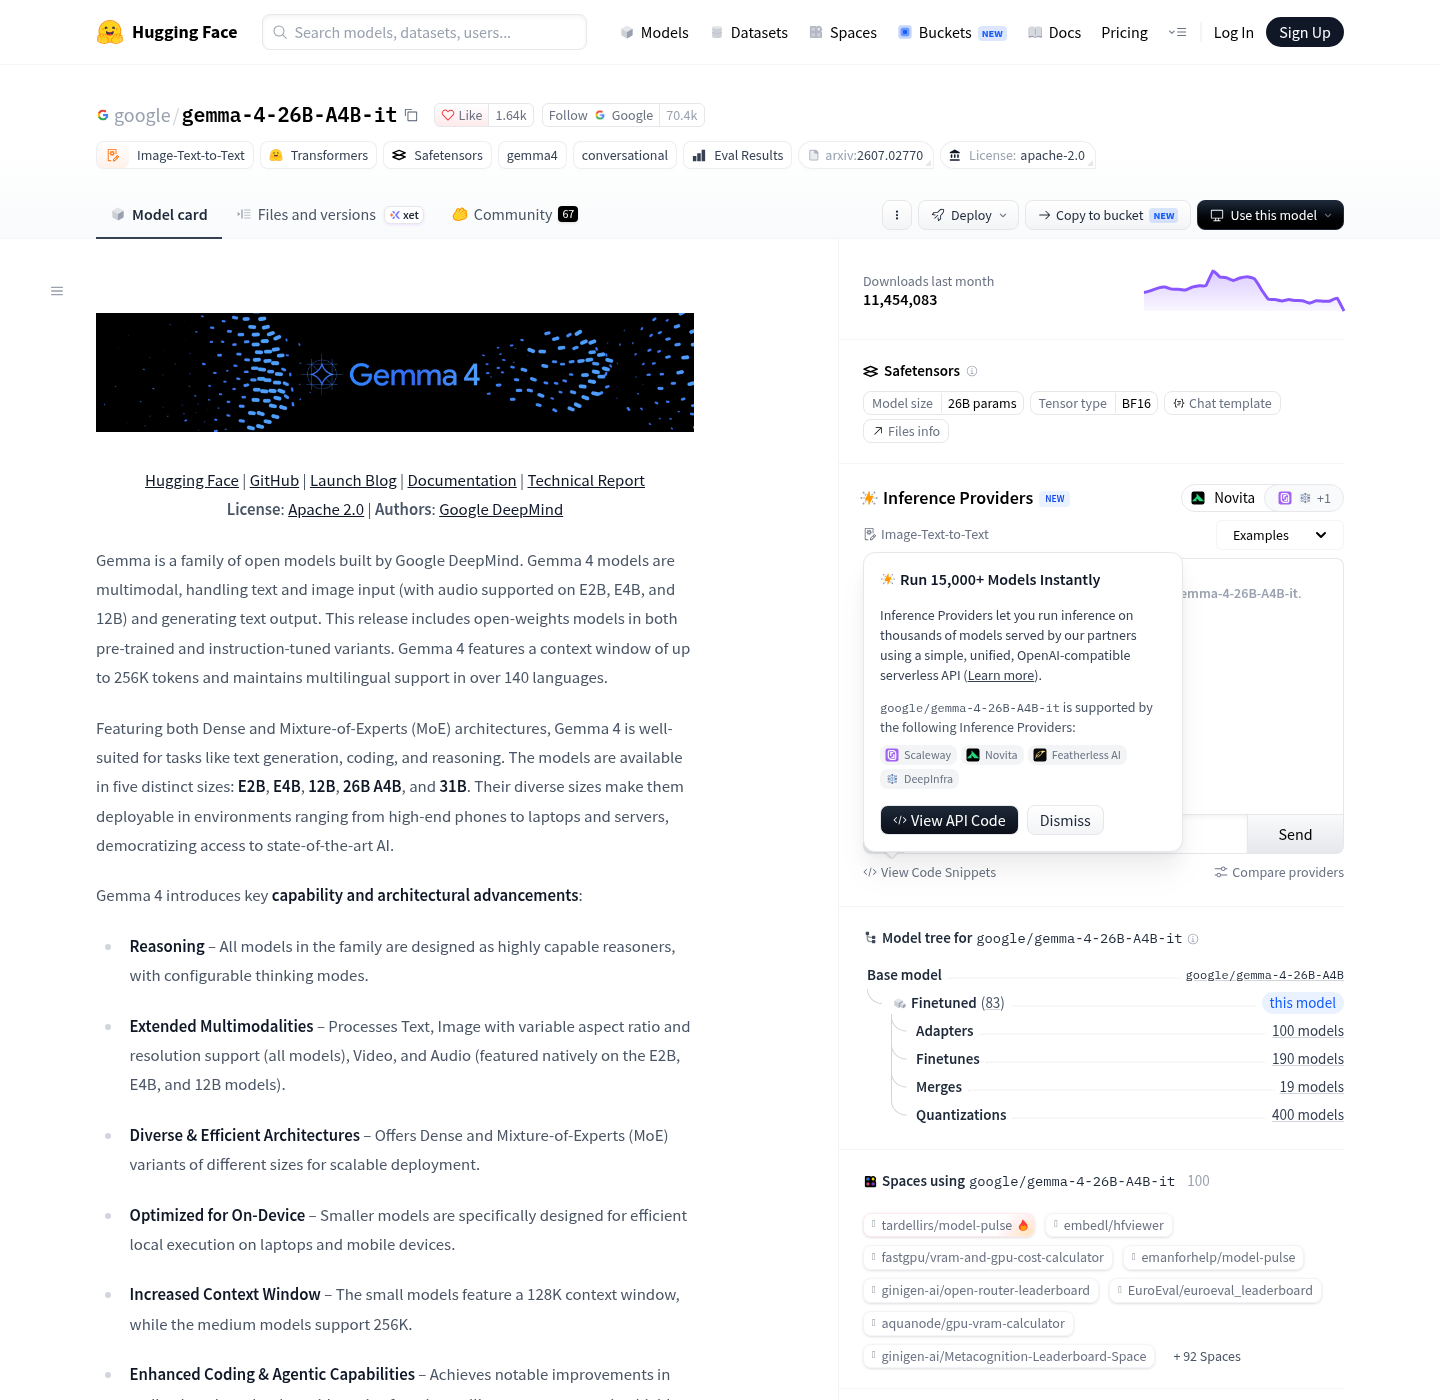
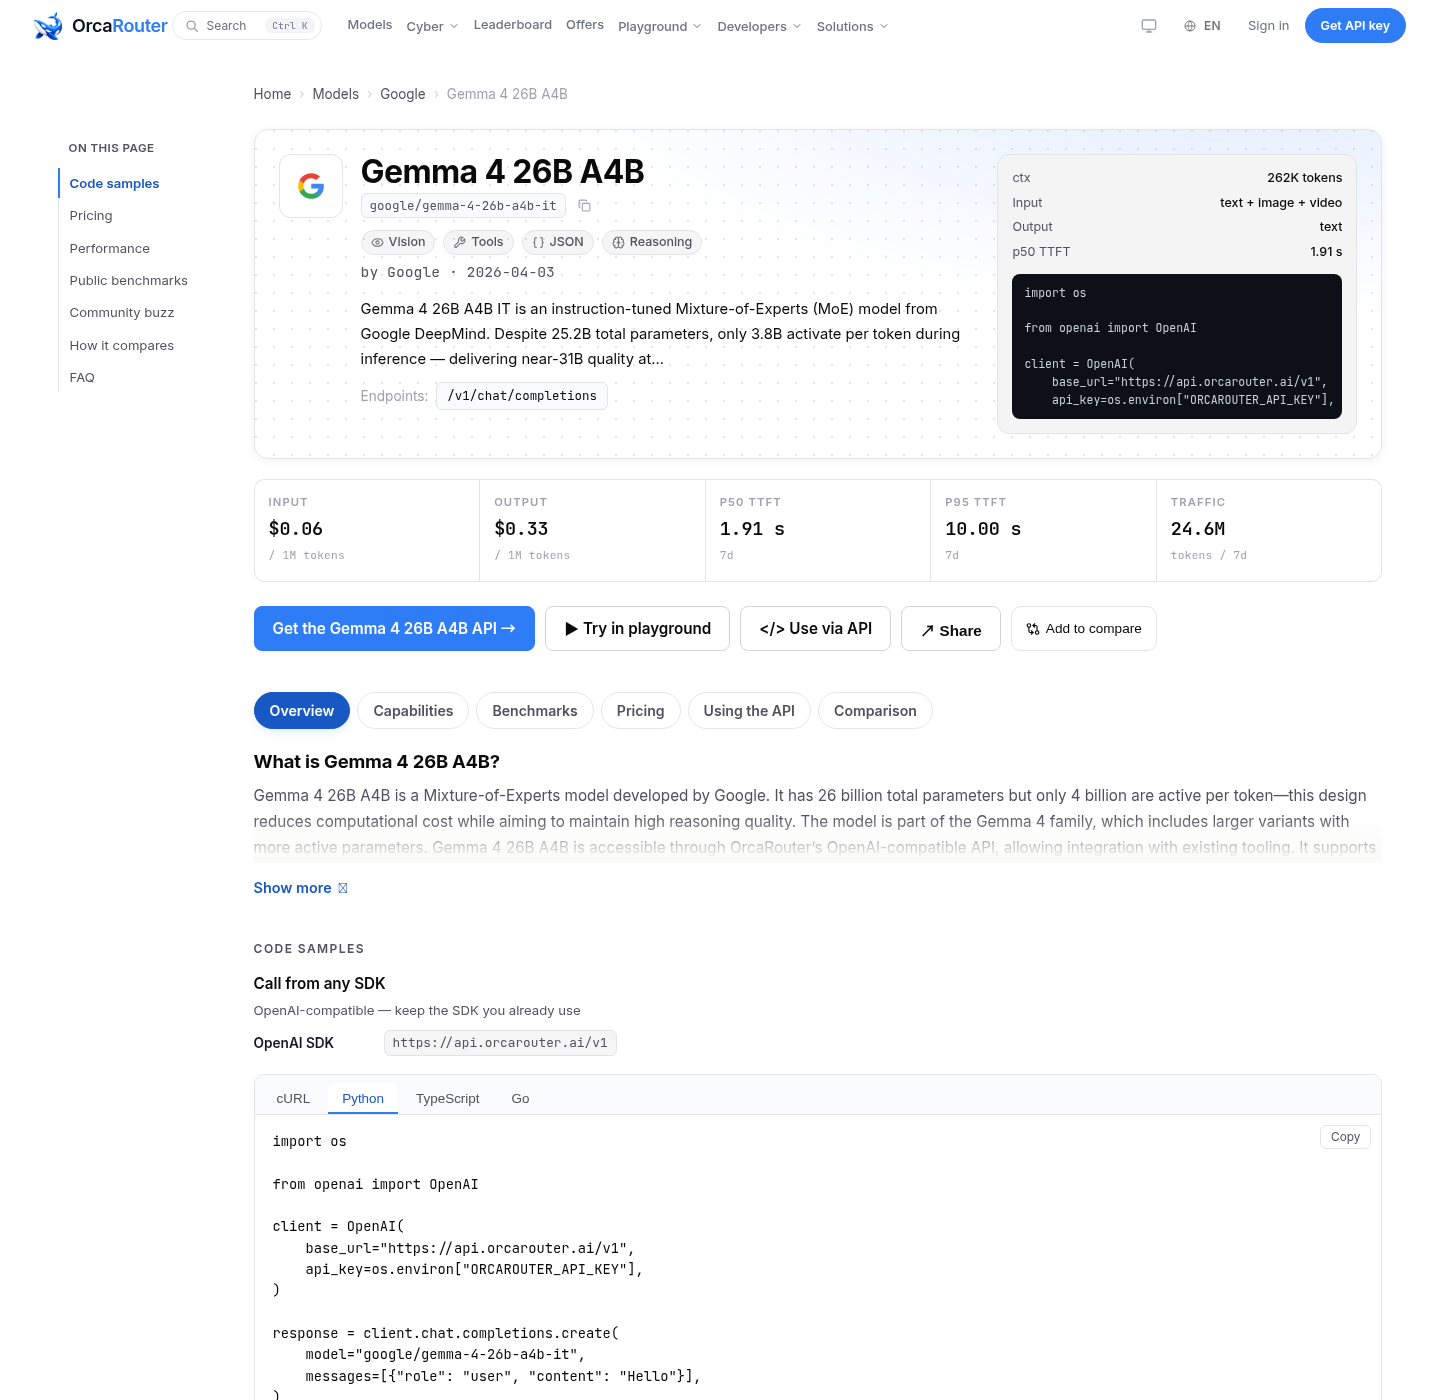
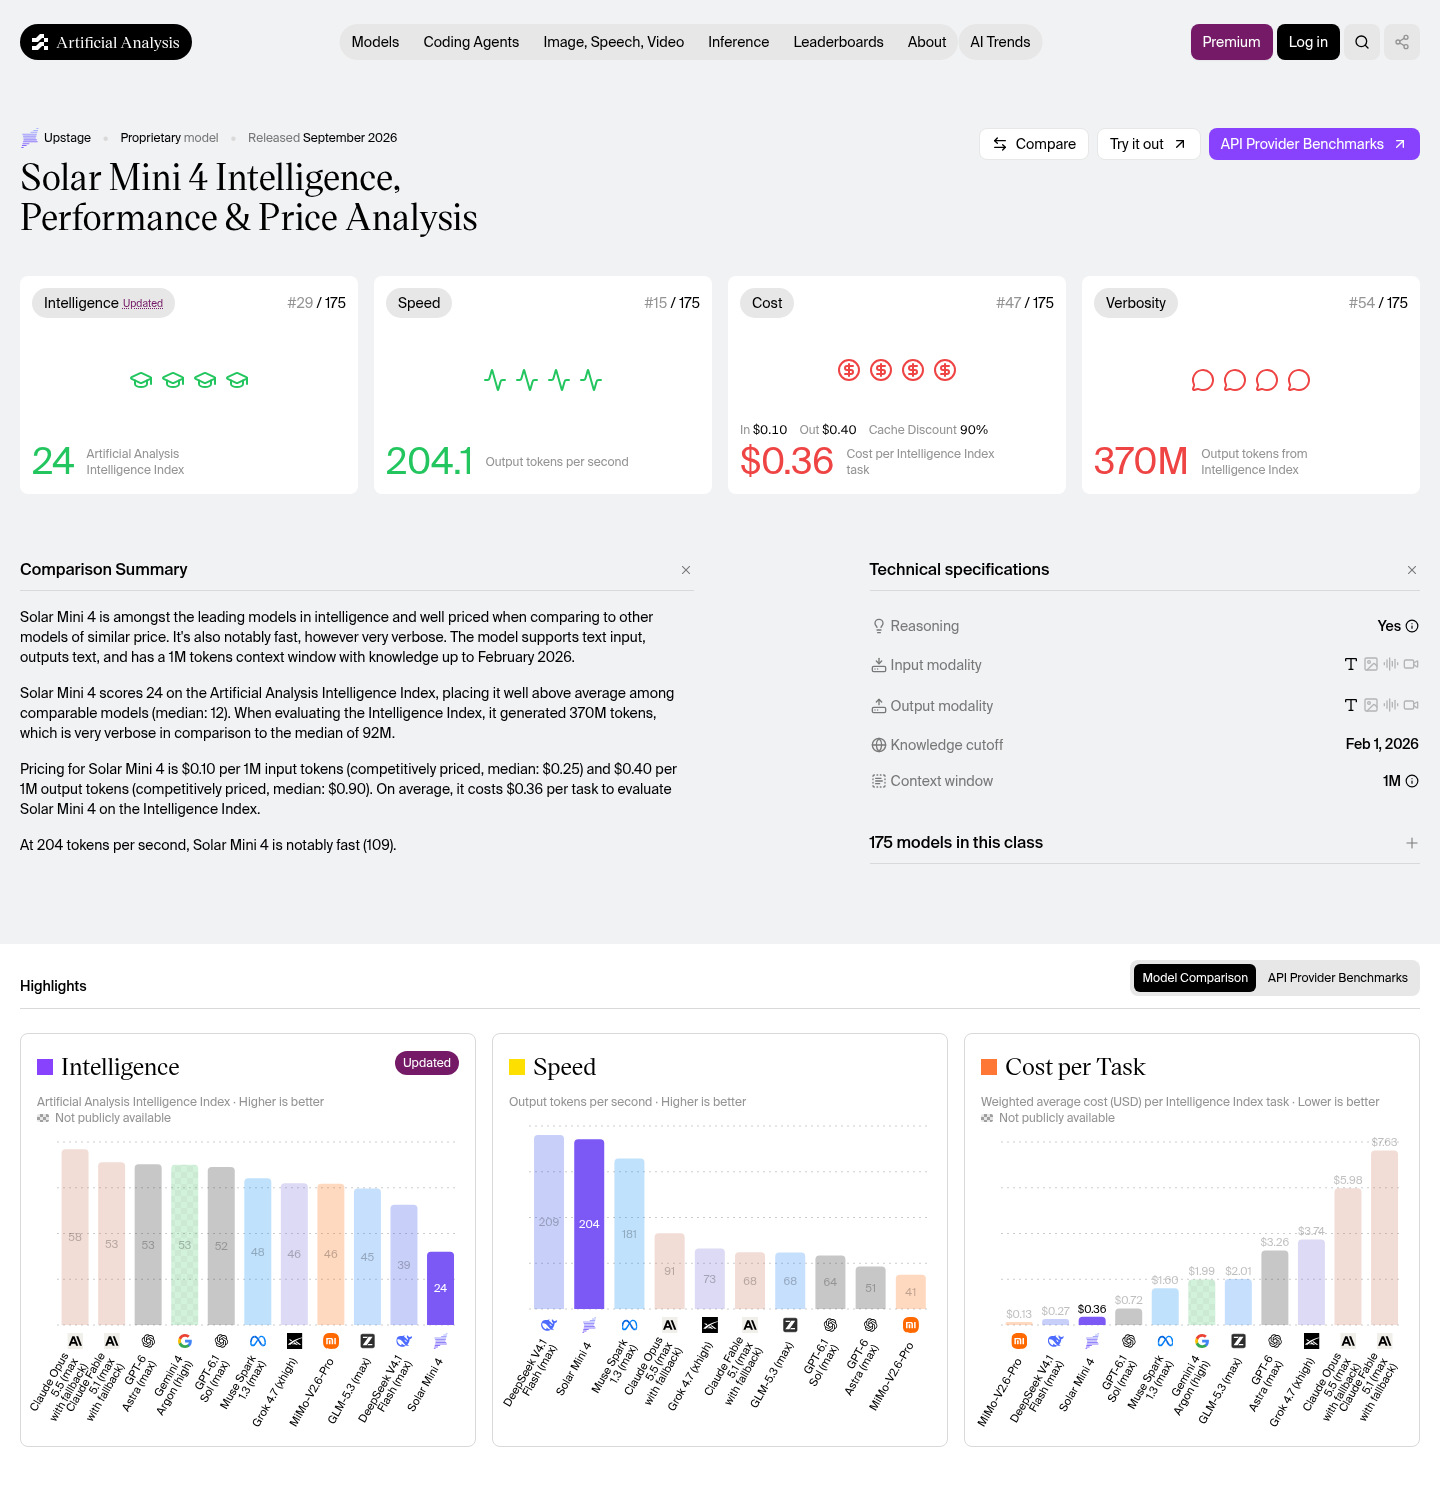
| Tổng tham số / tham số hoạt động | Solar Mini 4: 35B tổng, ~3B hoạt động mỗi token | LFM2.5-24B-A2B: 24B tổng, 2,45B hoạt động mỗi token; Gemma 4 26B-A4B: 25,2B tổng, 3,8B hoạt động mỗi token |
| Kích thước trọng số | Bonsai 27B 1-bit: 3,803 GB GGUF Q1_0 (≈1,125 bit/trọng số) | Qwen3.8-27B BF16: 55,59 GB safetensors dense |
| Ngữ cảnh tối đa | Dory 1.0 4B: 256K token tiếng Anh; Solar Mini 4: 512K token, đầu ra 128K | LFM2.5-24B-A2B: 131.072 token; Gemma 4 26B-A4B: 262.144 token với attention lai và cửa sổ trượt |
| Trạng thái hậu huấn luyện | Dory 1.0 4B: đã SFT + GRPO, suy luận bật sẵn trong đường phục vụ | LFM2.5-2.6B-Base: checkpoint tiền huấn luyện, chỉ khuyến nghị cho tinh chỉnh chuyên sâu |
| Đa phương thức | Solar Mini 4: tác nhân văn bản, hỗ trợ tiếng Anh, Hàn, Nhật; Bonsai 27B: văn bản + hình ảnh | Qwen3.8-27B: văn bản, hình ảnh, thêm video; Gemma 4 26B-A4B: văn bản + hình ảnh với bộ mã hóa ~550M tham số |
Dory 1.0 4B vs LFM2.5-2.6B-Base: phục vụ ngay hay đầu vào cho tinh chỉnh
Ở lớp 2–4B, câu hỏi không phải là mô hình nào mạnh hơn, mà là bạn đang mua cho nửa nào của quy trình: phục vụ suy luận hay tinh chỉnh chuyên sâu. Dory 1.0 4B là mô hình dense đã hoàn thiện, được tinh chỉnh có giám sát trên tập do NVIDIA tuyển chọn, sau đó là học tăng cường đa môi trường với GRPO, và suy luận được bật vĩnh viễn trong đường phục vụ vLLM. Đây là lựa chọn hợp lý nếu bạn muốn một mô hình tiếng Anh, ngữ cảnh 256K, có xu hướng “nghĩ trước khi trả lời” cho tác vụ agentic nhẹ mà không phải tự xây pipeline huấn luyện. Ngược lại, LFM2.5-2.6B-Base được mô tả rõ ràng là checkpoint tiền huấn luyện, “chỉ được khuyến nghị cho các tác vụ đòi hỏi tinh chỉnh chuyên sâu” và có phiên bản instruct riêng cho tác vụ tác tử. Dòng LFM2.5 còn được xây dựng để triển khai ngay trên thiết bị, với bản instruct 2,6B đạt khoảng 220 token/giây trên Apple M5 Max và 113 trên Ryzen AI Max+ 395 trong chưa đầy 2,5 GB bộ nhớ, cùng tốc độ cấp điện thoại khoảng 30 token/giây.
Solar Mini 4 và các kiến trúc MoE thưa thớt: tác nhân khối lượng lớn, ngữ cảnh dài
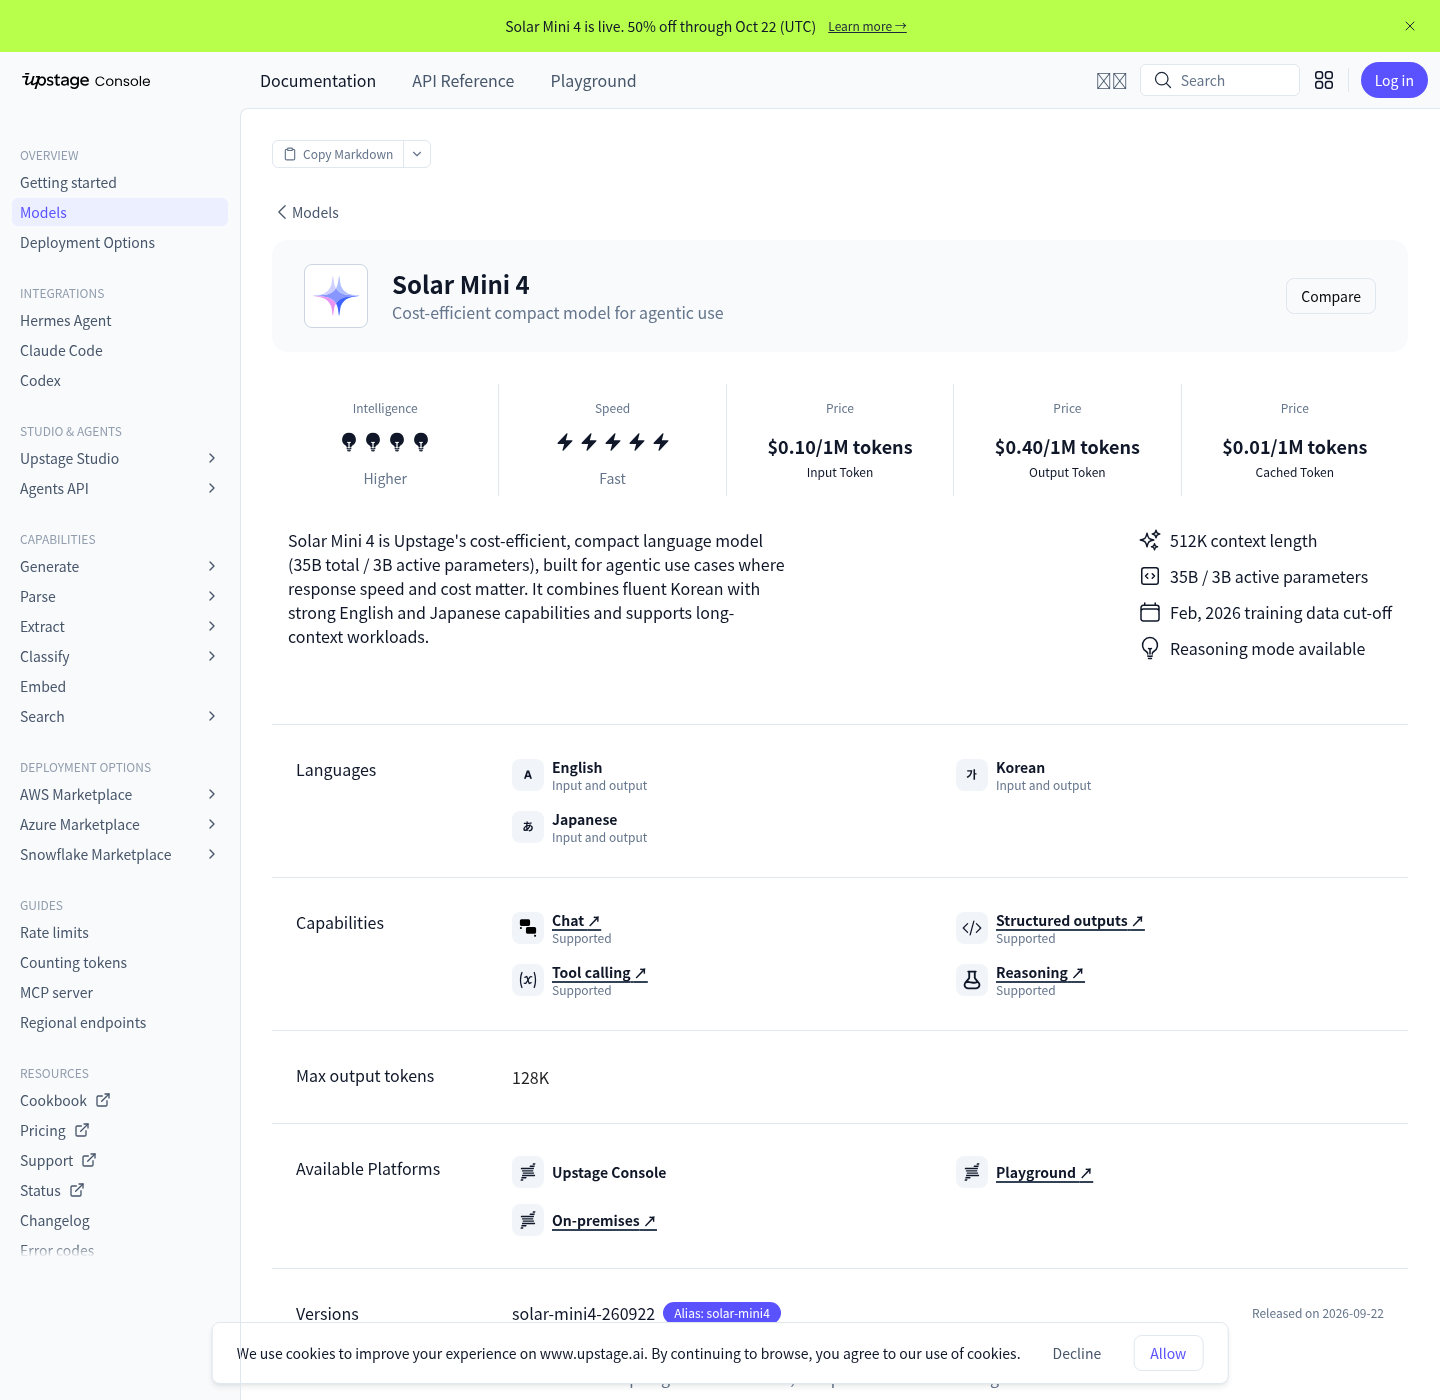
Solar Mini 4 là ví dụ điển hình cho mô hình AI nhỏ gọn dùng kiến trúc MoE thưa thớt để phục vụ tác nhân khối lượng lớn. Trang mô hình ghi rõ: 35B tổng tham số với khoảng 3B tham số hoạt động mỗi token, trong thiết kế mixture-of-experts thưa, nghĩa là toàn bộ trọng số vẫn phải nằm trong bộ nhớ dù mỗi token chỉ dùng một phần nhỏ. Cửa sổ ngữ cảnh 512K token và đầu ra tối đa 128K cho phép nó xử lý tài liệu rất dài bằng tiếng Anh, Hàn, Nhật, với chi phí suy luận được định vị là “tiết kiệm cho việc sử dụng tác nhân”. Ở cùng triết lý MoE thưa thớt, LFM2.5-24B-A2B và Gemma 4 26B-A4B đều là checkpoint khoảng 25B tham số, gắn với ngân sách tính toán từ 2–4B tham số hoạt động mỗi token, và cùng nhấn mạnh đánh đổi: bạn trả giá bằng bộ nhớ cho mô hình lớn và bằng độ trễ cho mô hình nhỏ. Điểm khác biệt là cách họ dùng ngân sách: Gemma ưu tiên thị giác và ngữ cảnh 262K, còn LFM2.5 ưu tiên vết suy luận, khung gọi công cụ và học tăng cường dạng tác tử.
Nén trọng số 1-bit: Bonsai 27B trên thiết bị biên so với Qwen3.8-27B từ xa
Trong nhóm mô hình lớn nén lại để phù hợp với AI thiết bị biên, Bonsai 27B 1-bit là ví dụ rõ ràng nhất. Tệp phát hành của nó là 3,803 GB GGUF Q1_0 so với GGUF FP16 của chính mô hình đó ở 53,808 GB, tức tỷ lệ nén khoảng 14,2 lần. Qwen3.8-27B, mô hình dense 27B tham số của Alibaba, nặng 55,59 GB ở định dạng BF16. Lý do khoảng cách kích thước quan trọng là một mô hình 27B với hơn 55 GB trọng số không thể vừa trên laptop 16 GB, card 24 GB ở độ chính xác đầy đủ, hay điện thoại; khi đó Qwen3.8-27B trở thành lệnh gọi API từ xa, còn Bonsai 27B đưa quyết định trở lại phần cứng bạn sở hữu. Nén trọng số 1-bit ở đây nghĩa là trọng số nhị phân {−1, +1} với chia tỷ lệ theo nhóm FP16, đóng gói dưới dạng GGUF Q1_0_g128 ở mức khoảng 1,125 bit hiệu dụng mỗi trọng số, áp dụng từ đầu đến cuối — embeddings, attention, MLP và LM head. Theo dữ liệu nhà cung cấp, so với mức cơ sở FP16 85,07 trên bộ 15 benchmark, Bonsai 27B 1-bit đạt 76,11 tổng thể, giữ lại khoảng 90% chất lượng nhưng mất nhiều điểm hơn ở tuân thủ chỉ dẫn, tác nhân và thị giác.
So sánh hiệu suất mô hình MoE thưa thớt và quyết định mua
Ở lớp MoE thưa thớt khoảng 25B tham số, LFM2.5-24B-A2B và Gemma 4 26B-A4B cho thấy cách phân bổ ngân sách tính toán khác nhau dẫn đến ưu thế khác nhau. Bài đăng ra mắt LFM2.5-24B-A2B đặt Gemma-4-26B-A4B-it vào cột đường cơ sở trong bảng 16 benchmark, cùng với Qwen3.6-35B-A3B và Nemotron-3.5-Lightning, tất cả đều chạy trong vLLM. Các hàng agentic là cuộc thắng áp đảo cho LFM2.5: AutomationBench 27,69 so với 5,46, ToolSandbox 80,71 so với 72,09, LiveClaw 48,09 so với 41,25, τ³-Bench Banking 8,04 so với 4,54, BFCLv4 65,01 so với 57,09. Tuân thủ chỉ dẫn cũng nghiêng về LFM2.5 với IFEval 96,75 so với 92,00, IFBench 74,69 so với 47,44, Multi-IF 84,38 so với 82,19. Ngược lại, Gemma thắng ở PinchBench 83,18 so với 77,12, SWE-Bench Verified qua OpenCode 51,00 so với 25,80, SciCode 35,42 so với 32,71, và AA-Omniscience −24,90 so với −59,39. Cả hai cùng chia sẻ một điểm yếu: một hỗn hợp chuyên gia thưa không làm giảm yêu cầu bộ nhớ, mọi tham số trong checkpoint vẫn phải thường trú; 2,45B hoặc 3,8B active chỉ mang lại thông lượng trên mỗi token, không phải kích thước nhỏ hơn. Nếu workload của bạn là văn bản và tác nhân cần lập kế hoạch, gọi công cụ, tự giải thích, checkpoint LFM2.5-24B-A2B mới hơn là bản nên tải về: 14,5 GB ở Q4_K_M, ngữ cảnh 131K, suy luận tường minh, và bảng benchmark nơi nó thắng các hàng agentic trước đúng đối thủ này. Nếu bất kỳ phần nào trong công việc liên quan đến hình ảnh, hoặc bạn cần ngữ cảnh 256K thay vì 128K, hoặc muốn giấy phép Apache 2.0 không có điều khoản doanh thu phải theo dõi, thì Gemma 4 26B-A4B trả lời một câu hỏi mà LFM2.5-24B-A2B không đặt ra.
- Buy the Dory 1.0 4B if bạn cần mô hình AI nhỏ gọn tiếng Anh, đã SFT + GRPO, chạy suy luận ngay với ngữ cảnh 256K trên hạ tầng hiện có.
- Skip the Dory 1.0 4B if bạn muốn tự thiết kế tác vụ tinh chỉnh chuyên sâu hoặc cần đa ngôn ngữ, khi đó một checkpoint nền như LFM2.5-2.6B-Base phù hợp hơn.
- Buy the LFM2.5-2.6B-Base if bạn có pipeline huấn luyện riêng và muốn mô hình nền 2,6B tối ưu cho tinh chỉnh sâu trên thiết bị biên.
- Skip the LFM2.5-2.6B-Base if bạn chỉ cần mô hình phục vụ ngay, không có tài nguyên để huấn luyện lại, hoặc không muốn xử lý dữ liệu huấn luyện bổ sung.
- Buy the Solar Mini 4 if workload là tác nhân khối lượng lớn, cần mô hình AI nhỏ gọn với kiến trúc MoE thưa thớt, ngữ cảnh 512K và hỗ trợ tiếng Anh, Hàn, Nhật.
- Skip the Solar Mini 4 if bạn cần trọng số mở hoặc mô hình chạy hoàn toàn cục bộ với kích thước nhỏ hơn, vì thiết kế 35B tổng tham số vẫn yêu cầu bộ nhớ đáng kể.
- Buy the Bonsai 27B 1-bit if bạn muốn so sánh hiệu suất mô hình 27B trên AI thiết bị biên, chấp nhận nén trọng số 1-bit để có tệp 3,803 GB thay vì hơn 50 GB.
- Skip the Bonsai 27B 1-bit if bạn cần chất lượng tối đa ở tuân thủ chỉ dẫn, tác nhân và thị giác, nơi nén 1-bit mất nhiều điểm hơn so với FP16.
- Buy the Qwen3.8-27B if bạn chấp nhận chạy từ xa trên accelerator lớn, cần mô hình dense đa phương thức với video và không bị giới hạn bởi kích thước trọng số.
- Skip the Qwen3.8-27B if bạn muốn mô hình 27B chạy cục bộ trên laptop, card 24 GB hoặc điện thoại, vì trọng số BF16 55,59 GB không phù hợp cho môi trường đó.
- Buy the LFM2.5-24B-A2B if workload là văn bản, tác nhân cần lập kế hoạch, gọi công cụ, suy luận tường minh, và bạn ưu tiên hiệu suất agentic trên ngữ cảnh 131K.
- Skip the LFM2.5-24B-A2B if bạn cần xử lý hình ảnh hoặc ngữ cảnh 256K, hoặc muốn giấy phép Apache 2.0, khi đó Gemma 4 26B-A4B là lựa chọn hợp lý hơn.
- Buy the Gemma 4 26B-A4B if bạn cần kiến trúc MoE thưa thớt cân bằng giữa khả năng thị giác, xử lý ngữ cảnh dài 262K và nền tảng kiến thức rộng.
- Skip the Gemma 4 26B-A4B if bạn tối ưu cho tốc độ tác nhân văn bản, không cần thị giác, và muốn mô hình thắng rõ ở các benchmark agentic như LFM2.5-24B-A2B.