
Một nền tảng, sáu hướng chuyên biệt
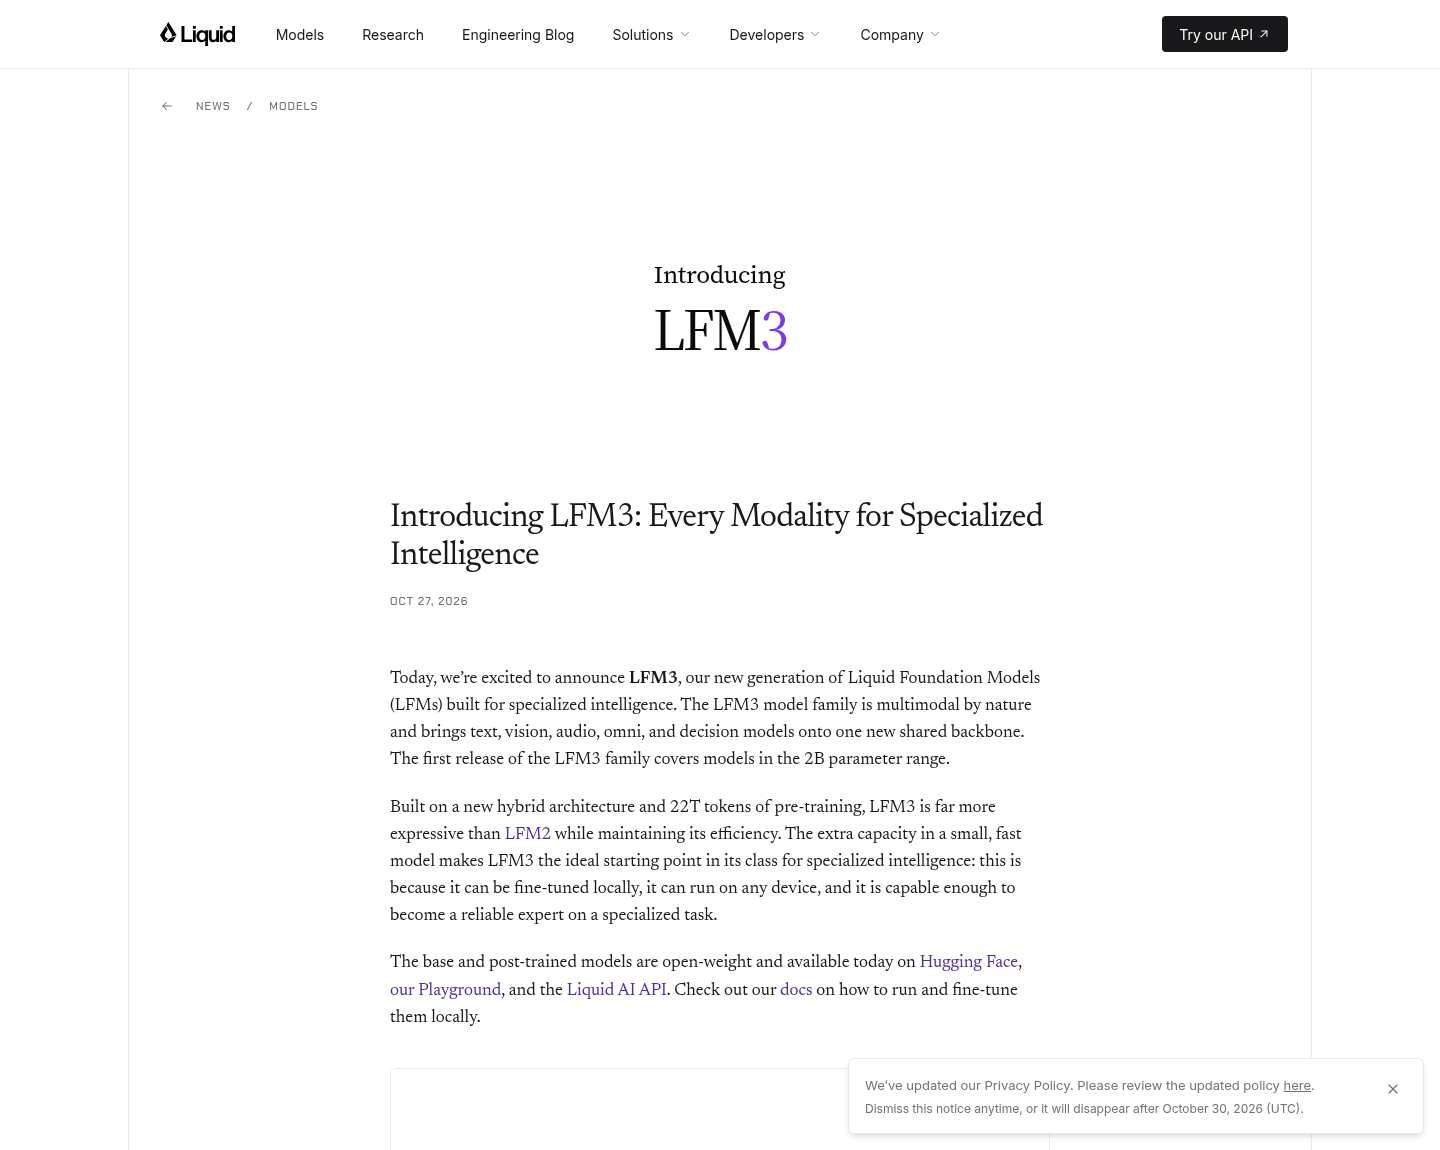
LFM3 là một họ mô hình nền tảng trọng số mở của Liquid AI, ra mắt ngày 27 tháng 10 năm 2026 với sáu phiên bản thuộc lớp 2B, dùng chung nền tảng nhưng được tinh chỉnh cho những kiểu đầu vào và đầu ra khác nhau. Thay vì đặt cược vào một mô hình nhỏ đa năng, Liquid AI chọn hướng “trí tuệ chuyên biệt”: mỗi checkpoint nhắm tới một việc cụ thể, từ xử lý văn bản đến nhận thức đa phương thức và ra quyết định. Cách chia này có lý khi triển khai trên thiết bị, nơi giới hạn bộ nhớ và phần cứng khiến một mô hình lớn duy nhất khó phù hợp với mọi tác vụ.
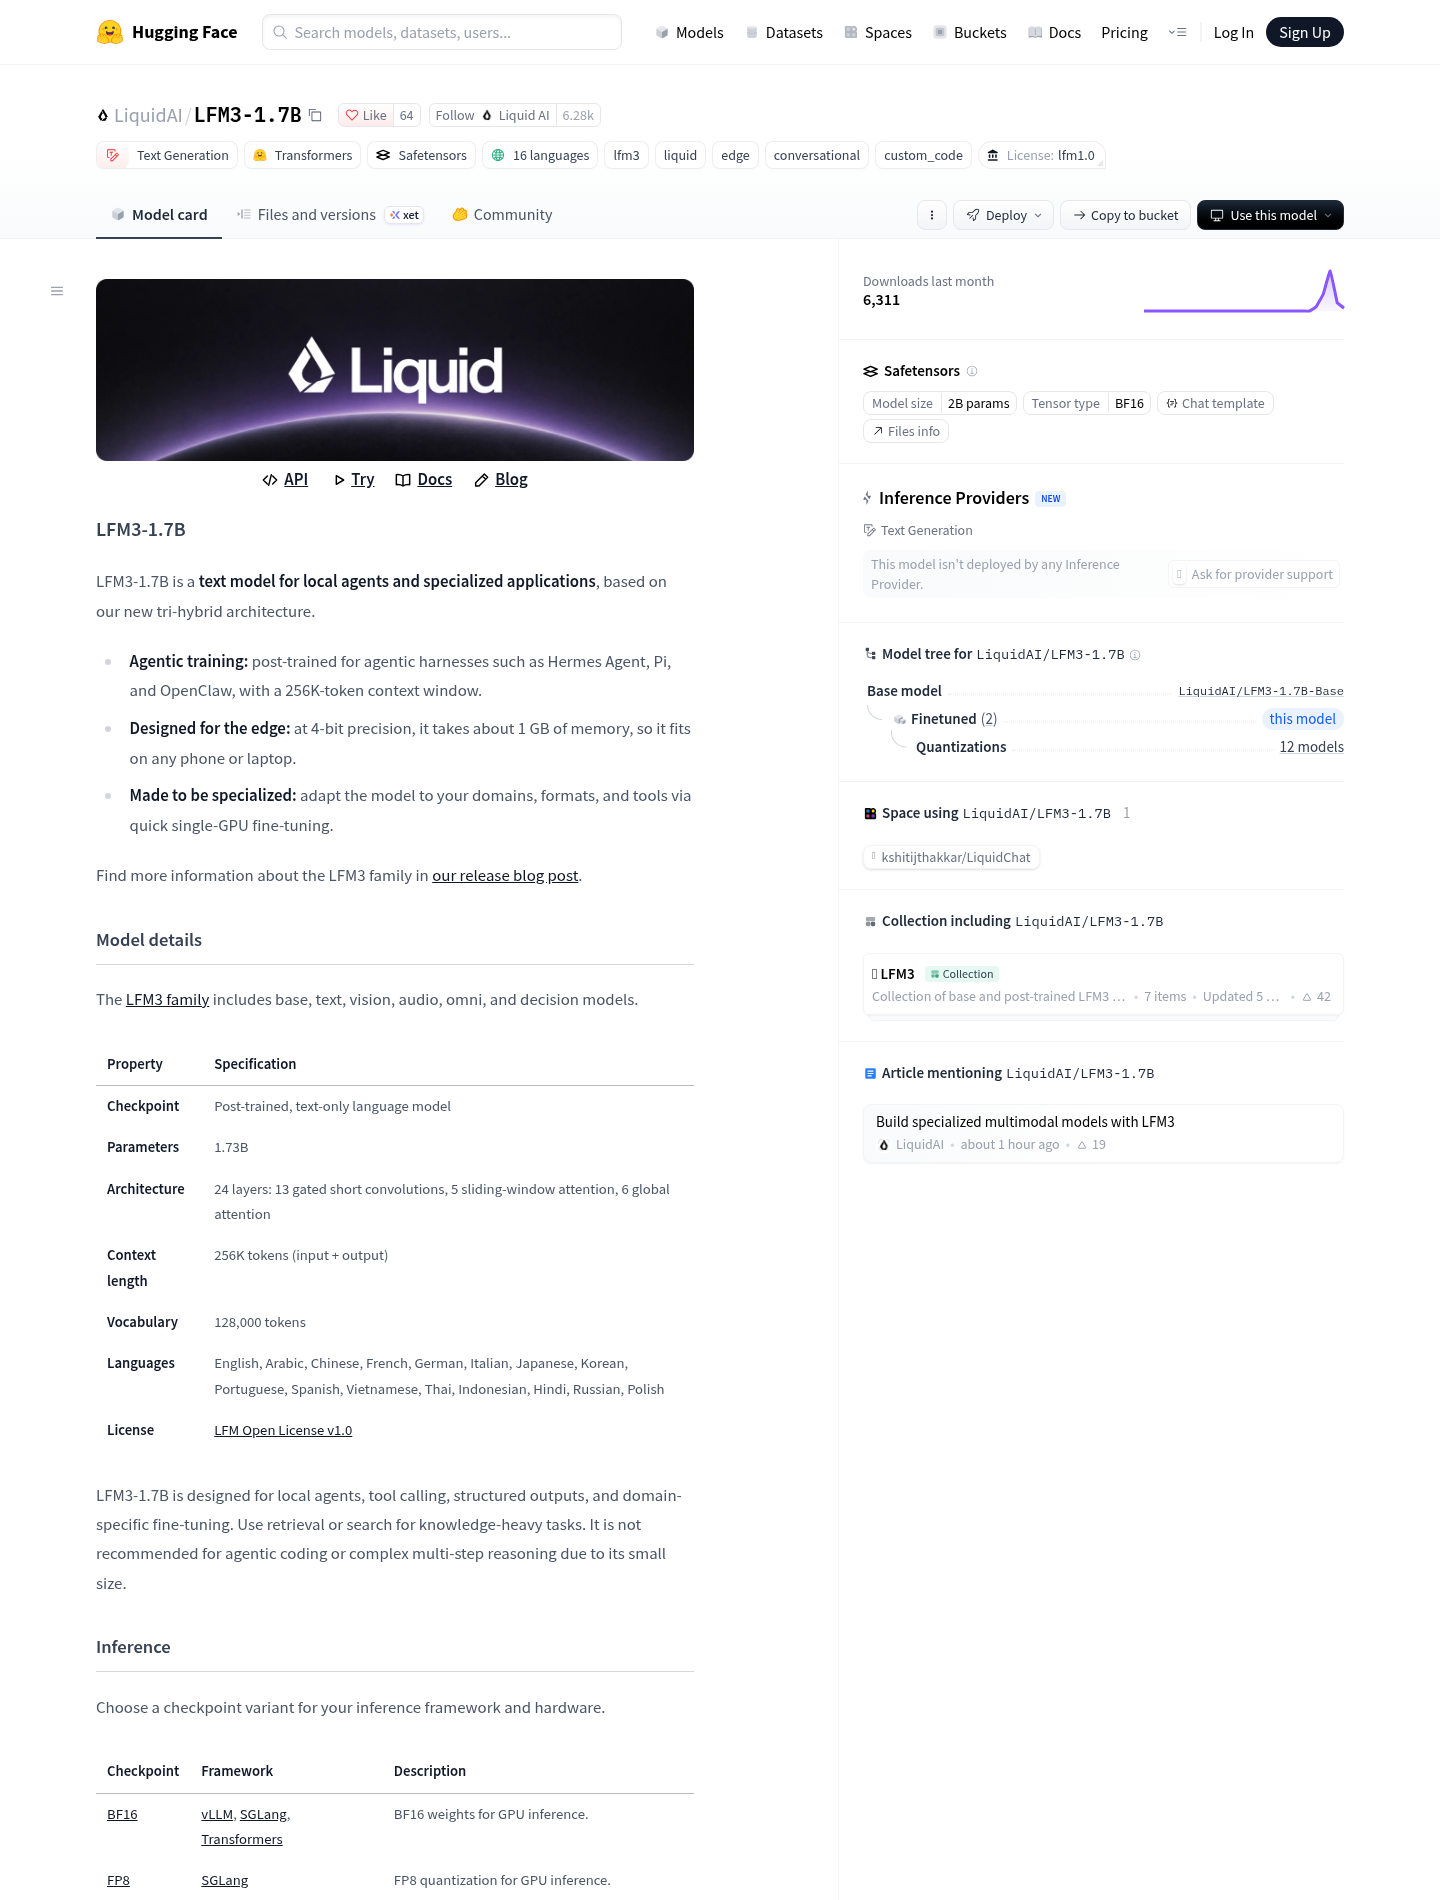
Sáu mô hình đều phát triển từ LFM3-1.7B-Base, nhưng không vì thế mà có cùng năng lực hay cùng giới hạn ngữ cảnh. Mô hình văn bản có 1,73 tỷ tham số, hỗ trợ 16 ngôn ngữ, bộ từ vựng 128.000 token và ngữ cảnh 256K token; các trọng số được phát hành theo giấy phép LFM Open License v1.0. Đây là những thông số đã được công bố cho mô hình văn bản và mô hình cơ sở, không phải lời bảo đảm rằng mọi phiên bản LFM3 đều xử lý được 256K token.
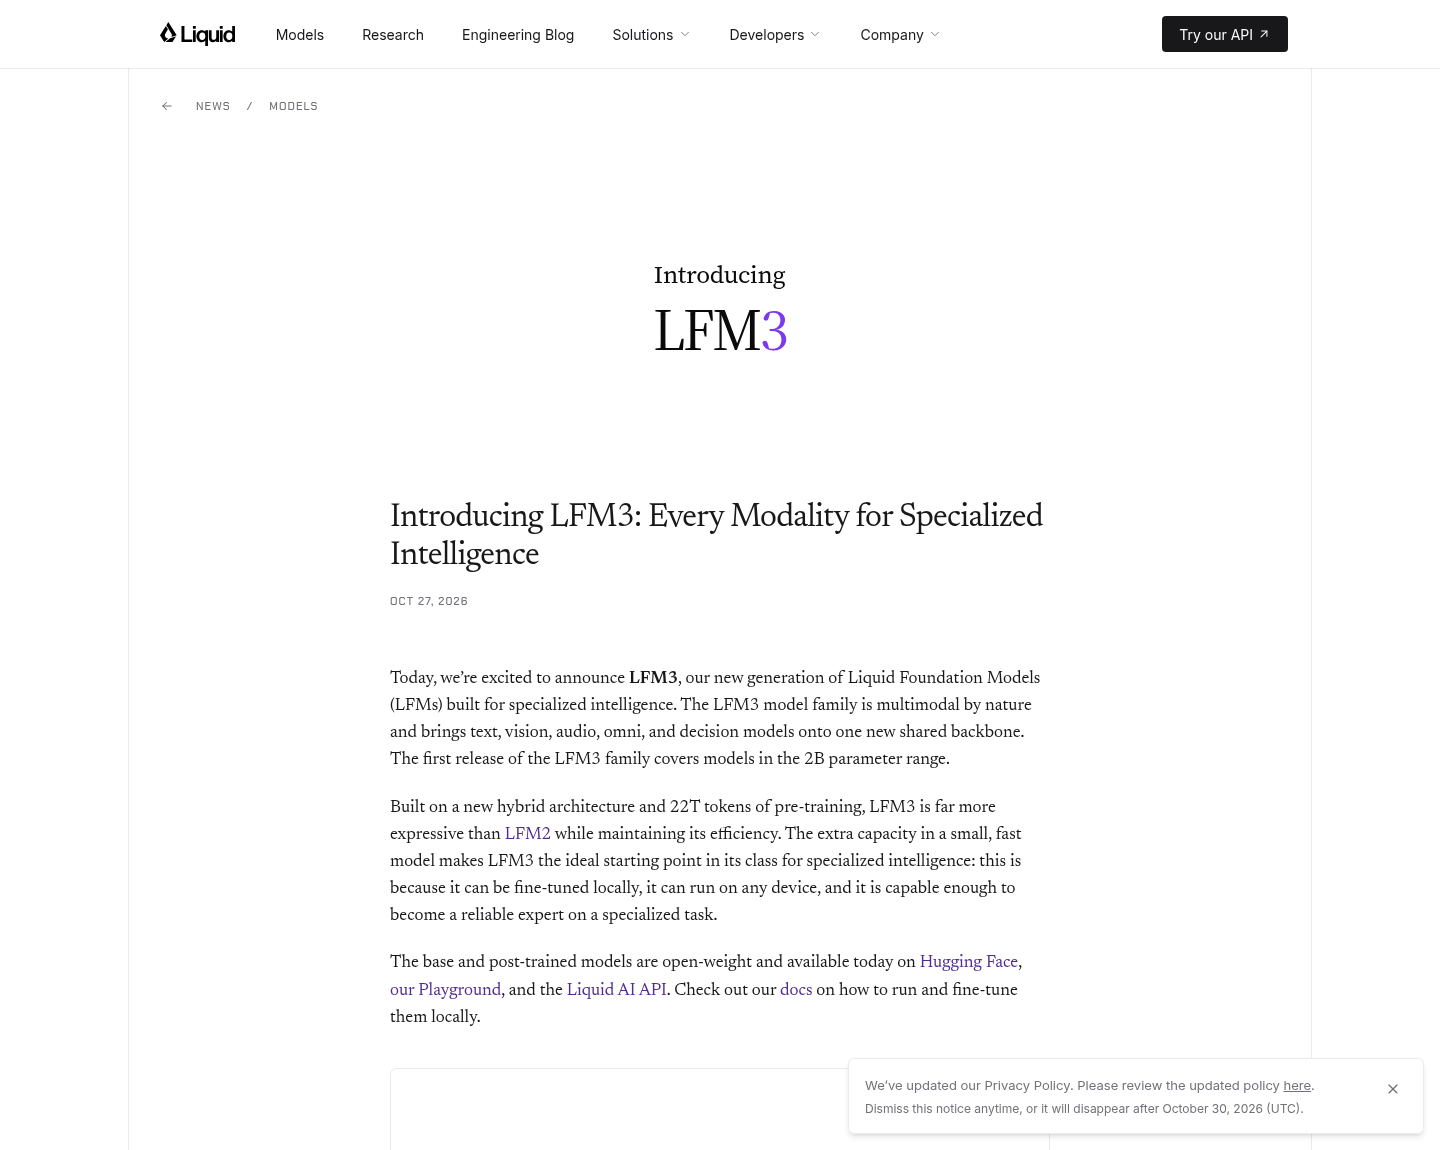
Từ văn bản đến quyết định: dải năng lực của LFM3
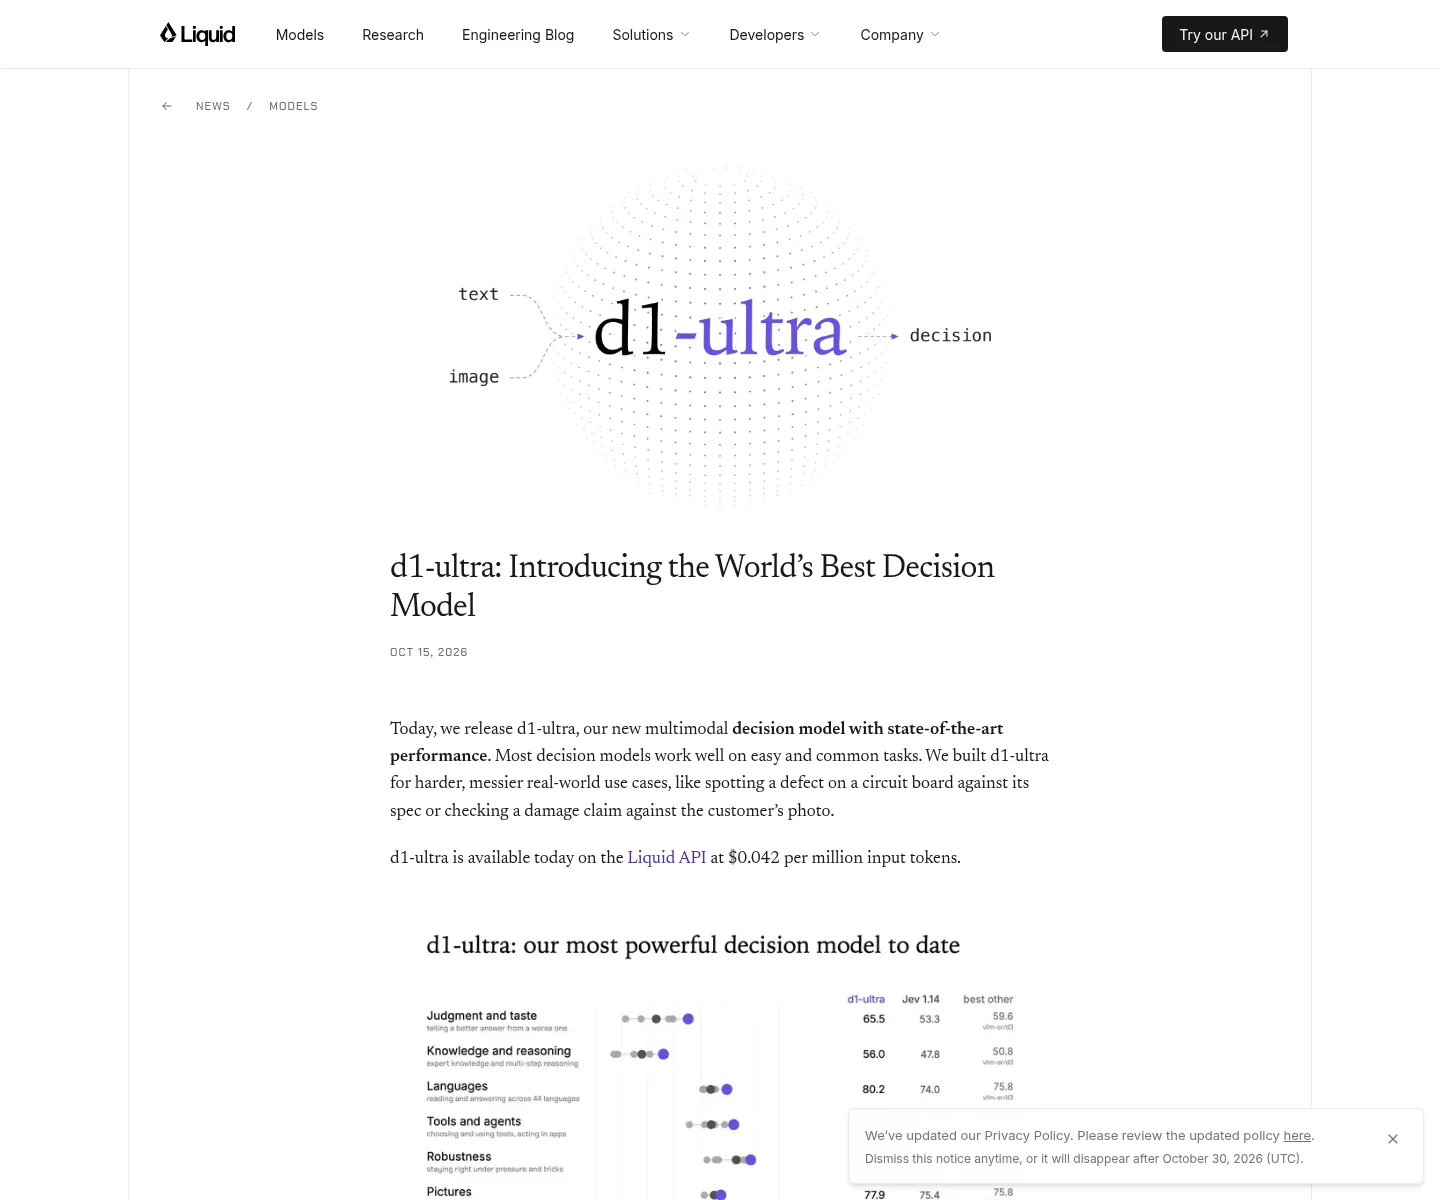
LFM3-1.7B nhận và tạo văn bản; LFM3-VL-2B tiếp nhận văn bản, hình ảnh và video rồi trả lời bằng văn bản. LFM3-Audio-2B xử lý văn bản hoặc âm thanh, phản hồi bằng văn bản hoặc lời nói. LFM3-Omni-2B mở rộng đầu vào sang cả văn bản, hình ảnh, video và âm thanh, đồng thời có thể tạo văn bản lẫn lời nói. Hai nhánh d1-2B và d1-omni-2B đi theo hướng khác: thay vì viết câu trả lời tự do, chúng đưa ra đáp án đã hiệu chuẩn cho các tác vụ ra quyết định.
Điểm đáng chú ý không chỉ là độ rộng phương thức, mà là lựa chọn đầu ra. Với tác vụ cần phân loại hoặc quyết định có cấu trúc, câu trả lời đã hiệu chuẩn có thể phù hợp hơn văn xuôi sinh tự do. Tuy nhiên, mô tả sản phẩm không đồng nghĩa với bằng chứng rằng các mô hình quyết định sẽ đáng tin cậy trong mọi tình huống. Người dùng cần xem tài liệu và đánh giá theo đúng tác vụ của mình, nhất là khi định dùng mô hình để xử lý thông tin quan trọng.
Cũng cần giữ ranh giới rõ về ngữ cảnh: tài liệu Liquid AI công bố 256K cho mô hình văn bản và mô hình cơ sở, nhưng không nêu cửa sổ ngữ cảnh chính thức cho bốn mô hình còn lại. Vì vậy, không nên gán con số 256K cho LFM3-VL, Audio, Omni hay hai mô hình d1 nếu chưa có xác nhận từ nhà phát triển.
Tri-hybrid: chia việc giữa tích chập và attention
Backbone 24 lớp của LFM3-1.7B-Base kết hợp ba kiểu xử lý: 13 lớp tích chập ngắn có cổng, năm lớp attention cửa sổ trượt 256 token và sáu lớp attention toàn cục. Các lớp tích chập dùng kernel 7, tăng từ kernel 3 ở LFM2. Cách phân chia này dành phần lớn cấu trúc cục bộ cho các lớp tích chập, dùng attention cửa sổ trượt để xử lý quan hệ ở khoảng cách vừa, rồi dùng một số lớp attention toàn cục để kết nối thông tin trên toàn ngữ cảnh.
Ba chi tiết bổ sung hoàn thiện thiết kế: cổng sigmoid điều chỉnh đầu ra từng head attention; RoPE một phần chỉ xoay một nửa dải tần cao nhất ở các lớp toàn cục; và chuẩn hóa sandwich chuẩn hóa cả đầu vào lẫn đầu ra mỗi khối. Cửa sổ 256 token ở lớp attention trượt mô tả cách lớp đó nhìn dữ liệu, không phải độ dài ngữ cảnh tổng thể. Đây là điểm dễ bị nhầm: mô hình văn bản được công bố có ngữ cảnh 256K token, dù một thành phần kiến trúc chỉ dùng cửa sổ 256 token.
Thiết kế xuất phát từ quá trình tìm kiếm kiến trúc có phần cứng trong vòng lặp, với mục tiêu chạy trên nhiều loại thiết bị. Liquid AI cho biết mô hình văn bản cần khoảng 1 GB bộ nhớ ở độ chính xác 4-bit; các trọng số và phiên bản sau huấn luyện có trên Hugging Face, Liquid AI Playground và API của hãng. Điều này mở ra khả năng tự triển khai trên phần cứng phù hợp, nhưng dung lượng mô hình không tự động cho biết tốc độ, mức tiêu thụ năng lượng hay chất lượng khi chạy trên từng thiết bị.
Benchmark cần được đọc như tuyên bố, không phải kết luận
Các con số hiệu năng do chính Liquid AI công bố được tạo trên bộ kiểm thử và quy trình đo của hãng; theo tài liệu được cung cấp, chưa có kết quả nào được tái lập độc lập. Chẳng hạn, hãng nói LFM3-1.7B vượt LFM2.5-2.6B dù có ít hơn 35% tham số. Trong một phép đo khác, ở định dạng Q4_0 và ngữ cảnh 32K, hãng tuyên bố mô hình nhanh hơn đối thủ kế tiếp từ 1,8 đến 2,8 lần trên ba thiết bị thử nghiệm. Đây là kết quả đáng quan tâm, nhưng phạm vi thiết bị, cấu hình và cách đo quyết định mức độ có thể so sánh.
Các điểm Terminal-Bench 2.1 ở mức 12,92 và SWE-bench Multilingual ở mức 23,00 cũng không đủ để kết luận rằng mô hình phù hợp cho tác nhân lập trình tự chủ. Thẻ mô hình văn bản còn khuyến cáo không dùng nó cho lập trình agentic hoặc suy luận nhiều bước phức tạp vì quy mô nhỏ. Benchmark hữu ích để hình thành giả thuyết; chúng không thay thế thử nghiệm độc lập trên tác vụ thực tế.
LFM3 là một mô hình trọng số mở đáng chú ý vì kết hợp nhiều chuyên môn với định hướng triển khai trên thiết bị. Liquid AI cũng công bố hướng dẫn tinh chỉnh có giám sát, DPO, GRPO và tiếp tục tiền huấn luyện; hãng cho biết các mô hình có thể được tinh chỉnh trên một GPU. Nhưng giá trị cuối cùng sẽ phụ thuộc vào khả năng chạy, mức phù hợp với dữ liệu và chất lượng đã được kiểm chứng ngoài bộ đo do nhà phát triển tự xây dựng. Lời hứa về AI đa phương thức gọn nhẹ có cơ sở thiết kế; bằng chứng độc lập vẫn là bước cần chờ.